Trzy ustawienia mylą się, gdy właściciel strony mówi “chcę wypaść z AI”. Jedno siedzi w Search Console, drugie w robots.txt pod tokenem Google-Extended, trzecie w robots.txt jako linia Content-Signal. Odpowiadają na różne pytania i żadne z nich nie jest ogólnym wyłącznikiem AI.
Strony Google rysują te granice dość wyraźnie. Kłopot w tym, że rozrzucono je po czterech stronach. Ten wpis zestawia je obok siebie, cytuje każdą tam, gdzie to ma znaczenie, i kończy tabelą wyboru. Wszystkie cytaty sprawdzono 6 października 2026.
wppoland.com to dobry przypadek testowy, bo jest kłopotliwy: sześć podfolderów językowych, każdy zweryfikowany jako osobna usługa z prefiksem URL pod jedną usługą domenową, oraz robots.txt, który już zawiera linię Content-Signal. Wpływu tych przełączników na ruch nie mierzono i nic poniżej go nie twierdzi.
Polskojęzyczny użytkownik Search Console zobaczy te funkcje pod nazwami “Przegląd od AI”, “Tryb AI” i “funkcje oparte na generatywnej AI w Google Discover”. Cytaty z pomocy Search Console i z dokumentacji Google pochodzą poniżej z polskich wersji tych stron, chyba że przy cytacie zaznaczono inaczej.
Które ustawienie Google usuwa moją stronę z Przeglądu od AI i Trybu AI
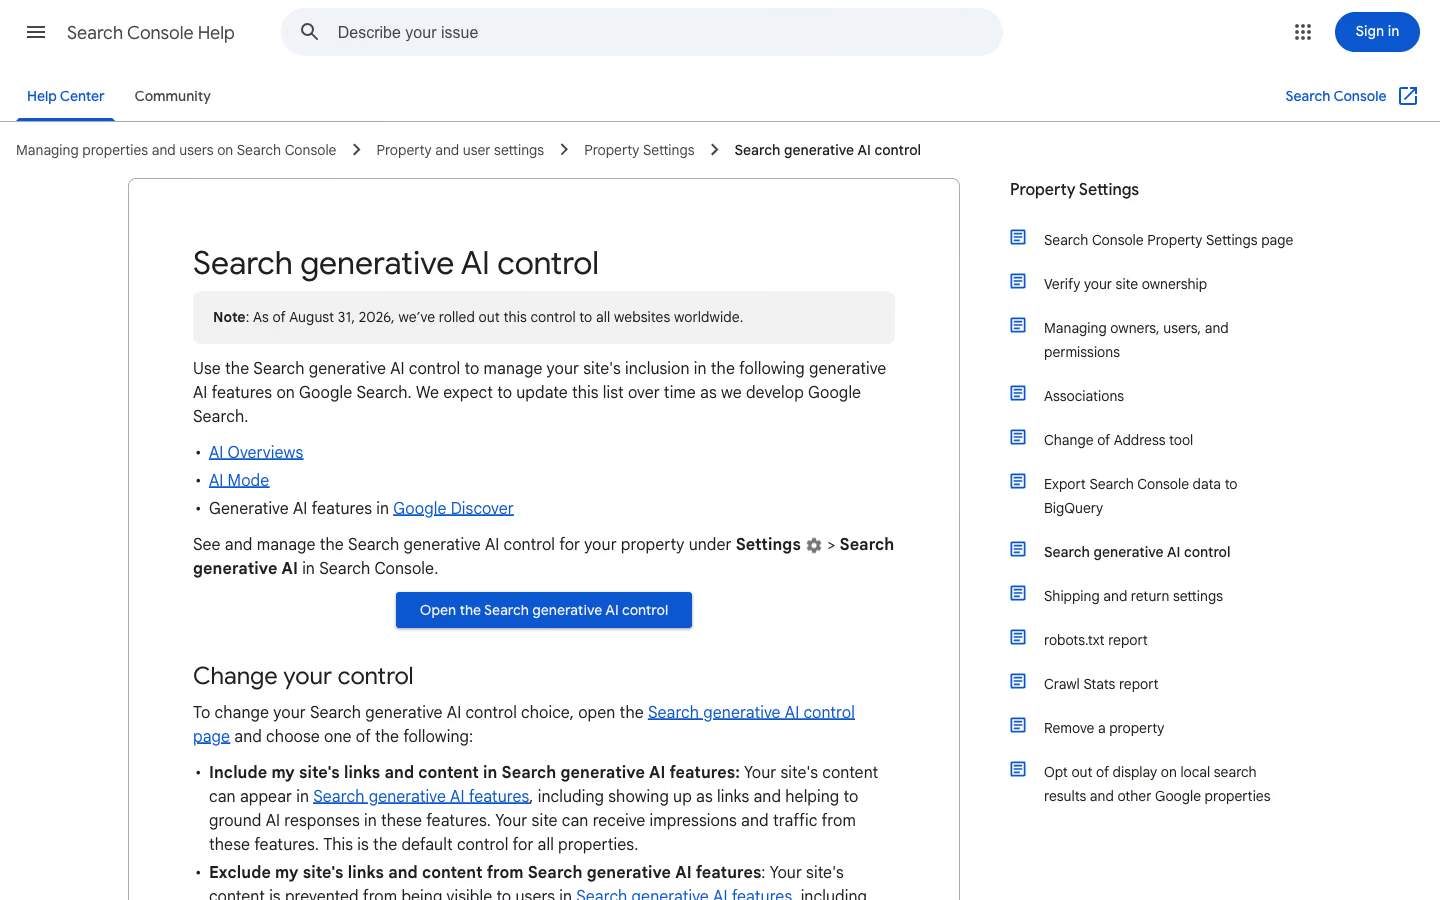
Ustawienia generatywnej AI w wyszukiwarce w Search Console. W polskim interfejsie znajdziesz je w Search Console pod ścieżką “Ustawienia > Generatywna AI w wyszukiwarce”. Strona pomocy wylicza, czym to ustawienie zarządza: Przeglądem od AI, Trybem AI i funkcjami opartymi na generatywnej AI w Google Discover, i zapowiada aktualizowanie tej listy. O wdrożeniu:
“31 sierpnia 2026 r. udostępniliśmy to ustawienie wszystkim witrynom na całym świecie.”
Pomoc Google Search Console, Ustawienia generatywnej AI w wyszukiwarce
Wybierasz między uwzględnieniem, wykluczeniem i dziedziczeniem z usługi nadrzędnej. Uwzględnienie jest ustawieniem domyślnym wszystkich usług, a dziedziczenie domyślnym dla usługi, która ma usługę nadrzędną. Co daje wykluczenie:
“Jeśli wykluczysz swoją witrynę, linki do niej i jej treści nie będą się wyświetlać w funkcjach generatywnej AI w wyszukiwarce. Treści z innych witryn będą nadal dostępne w tych funkcjach i mogą wyglądać podobnie do Twoich. Treści zindeksowane z Twojej witryny nie będą mogły być używane jako dane wejściowe do generowania odpowiedzi lub przeglądu od AI w przypadku funkcji opartych na generatywnej AI w wyszukiwarce.”
Pomoc Google Search Console, Ustawienia generatywnej AI w wyszukiwarce
Dwa szczegóły mają znaczenie. Znikają też linki, nie tylko tekst, więc nie jest to sposób na bycie wspomnianym bez bycia klikniętym. Obejmuje to także dane wejściowe do groundingu, więc wykluczone treści nie służą do budowania odpowiedzi w tych funkcjach.
Google wprost pisze też, czym to ustawienie nie jest:
“To ustawienie wpływa tylko na to, czy Twoje treści mogą pojawiać się w niektórych funkcjach opartych na generatywnej AI w wyszukiwarce. Nie jest ono czynnikiem decydującym o pozycji w rankingu ani o uwzględnieniu treści w innych częściach wyszukiwarki.”
Pomoc Google Search Console, Ustawienia generatywnej AI w wyszukiwarce
“To ustawienie nie ma wpływu na trenowanie AI. Aby ograniczyć trenowanie modeli używanych do generowania odpowiedzi w funkcjach opartych na generatywnej AI w wyszukiwarce, użyj Google-Extended. Aby całkowicie zablokować wyświetlanie treści w wyszukiwarce Google, użyj tagu noindex.”
Pomoc Google Search Console, Ustawienia generatywnej AI w wyszukiwarce
Co do czasu: zmiana zajmuje zwykle kilka dni, treści są wykluczane w ciągu 1-2 dni od wprowadzenia ustawienia, a część później, przez buforowanie i rozpowszechnianie w systemach Google.
Od 21 października 2026 ustawienie widnieje też na stronie Google o kontrolowaniu tego, co udostępniasz wyszukiwarce, jako opcja dla całej witryny, którą zarządzasz obecnością swojej strony w Przeglądzie od AI i w Trybie AI. Dziennik zmian dokumentacji Search Central notuje tę edycję pod 21 października jako dopisanie opcji, które już istniały, więc samo ustawienie się nie zmieniło.
Czy Google-Extended usuwa moją stronę z Przeglądu od AI
Nie. Google-Extended opisano na stronie przeglądu robotów, a obszary produktowe, które ta strona wymienia, to Gemini i Vertex AI, nie wyszukiwarka:
“Google-Extended to samodzielny token usługi, za pomocą którego wydawcy internetowi mogą określać, czy treści z ich witryn indeksowane przez Google mogą być używane do trenowania przyszłych generacji modeli Gemini, na bazie których działają aplikacje Gemini i interfejs Vertex AI API dla Gemini, oraz do groundingu (przekazywania treści z indeksu wyszukiwarki Google do modelu w czasie promptu w celu poprawy rzetelności i trafności) w aplikacjach Gemini i groundingu z użyciem wyszukiwarki Google w Vertex AI.”
“Google-Extended nie ma wpływu na uwzględnienie witryny w wyszukiwarce Google ani nie jest używany jako czynnik decydujący o pozycji w rankingu w wyszukiwarce Google.”
Czytane razem z poprzednią sekcją, obie strony dzielą pracę. Ustawienia wyszukiwarki zarządzają groundingiem i wyświetlaniem w funkcjach wyszukiwarki. Google-Extended zarządza trenowaniem i groundingiem po stronie aplikacji Gemini i Vertex AI. Żadna ze stron nie twierdzi, że obejmuje obszar drugiej, a strona ustawień wyszukiwarki odsyła do Google-Extended w sprawie trenowania.
Z działania tokena wynika jedna praktyczna konsekwencja:
“Google-Extended nie ma osobnego ciągu znaków klienta użytkownika w żądaniu HTTP. Indeksowanie odbywa się z użyciem dotychczasowych ciągów znaków klientów użytkownika Google. Token klienta użytkownika robots.txt jest używany do celów kontrolnych.”
Nasza interpretacja: w logach serwera nie ma linii Google-Extended, której dałoby się szukać, więc grupa w robots.txt to jedyne miejsce, w którym ten wybór istnieje.
Co robi Content-Signal w robots.txt dla Google
Content-Signal to rzecz innego rodzaju. To dyrektywa robots.txt opublikowana przez Cloudflare, z trzema sygnałami. Witryna definiuje ai-input tak:
“Wprowadzanie treści do jednego lub kilku modeli AI (np. generowanie wspomagane wyszukiwaniem, grounding lub inne pobieranie treści w czasie rzeczywistym na potrzeby odpowiedzi generatywnej wyszukiwarki AI).”
contentsignals.org (nasze tłumaczenie angielskiego oryginału)
A ai-train jednym zdaniem:
“Trenowanie lub dostrajanie modeli AI.”
contentsignals.org (nasze tłumaczenie angielskiego oryginału)
Trzeci sygnał, search, dotyczy budowania indeksu wyszukiwarki oraz zwracania linków i krótkich fragmentów, a witryna zaznacza, że “nie obejmuje udostępniania podsumowań wyszukiwania generowanych przez AI”. Ta sama witryna otwarcie mówi o granicach:
“Dyrektywa Content-Signal działa przez zakomunikowanie preferencji: zezwalam (yes) lub nie zezwalam (no) na wybrane kategorie działań AI. Nie wszystkie systemy automatyczne przestrzegają plików robots.txt i niektóre mogą ignorować te dyrektywy Content-Signal.”
contentsignals.org (nasze tłumaczenie angielskiego oryginału)
“Pliki robots.txt wyrażają Twoje preferencje. Nie uniemożliwiają jednak operatorom robotów pobrania Twoich treści na poziomie technicznym.”
contentsignals.org (nasze tłumaczenie angielskiego oryginału)
Jeśli strona stoi za Cloudflare, jest jeszcze czwarty przełącznik, działający na brzegu sieci zamiast w robots.txt. Od 15 września 2026 jego opcja Block zatrzymuje także Googlebota, co opisuję we wpisie czy Cloudflare blokuje Googlebota.
Ani strona pomocy Search Console, ani cytowana tu dokumentacja robotów Google nie wspominają o Content-Signal. Przeszukano tekst obu stron i nie znaleziono ani jednego wystąpienia. To stwierdzenie o tych dwóch stronach, a nie o tym, co robi jakikolwiek system Google. W planowaniu oznacza to, że linia Content-Signal jest deklaracją skierowaną do wszystkich robotów, a nie kontrolką Google. Jak ta linia zachowuje się w grupach robots.txt, opisuje nasz wpis o błędzie zasięgu Content-Signal.
Czy noindex i nosnippet blokują Przegląd od AI
Oba działają, oba są toporne, ale nie w ten sam sposób.
noindex usuwa stronę z wyszukiwarki Google, i właśnie na niego wskazuje strona ustawień generatywnej AI w wyszukiwarce. Koszt jest oczywisty: strona traci też wyniki organiczne.
nosnippet jest węższy, a dokumentacja robots meta Google mówi, że sięga funkcji AI:
“Uniemożliwia wyświetlanie w wynikach wyszukiwania krótkiego fragmentu strony lub podglądu filmu. Miniatura obrazu statycznego (jeśli jest dostępna) może być nadal widoczna, jeśli zwiększa to wygodę użytkowników. Dotyczy to wszystkich form wyników wyszukiwania (w Google: wyszukiwarki, Grafiki Google, kart Discover, przeglądów od AI, trybu AI), a także zapobiega wykorzystywaniu treści jako bezpośredniego źródła danych wejściowych do przeglądów od AI i trybu AI.”
Haczyk tkwi w pierwszym zdaniu. nosnippet odbiera fragment także zwykłym niebieskim linkom i jest ustawiany per strona, więc może kosztować kliknięcia, których ustawienia wyszukiwarki by nie kosztowały. Ta druga część to nasz wniosek z dwóch stron, nie pomiar.
Jest jeszcze jedna pułapka, która dotyka witryn łączących kilka narzędzi. Google pisze:
“Pamiętaj, że aby móc odczytywać ustawienia i ich przestrzegać, roboty muszą mieć dostęp do zawierających je stron.”
Disallow w robots.txt na stronie, która ma noindex albo nosnippet, unieważnia ten tag. Nasz robots.txt zawiera właśnie o tym komentarz dla archiwów taksonomii i dlatego ich nie blokujemy.
Jakie ustawienie AI w Google wybrać do danego celu
| Cel | Przełącznik | Co blokuje | Czego nie blokuje |
|---|---|---|---|
| Poza Przeglądem od AI, Trybem AI i funkcjami generatywnymi w Discover, ale nadal w wyszukiwarce | Ustawienia generatywnej AI w wyszukiwarce ustawione na wykluczenie | Linki i treści w tych funkcjach, dane wejściowe do groundingu dla nich, ruch i wyświetlenia z nich | Trenowania AI, reszty wyszukiwarki, rankingu, udziału w Merchant Center i Google Ads |
| Poza trenowaniem Gemini i groundingiem Gemini, ale nadal w wyszukiwarce i w Przeglądzie od AI | Google-Extended z Disallow w robots.txt | Wykorzystania indeksowanych treści do trenowania przyszłych modeli Gemini i do groundingu w aplikacjach Gemini i Vertex AI | Uwzględnienia w wyszukiwarce Google, rankingu i tego, czym zarządzają ustawienia wyszukiwarki |
| Poinformować wszystkie roboty o polityce w jednym miejscu | Linia Content-Signal w każdej grupie robots.txt | Technicznie niczego | Niczego. To deklaracja, a strony Google jej nie wymieniają |
| Bez tekstu AI z wybranych stron, strona nadal na liście | nosnippet | Fragmentu tekstu i podglądu filmu wszędzie, w tym jako bezpośrednich danych wejściowych do Przeglądu od AI i Trybu AI | Samego wpisu strony, ewentualnie statycznej miniatury; przycina też zwykłe fragmenty |
| Całkowicie poza wyszukiwarką Google | noindex | Strony w wynikach wyszukiwarki Google | Nie dotyczy, strona znika z wyników; robot nadal musi móc pobrać stronę, żeby zobaczyć tag |
Dwa cele z początku wpisu przekładają się tak. Poza Przeglądem od AI, ale nie poza wyszukiwarką: ustawienia wyszukiwarki albo nosnippet na pojedynczych stronach. Poza trenowaniem, ale nie poza odpowiedziami AI: Google-Extended dla Google, linia Content-Signal dla reszty, a ustawienia wyszukiwarki zostają na uwzględnieniu.
Co się dzieje, gdy podfolder językowy nadpisuje usługę domenową
Dziedziczenie to miejsce, w którym witryna z wieloma usługami spotyka niespodzianka. Reguła Google:
“Domyślnie usługa dziedziczy ustawienia generatywnej AI w wyszukiwarce z najbliższej usługi nadrzędnej, w której zmieniono ustawienia, aby zatrzymać dziedziczenie.”
Pomoc Google Search Console, Ustawienia generatywnej AI w wyszukiwarce
W przypadku wppoland.com usługa domenowa jest na szczycie, a każdy z folderów /pl/, /en/, /de/, /nb/, /pt-pt/ i /es/ to usługa podrzędna. Ustawiasz usługę domenową raz i wszystkie sześć za nią idzie. Ponieważ każdy folder jest osobną usługą, jeden język można też wykluczyć, a pozostałe pięć zostawić z uwzględnieniem. Google mówi to o usługach podrzędnych:
“Właściciele usługi podrzędnej mogą wybrać ustawienia generatywnej AI w wyszukiwarce pochodzące z usługi nadrzędnej lub zmienić je w przypadku konkretnej usługi podrzędnej i jej podstron.”
Pomoc Google Search Console, Ustawienia generatywnej AI w wyszukiwarce
Nowość to powiadomienie. Barry Schwartz zgłosił 6 października 2026, że Google dopisał linię do strony pomocy, a ta linia brzmi:
“Właściciele usługi domeny najwyższego poziomu zobaczą powiadomienie na stronie ustawień generatywnej AI w wyszukiwarce, gdy jedna z ich usług podrzędnych nadpisze ustawienie nadrzędne.”
Pomoc Google Search Console, za Search Engine Roundtable (nasze tłumaczenie angielskiego oryginału)
To przydatne, bo właśnie tak osoba będąca właścicielem usługi domenowej dowie się, że ktoś zmienił ustawienie dla jednego folderu, bez otwierania sześciu stron. Nie widzieliśmy, żeby powiadomienie się pojawiło. Schwartz pisze, że on również nie ma jego zrzutu ekranu, więc traktuj je jako udokumentowane, a nie zaobserwowane.
Przykład robots.txt z Content-Signal i Google-Extended
Grupa z gwiazdką i grupa Google-Extended w public/robots.txt brzmią dokładnie tak:
User-agent: *
Content-Signal: search=yes, ai-input=yes, ai-train=no
Allow: /
Disallow: /cdn-cgi/
# Google-Extended - Gemini grounding + training corpus
User-agent: Google-Extended
Content-Signal: search=yes, ai-input=yes, ai-train=no
Allow: /Dwa wnioski. Po pierwsze, zestaw odpowiada temu, czego chcemy: w wyszukiwarce, w odpowiedziach AI, poza trenowaniem. Oznacza to też, że ustawienia wyszukiwarki i plik muszą się zmieniać razem. robots.txt z ai-input=yes i ustawienie w Search Console na wykluczenie przeczyłyby sobie nawzajem.
Po drugie, grupa Google-Extended to słabsza połowa. Google dokumentuje ten token przez linie allow i disallow, a jego własny przykład używa obu. Nasza grupa mówi Allow: /. Czytając dosłownie według strony Google, token jest otwarty dla trenowania Gemini i groundingu na naszej witrynie, a stojące obok ai-train=no to stwierdzenie, którego żadna z cytowanych tu stron Google nie wymienia. Dla samego Google nasza preferencja dotycząca trenowania jest więc zadeklarowana, ale nie niesie jej mechanizm, który Google dokumentuje.
Zamknięcie tej luki to osobna decyzja. Disallow: / w tej grupie oznaczałoby też rezygnację z groundingu w aplikacjach Gemini, bo token obejmuje oba zastosowania. Komentarz na początku pliku nazywa też każde ograniczenie wyrażone przez sygnały treści wyraźnym zastrzeżeniem praw na podstawie art. 4 dyrektywy o prawie autorskim 2019/790. Czy to się obroni, to pytanie do prawnika, nie do osoby edytującej robots.txt.
Jak zmierzyć efekt przed zmianą ustawienia
Wyniku nie ma, a kolejność ma znaczenie. Google wskazuje w tym celu raport:
“Aby zmierzyć skuteczność treści w funkcjach opartych na generatywnej AI w wyszukiwarce, użyj raportu skuteczności generatywnej AI. Dzięki temu możesz sprawdzić, jak zmiana ustawienia może wpłynąć na ruch w Twojej witrynie.”
Pomoc Google Search Console, Ustawienia generatywnej AI w wyszukiwarce
Plan jest krótki. Najpierw zapisz raport dla usługi domenowej. Zmień jedną usługę i nic więcej. Odczekaj dni, które podaje Google. Porównaj z punktem wyjścia. Zmiana ustawień wyszukiwarki, Google-Extended i wdrożenie nosnippet w tym samym tygodniu dałyby liczbę, której nikt nie potrafi przypisać. Ta sama dyscyplina dotyczy wzorca zero kliknięć opisanego w naszym wpisie o rozszerzonym Przeglądzie od AI, a powody, dla których w ogóle zależy nam na cytowaniu w odpowiedziach, są w strategicznym podsumowaniu LLMO.
Aktualizacja, . Pierwsze publiczne dane z wyłączenia AI, jakie widziałem, przemawiają przeciw typowej obawie. Cyrus Shepard opisał na LinkedInie test, który sam nazywa niewielkim studium przypadku: jedna strona wyłączona z funkcji AI w Google. W samym wpisie nie podaje, jakim mechanizmem to zrobił; Barry’emu Schwartzowi opisał go jako ustawienia wyłączenia z generatywnej AI w wyszukiwarce (Search Engine Roundtable). Wyświetlenia w funkcjach AI spadły do zera. Według jego szacunku te wyświetlenia miały CTR około 0,9%, policzony z ogólnego CTR i wyświetleń strony po odjęciu znanych wyświetleń AI w okresie testu. Schwartzowi powiedział też, że stanowiły około 8% wszystkich wyświetleń. Zaskoczenie: w czasie wyłączenia spadły także zwykłe kliknięcia organiczne. Shepard tłumaczy to efektem aureoli, czyli tym, że obecność w większej liczbie miejsc na stronie wyników zwiększa szansę na kliknięcie. Sam zastrzega, że wyniki nie są gwarantowane i każdy powinien sprawdzić własne dane. Ograniczenia pochodzą od niego i trzeba je czytać razem z liczbami: jedna strona, brak dat i długości testu we wpisie, a Przegląd od AI przez cały czas pojawiał się przy tych zapytaniach, tylko bez jego strony.
Co z tego wynika dla strony na WordPressie: jedna strona nie dowodzi efektu aureoli, ale podważa założenie, że wyłączenie funkcji AI może tylko chronić kliknięcia. Na stronie wielojęzycznej opisane wyżej dziedziczenie daje zgrubny test: wyklucz jedną usługę językową, resztę zostaw na uwzględnieniu i porównaj każdą z jej własnym punktem wyjścia. Zgrubny, bo każdy język to inny rynek. Strona w jednym języku takiego podziału nie ma, więc decyzja dotyczy od razu całej witryny.
Czy Bing ma osobne ustawienia dla trenowania AI i odpowiedzi AI
Aktualizacja, . Ma, od dziś. Krishna Madhavan z Microsoft Bing ogłosił preferencje, które rozdzielają trenowanie AI od groundingu, czyli użycia strony do zbudowania wygenerowanej odpowiedzi (blog Bing, Your content, your choice). Microsoft zapewnia, że żadna z nich nie zmienia kwalifikacji do zwykłych wyników wyszukiwania Bing.
Trenowanie AI ustawiasz w robots.txt, dla całej strony albo ścieżki, osobnym tokenem user-agent. Domyślnie jest zgoda, więc jeśli nie masz nic przeciwko, nic nie zmieniasz. Żeby się wypisać:
User-Agent: __usage_ai-training
Disallow: /
Na poziomie pojedynczej strony meta tag albo nagłówek HTTP ma pierwszeństwo przed robots.txt:
<meta name="Bingbot" content="ai-training:disallow">
X-Robots-Tag: Bingbot: ai-training:disallow
Grounding ustawia się tylko per strona, w robots.txt nie ma go wcale. Są trzy wartości: zgoda (domyślna), ai-grounding:disallow, która wyłącza stronę z wygenerowanych odpowiedzi, oraz ai-grounding:disallowextended, która zostawia grounding w usługach prowadzonych przez sam Microsoft, w tym w Copilocie i Microsoft 365, a wyłącza usługi groundingu, które Microsoft udostępnia innym firmom, na przykład Web IQ i grounding w Foundry API. Obie wartości trafiają do tego samego meta tagu Bingbot albo nagłówka X-Robots-Tag.
Ważniejsze od składni są daty. Nowe preferencje zastępują dotychczasowe dyrektywy NoArchive i NoCache. Od 15 grudnia 2026 Bing Webmaster Tools udostępni tymczasowe ustawienia groundingu stronom, które tego dnia używają NoArchive albo NoCache. Od 1 lutego 2027 Bing respektuje nowe preferencje w miarę ponownego indeksowania. 1 marca 2027 mija termin na opublikowanie ustawień groundingu na stronach albo zapisanie tymczasowych; strona bez jednego i drugiego dostaje domyślną zgodę na grounding do czasu ponownego pobrania, a NoArchive i NoCache przestają się liczyć dla trenowania i groundingu. Tymczasowe ustawienia wygasają 30 września 2027 albo wcześniej, gdy Bing przy ponownym pobraniu znajdzie nowy tag.
| Cel | Bing | |
|---|---|---|
| Poza trenowaniem AI, cała strona | Google-Extended z Disallow w robots.txt, co wyłącza też grounding w Gemini Apps i Vertex AI | __usage_ai-training z Disallow w robots.txt, tylko trenowanie |
| Poza odpowiedziami AI w wyszukiwarce | Ustawienia generatywnej AI w wyszukiwarce dla usługi w Search Console albo nosnippet na stronie | ai-grounding:disallow na stronie, meta tag lub nagłówek |
| Poza groundingiem dla firm trzecich | Brak odpowiednika | ai-grounding:disallowextended na stronie |
| Zwykły wynik wyszukiwania | Bez wpływu ustawień wyszukiwarki i Google-Extended | Bez wpływu obu preferencji |
Praktyczna różnica: Google wiąże trenowanie z groundingiem Gemini w jednym tokenie, Bing je rozdziela. Zestaw deklarowany w naszym robots.txt (w odpowiedziach, poza trenowaniem) da się przekazać Bingowi jedną grupą; w Google kosztuje to również grounding Gemini. Za to przełącznik groundingu w Bingu działa per strona, a główny przełącznik Google per usługa.
Co postanowić teraz na stronie z WordPressem:
- Sprawdź, czy twoje strony wysyłają
noarchivealbonocache. Część wtyczek SEO, choćby Rank Math, ma noarchive w zaawansowanych ustawieniach meta robots. Jeśli tym ograniczałeś Binga, 1 marca 2027 przestanie to działać, chyba że zastąpisz to nowymi ustawieniami. - Trenowanie: dopisz grupę
__usage_ai-trainingdo robots.txt. WordPress serwuje wirtualny robots.txt; edytujesz go w edytorze robots.txt wtyczki SEO (mają go Yoast i Rank Math) albo filtremrobots_txt. Fizyczny plik robots.txt w katalogu głównym całkowicie zastępuje wirtualny. - Grounding: Bing czyta
<meta name="Bingbot">, a niename="robots", więc filtrwp_robotsz rdzenia go nie wypisze. Dodaj go hookiemwp_headw małej wtyczce albo wyślij nagłówek z serwera. Jeśli chcesz być cytowany w Copilocie, nic nie rób: zgoda jest domyślna. - Przy liczbach Sheparda o blokadzie groundingu decyduj osobno dla każdej sekcji, na przykład tylko dla treści płatnych.
Grupę Binga dla trenowania dodałem już do robots.txt wppoland.com, zgodnie z sygnałem ai-train=no. Ustawienie tych preferencji per szablon na stronie z WordPressem robię w ramach optymalizacji GEO i LLMO.
Lista kontrolna
- Najpierw ustal cel: poza funkcjami wyszukiwarki, poza trenowaniem albo jedno i drugie.
- Wybierz przełącznik z tabeli. Jeden cel, jeden przełącznik.
- Ustaw ustawienia wyszukiwarki na usłudze domenowej, a potem sprawdź każdą usługę językową pod kątem nadpisania.
- Utrzymuj spójność robots.txt i Search Console:
ai-input=yesi wykluczona usługa przeczą sobie. - Nie łącz
Disalloww robots.txt znoindexaninosnippetna tej samej stronie. - Używaj Google-Extended tylko wtedy, gdy akceptujesz, że obejmuje też grounding Gemini.
- Zapisz raport skuteczności generatywnej AI przed zmianą i zmieniaj jedną rzecz naraz.
- Jeśli strona ogranicza Binga przez
noarchivealbonocache, zastąp je nowymi preferencjami Binga przed 1 marca 2027.