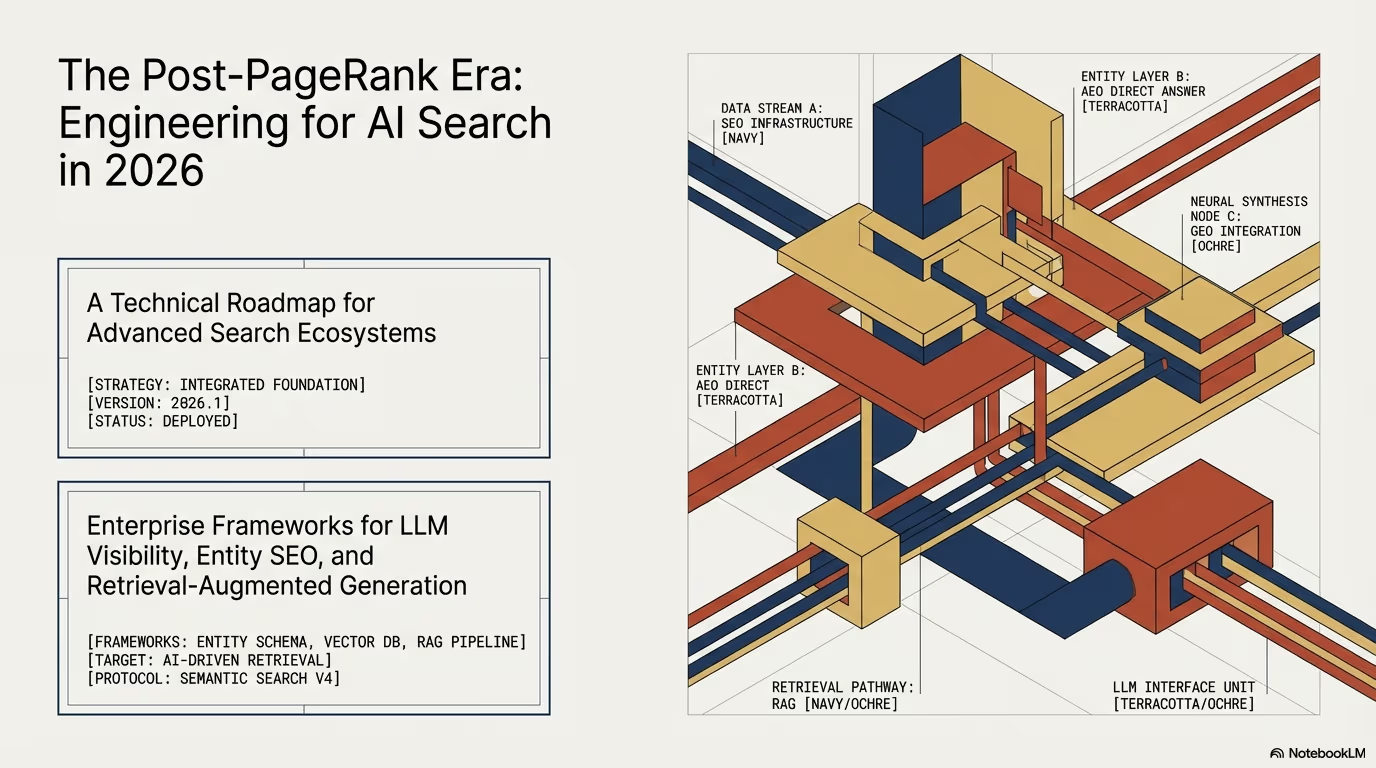
LLMO (Large Language Model Optimization) to praktyka przygotowania treści i technicznego frontu strony pod modele językowe: ChatGPT, Claude, Gemini, Perplexity i agentów, które budują odpowiedzi z retrievalu. To nie zastąpienie SEO. To drugi tor widoczności: cytowanie, poprawne zrozumienie encji i obecność w indeksach RAG.
W 2026 użytkownicy coraz częściej dostają gotową odpowiedź zamiast listy dziesięciu niebieskich linków. Jeśli Twoja strona nie jest czytelna dla modelu (mętna teza, brak autora, sprzeczne fakty, schema tylko „dla ozdoby”), model albo Cię pominie, albo zniekształci. LLMO to praca nad tym, żeby być źródłem, nie szumem.
Czym jest llmo?
SEO optymalizuje widoczność w wyszukiwarkach. LLMO optymalizuje szansę, że asystent AI:
- zacytuje Twoją treść z atrybucją,
- poprawnie zmapuje Twoje encje (firma, osoba, produkt, usługa),
- uzna stronę za wiarygodne źródło przy pytaniach w Twojej niszy.
Przykład z praktyki WordPress / agencji w Polsce: artykuł o migracji WooCommerce z konkretnymi progami TTFB, nazwanymi pluginami i datą weryfikacji ma większą szansę wejść do odpowiedzi Perplexity niż generyczny tekst „migracja jest ważna i należy planować”. Modele lubią fakty, strukturę i proweniencję.
Dlaczego to ma znaczenie teraz
Trzy zmiany w ekosystemie:
- Odpowiedzi zamiast klików. Część zapytań kończy się w panelu AI Overview / chat, bez wizyty na stronie. Cytowanie i brand mention stają się KPI obok organicznego CTR.
- RAG i indeksy zewnętrzne. Narzędzia typu Perplexity i korporacyjne knowledge base zaciągają fragmenty stron. Jeśli Twój HTML jest ścianą tekstu bez nagłówków, chunking psuje sens.
- Halucynacje kosztują reputację. Gdy model „domyśla się” Twojej oferty, klient dostaje złą informację. Jasne fakty, FAQ i schema zmniejszają pole do fantazji.
LLMO nie gwarantuje cytowań. Zmniejsza tarcia techniczne i redakcyjne, które gwarantują, że Cię nie da się zacytować poprawnie.
Kluczowe elementy llmo
1. Strukturalne dane (schema.org)
Modele i crawlers AI lepiej trawią treść, gdy masz jawne @type, autora z sameAs i daty. Minimalny, sensowny szkielet artykułu:
{
  "@context": "https://schema.org",
  "@type": "Article",
  "headline": "LLMO - strategiczne podsumowanie",
  "datePublished": "2025-01-15",
  "dateModified": "2026-09-20",
  "author": {
    "@type": "Person",
    "name": "Mariusz Szatkowski",
    "sameAs": [
      "https://www.wikidata.org/wiki/Q115564437"
    ]
  },
  "publisher": {
    "@type": "Organization",
    "name": "WPPoland"
  }
}
W WordPressie nie wklejaj JSON-LD „na ślepo” w każdym poście, jeśli motyw lub SEO-plugin już emituje Article. Duplikaty @graph mylą walidatory i czasem boty. Audyt: jedna kanoniczna ścieżka schema na typ treści.
2. Plik llms.txt
Propozycja standardu informującego boty AI o mapie serwisu (analogia mentalna do robots.txt, ale pod LLM, nie pod classical crawl budget):
## WPPoland
> Praktyczne przewodniki WordPress, WooCommerce i wydajność.

## Sekcje
- /pl/blog/ - artykuły edukacyjne
- /pl/portfolio/ - case studies
- /pl/kontakt/ - kontakt

## Unikaj
- /pl/cennik/ szkice wewnętrzne (jeśli niedostępne)
llms.txt nie zastępuje robots.txt ani sitemapy. To wskazówka dla systemów, które chcą czytać strukturę, zanim zassają cały HTML. Trzymaj go w rootcie, aktualizuj przy większych zmianach IA serwisu.
3. Jasna struktura treści
- Nagłówki H2–H4 w logicznej hierarchii (bez skoku z H2 od razu do H4 „bo ładniej”).
- Definicja terminu przed użyciem skrótu.
- Teza na początku akapitu (BLUF), dowód potem.
- Tabele porównawcze zamiast lanych akapitów „z jednej strony… z drugiej…”.
- FAQ z realnymi pytaniami klientów, nie z listą pod keyword stuffing.
Chunking w RAG często tnie po nagłówkach i długości. Jeśli H2 jest o migracji, a w środku nagle lecisz w historię firmy bez podziału, model dostaje śmieciowy fragment.
4. E-E-A-T (doświadczenie, ekspertyza, autorytet, zaufanie)
Dla LLMO to nie slogan Google’a, tylko sygnały, które modele i ich warstwy retrievalu lubią wzmacniać:
- Biogramy autorów z linkami do profili (
sameAs: LinkedIn, GitHub, Wikidata gdy ma sens). - Cytowania źródeł przy twierdzeniach mierzalnych.
- Widoczne
datePublished/dateModified(i realna aktualizacja, nie tylko flip daty). - Case’y z konkretami (stack, ograniczenie, wynik), nie „pomogliśmy klientowi X zwiększyć sprzedaż”.
W treściach YMYL (finansowe, medyczne, prawne) brak autora i daty to zaproszenie do pominięcia.
Różnice między SEO a llmo
| Aspekt | SEO | LLMO |
|---|---|---|
| Cel | Pozycja i klik w Google | Cytowanie / użycie w odpowiedzi AI |
| Słowa kluczowe | Nadal istotne w zapytaniach | Kontekst, encje, jawne definicje |
| Linki | Autorytet domeny | sameAs, cytowania, spójność encji |
| Treść | Pod użytkownika w SERP | Pod użytkownika i pod maszynę (chunkowalność) |
| Schema | Rich results | Maszynowa tożsamość autora i artykułu |
| Aktualność | Freshness sygnał | Modele unikają przeterminowanych faktów |
Praktyczna konsekwencja: możesz mieć top 3 na frazę i zero cytowań w chatach, jeśli treść jest cienka, bez źródeł i bez czytelnej tezy. I odwrotnie: mocny przewodnik techniczny z tabelami i datą weryfikacji bywa cytowany mimo przeciętnej pozycji na „główne” keyword.
Fundamenty techniczne (WordPress)
LLMO pada, gdy bot nie może przeczytać treści.
- SSR / czysty HTML. Treść kluczowa nie może istnieć tylko po hydracji JS. Gutenberg i klasyczne tematy zwykle są OK; ciężkie page buildery z client-only blokami bywają problemem.
- Crawl budget i robots. Nie blokuj GPTBot / Google-Extended „bo tak”, jeśli chcesz być w indeksach AI. Decyzja polityczna i biznesowa; świadoma, nie domyślna.
- Canonical i hreflang. Sześć locale z rozjechanym canonicalem to sześć sprzecznych sygnałów encji.
- Wydajność. Wolny TTFB nie jest „LLMO ranking factor”, ale crawler timeout i porzucony fetch są. Core Web Vitals nadal się liczą pośrednio.
- Sitemap + lastmod uczciwy. Fałszywy lastmod uczy systemy nie ufać Twoim datom.
Jak zacząć (kolejność na 30 dni)
- Wybierz 5–10 filarowych URL-i (nie cały blog naraz).
- Dopisz BLUF i definicje na górze; dodaj tabelę lub FAQ tam, gdzie dziś jest lawina zdań.
- Uporządkuj schema Article + Person; usuń duplikaty.
- Dodaj
/llms.txtz mapą sekcji. - Zaktualizuj daty tylko tam, gdzie treść faktycznie przeszła review.
- Zmierz bazę: ręczne zapytania w Perplexity / ChatGPT Browse pod Twoje frazy brand + nisza; zapisz czy jesteś cytowany.
Nie zaczynaj od „plugin LLMO”. Zaczynaj od czytelności i tożsamości.
Czego unikać
- Keyword stuffing pod „LLM” w każdym H2.
- Generycznych biogramów „pasjonat digitalu”.
- Masowego przepisywania całych katalogów przez model bez redakcji (ślad AI-slop, sprzeczne fakty).
- Ukrytego tekstu i cloakingu „dla botów AI” (to nadal spam).
- Obietnic „gwarantowane cytowanie w ChatGPT” - nikt uczciwy tego nie sprzedaje.
Jak mierzyć efekt (bez magicznych KPI)
Nie masz oficjalnego „LLMO rank trackera” od OpenAI. Mierz to, co da się powtórzyć:
- Ręczny panel zapytań. 20–40 fraz: brand + nisza + „jak zrobić X w WordPress”. Co miesiąc: czy jesteś cytowany, z jakim URL-em, czy fakt jest poprawny.
- Logi botów. Porównaj hit rate GPTBot / Google-Extended / PerplexityBot przed i po odblokowaniu (jeśli świadomie wpuszczasz).
- Jakość chunków. Weź 3 filary, podepnij prosty skrypt dzielący po H2; czytaj fragmenty jak model. Jeśli akapit bez nagłówka miesza trzy tematy, popraw strukturę.
- Schema regress. Po deployu waliduj JSON-LD (Rich Results / własny parser). Duplikat Article to regresja LLMO tak samo jak SEO.
Zapisuj wynik w ticketcie, nie w głowie. Po kwartale widać, które filary weszły do odpowiedzi, a które nadal są niewidoczne mimo ruchu z Google.
Lokalny kontekst (PL)
Na rynku polskim LLMO często wpada w trzy pułapki: (1) cienkie tłumaczenia 1:1 z EN bez lokalnych przykładów, (2) brak NIP / KRS / pełnych danych firmy w stopce przy treściach B2B, (3) daty „zaktualizowano dziś” przy niezmienionej treści. Modele i ludzie to widzą. Lepiej jeden rzetelnie odświeżony przewodnik o WooCommerce + ERP niż dwadzieścia generycznych stubów.
Dla agencji: uzgodnij z klientem politykę botów AI pisemnie. Marketing chce cytowań; prawnik chce blokady. Świadomy kompromis w robots.txt jest lepszy niż domyślne „Disallow: /” skopiowane z forów.
Podsumowanie
LLMO nie zastępuje SEO - uzupełnia je. W 2026 robisz oba: klasyczną widoczność w wyszukiwarce i cytowalność w warstwie odpowiedzi AI. Zacznij od filarów, schema, struktury i uczciwych dat. Reszta to iteracja na podstawie tego, czy modele w ogóle Cię widzą.
Jeśli chcesz uporządkować ten obszar w projekcie WordPress (schema, treść filarowa, llms.txt, audyt cytowań), zobacz usługi optymalizacji SEO i widoczności albo napisz przez kontakt.