Joost de Valk opublikował 27 września 2026 r. tekst o tym, że prawie nikt nie robi sitemap XML poprawnie. Przejrzał wtyczką Sitemap Inspector sześć serwisów, od Adobe po GOV.UK, i w każdym znalazł to samo: adresy z noindex, przekierowania, 404, kanoniczne wskazujące gdzie indziej, jedną datę na setki wpisów. Jego teza brzmi: „Mapa witryny powinna zawierać adresy URL, które witryna chce mieć zaindeksowane, i nic więcej.” (tłumaczenie własne)
Zgadzamy się z tezą i z listą. Sprawdziliśmy nią własny serwis. Między sierpniem a październikiem 2026 r. znaleźliśmy w generatorze sitemap wppoland.com pięć błędów, każdy zmierzony na produkcji. Trzy z nich lista Joosta by złapała. Dwóch nie złapie żaden inspektor, który czyta wpisy sitemapy, bo polegały na tym, czego w niej nie było. Ten tekst jest o obu rodzajach.
Kontekst techniczny: wppoland.com to serwis Astro w sześciu językach, około 6700 adresów w sitemapach. Sitemapy generuje własna integracja astro-sitemaps.mjs, nie wtyczka. To ważne dla wniosków: każdy z błędów poniżej siedział w kodzie, który czyta dane i buduje listę, a nie w samej liście.
Dlaczego lastmod w sitemapie pokazuje datę builda
24 sierpnia 2026 r. pięć różnych sitemap miało dokładnie jedną wartość lastmod na wszystkie wpisy, tę samą, dzisiejszą. Integracja liczyła new Date() raz i stemplowała nią 3079 adresów. Każde wdrożenie ogłaszało Google, że zmieniło się wszystko.
Google opisuje warunek wprost: używa <lastmod>, jeśli wartość jest „consistently and verifiably” zgodna z ostatnią zmianą strony (Google Search Central, strona o budowie sitemap, aktualizacja z 8 lipca 2026 r.). Data, która skacze przy każdym buildzie, tego warunku nie spełnia, więc Google przestaje jej ufać dla całej domeny, także tam, gdzie byłaby prawdziwa. W próbkach z tamtego okresu ostatni crawl niektórych stron sięgał od trzech tygodni do trzech miesięcy wstecz.
Naprawa podstawiła updatedDate z frontmattera, w razie braku pubDate. Efekt na artefakcie: polska sitemapa bloga przeszła z 1 na 98 różnych dat.
Przy tej naprawie łatwo o błąd drugiego rzędu. Kuszące było podstawienie pola lastVerified dla stron miast, bo ma je każdy z 4733 plików. Tyle że 4697 z 4733 plików ma w nim tę samą wartość. To zbiorczy stempel, nie sygnał, i przeniósłby ten sam defekt z „dzisiaj” na inną stałą datę. Zanim jakiekolwiek pole daty trafi do lastmod, trzeba policzyć, ile ma różnych wartości.
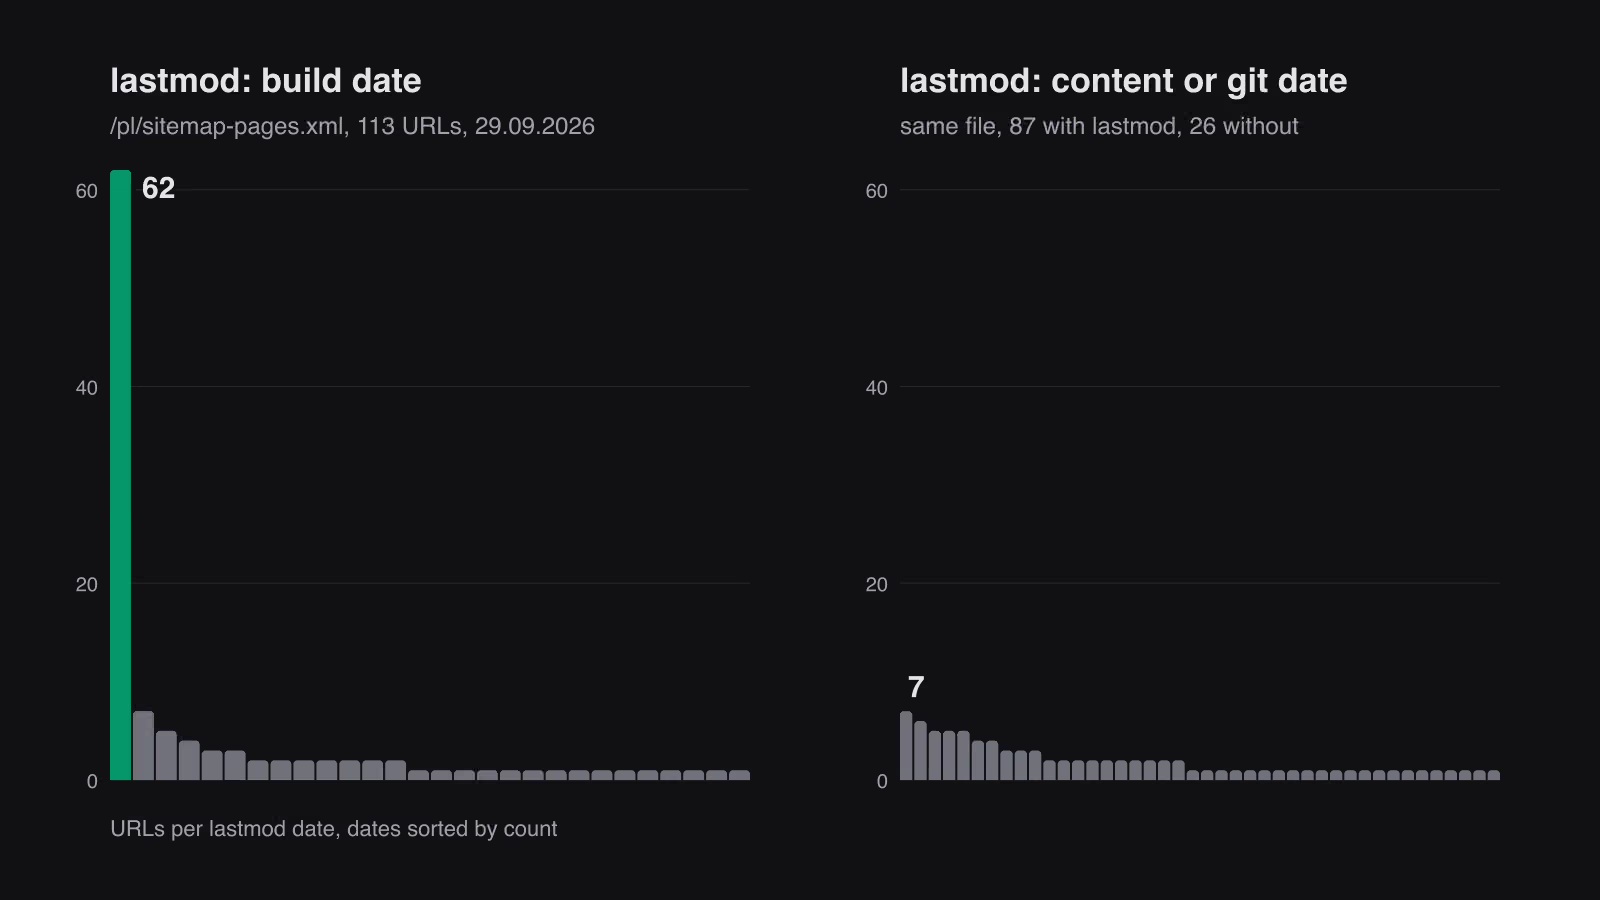
Naprawa z sierpnia objęła blog, portfolio i strony z kolekcji treści. Nie objęła ręcznie pisanych tras .astro. Artykuł Joosta skłonił nas do ponownego sprawdzenia: 29 września w /pl/sitemap-pages.xml 62 z 113 adresów nadal miało jako lastmod datę builda, bo nie istnieje dla nich data w treści, a kod spadał wtedy na today. Poprawka (commit af97c7a887) bierze dla takich tras datę ostatniego commita pliku źródłowego z jednego wywołania git log na build, a gdy i tej nie ma, pomija lastmod. Wspólny szablon [lang]/[slug].astro świadomie nie liczy się jako źródło, bo jego data nic nie mówi o żadnej konkretnej stronie. Ten sam plik po poprawce: 87 z 113 adresów ma lastmod, 42 różne daty, najczęstsza przypada na 7 adresów, a 26 adresów nie ma daty wcale. W polskiej sitemapie stron miast przed poprawką 684 z 692 wpisów miało datę builda, po niej 8 wpisów ma prawdziwą datę: szablon miast nie ma daty, której dałoby się uczciwie użyć, więc reszta daty nie deklaruje. Poprawka jest na produkcji od 29 września 2026 r., a żywy plik pokazuje te same liczby.
Dlaczego strony noindex trafiają do alternatyw hreflang w sitemapie
Po obniżeniu 723 stron miast do noindex Search Console dalej zgłaszał je jako odkryte. Same strony miały poprawny noindex. Wracały do Google inną drogą: sitemap-locations.xml wymieniała je jako alternatywy językowe (xhtml:link, także x-default) stron, które zostały w indeksie.
Filtr noindex w integracji sprawdzał tylko <loc>. Alternatywy pochodzą z nagłówka strony, który wymienia wszystkie wersje językowe, więc filtr ich nie widział. Poprawka zostawia tylko te alternatywy, których adres sam jest <loc> w sitemapie. Po niej build dawał 6407 adresów i 0 błędnych alternatyw.
Wniosek wykracza poza sitemapy: filtr na jednym polu wpisu nie obejmuje pozostałych pól tego wpisu, które niosą adres. W sitemapie takich miejsc jest kilka: loc, alternatywy, x-default, image:loc.
Dlaczego w sitemapie brakuje indeksowalnych stron
21 września 2026 r. integracja zaczęła pomijać każdy adres pasujący do prefiksów, które middleware w functions/_middleware.ts przekierowuje. Tylko że middleware przekierowuje je wyłącznie wtedy, gdy zasób zwraca 404, a każdy kandydat do sitemapy jest zbudowaną stroną, więc nigdy nie zwraca 404. Filtr skopiował regułę bez jej warunku.
Wynik: 500 działających stron z index, follow wypadło z sitemapy, łącznie z celem jednego z przekierowań (/pl/audyt-bezpieczenstwa-wordpress/ pasował do prefiksu audyt-bezpieczenstwa-). Poprawka weszła 26 września, build z sitemapą dał +500 adresów i 0 usuniętych.
Tego błędu nie złapie żadna kontrola wpisów. Każdy z pozostałych adresów był poprawny: renderował się, nie miał noindex, nie przekierowywał. Mniej adresów w sitemapie wygląda jak porządki, a nie jak defekt. Wykryć to można tylko porównaniem zbioru adresów przed zmianą i po niej.
Błędy image:loc w mapie strony XML
Integracja wyciągała heroImage z frontmattera wyrażeniem regularnym, linia po linii. Przy bloku składanym YAML (heroImage: >-) wartość stoi w następnej linii, więc regex łapał dosłowne >-. Sitemapa dostawała wpisy <image:loc>https://wppoland.com/>-</image:loc>.
17 września 2026 r. na produkcji było 31 takich wpisów w sześciu językach. Search Console pokazywał pięć błędów na pl/sitemap-blog.xml, a sam XML był poprawnie zbudowany i każdy <loc> był w porządku. YAML w plikach też był poprawny. Zepsuty był czytający.
Poprawka parsuje frontmatter parserem YAML, a funkcję wyciągającą metadane wyeksportowaliśmy z integracji, żeby test mógł jej dosięgnąć bez pełnego builda. Wcześniej siedziała w środku 900-liniowego pliku i żaden test nie miał do niej dostępu.
Jakie adresy wysyłać do IndexNow
Skrypt do IndexNow budował adresy z nazw plików w src/content/. 17 września 2026 r. generował 2328 adresów, z których 0 występowało w sitemapie. Wpisy bloga dostawały segment /blog/, którego w adresach nie ma, a strony zachowywały sufiks języka z nazwy pliku (/de/about.de/). Oba warianty zwracały 301. Do tego wzorzec plików łapał tylko .md, więc 100 filarów usługowych w .mdx nie było wysyłanych nigdy.
Poprawka jest jednym zdaniem: źródłem adresów do IndexNow jest sitemap-index.xml. Ten zbiór jest już sprawdzony: strony renderują się i nie mają noindex. Heurystyka z nazw plików zniknęła razem z trzema klasami błędów.
Google nie pobiera sitemapy w Search Console
Ten przypadek nie był defektem generatora, ale należy do tej samej rodziny. Na początku września 2026 r. po odblokowaniu stron miast sześć sitemap lokalizacji liczyło 4071 adresów. Wszystko po naszej stronie było poprawne: próbki zwracały 200 i index, follow, żaden adres z sitemapy nie był noindex ani przekierowaniem.
Search Console ostatni raz pobrał te sitemapy 1 września o 10:08, gdy miały 2037 adresów, i przez pięć dni ich nie odświeżył. Sitemapy bloga czytał codziennie. Wszystko dodane po tej godzinie dla Google nie istniało. Ponowne przesłanie przez API zostało pobrane tego samego dnia.
W kolejnym tygodniu liczba stron miast z wyświetleniami wzrosła z 223 do 343, a ich wyświetlenia z 1570 do 4382. Te 343 strony to 8,4 procent z 4071 i w siedem dni dały 2 kliknięcia. Odblokowane zostało odkrycie, nie ruch, i to są dwie różne liczby.
Błędy sitemapy, których walidator nie wykryje
| Błąd | Jak wyglądał w sitemapie | Czy wykryje go kontrola wpisów | Co go wykryło |
|---|---|---|---|
| Data builda jako lastmod | wszystkie wpisy z jedną datą | tak, jako powtarzający się lastmod | liczba różnych dat w pliku |
| Alternatywy obok noindex | poprawne <loc>, błędne xhtml:link | częściowo, jeśli sprawdza alternatywy | raport Search Console o noindex |
| 500 stron poza sitemapą | każdy obecny wpis poprawny | nie | porównanie zbioru adresów przed i po |
>- jako obrazek | 31 błędnych image:loc | tak, jeśli sprawdza obrazki | błędy sitemap w Search Console |
| IndexNow spoza sitemapy | sitemapa poprawna | nie, błąd poza sitemapą | przecięcie listy wysyłki z sitemapą |
| Sitemapa niepobrana | plik poprawny i aktualny | nie | data pobrania w Search Console |
Wtyczka taka jak ta, której użył Joost, odpowiada na pytanie „czy to, co jest w sitemapie, jest poprawne”. To dobre pytanie i większość serwisów, jak pokazał, na nie nie odpowiada. Ale trzy z sześciu naszych przypadków dotyczyły czego innego: czego w sitemapie nie ma, co z niej korzysta i którą wersję widzi Google.
Co oznaczają statusy mapy witryny w Search Console
Raport „Mapy witryn” w Search Console pokazuje dla każdego przesłanego pliku jeden z trzech statusów, a strona pomocy Google do tego raportu definiuje każdy z nich. Sukces oznacza, że mapa witryny została pobrana i odczytana bez błędów. Nie udało się pobrać oznacza, że Google w ogóle nie dostał pliku. W witrynie wystąpiły błędy: X oznacza, że plik pobrano i odczytano tylko częściowo; adresy, które dało się odczytać, i tak trafiają do kolejki indeksowania. Nasz przypadek z image:loc był w ostatniej kategorii: sitemapa została odczytana, pięć wpisów odrzucono, reszta przeszła.
Ta sama strona wymienia przyczyny statusu „Nie udało się pobrać”: plik zablokowany w robots.txt, nierozwiązane ręczne działanie wobec witryny, adres zwracający 404, ogólny błąd serwera albo niskie zapotrzebowanie na indeksowanie samej sitemapy. Po nieudanym pobraniu Google ponawia próby przez kilka dni, a potem przestaje. Sitemapę, która była zepsuta przez tydzień, trzeba więc po naprawie przesłać ponownie.
Cztery błędy parsowania z tej listy biorą się z generatora, a nie z treści. URL not allowed oznacza adres powyżej katalogu sitemapy albo w innej domenie lub protokole. Path mismatch oznacza, że host sitemapy i jej adresy różnią się co do www. Invalid URL obejmuje błędnie zbudowane albo nieescapowane znaki. Incorrect sitemap index format zgłasza indeks, który wymienia inny indeks.
Jeden szczegół zmienia sposób sprzątania: usunięcie sitemapy w raporcie usuwa ją tylko z raportu. Google nie zapomina ani sitemapy, ani adresów, które zawierała. Żeby pobierania ustały, plik musi zniknąć z serwera albo odpowiadać nagłówkiem noindex.
Zasady protokołu sitemap, które łamią generatory
Protokół na sitemaps.org jest krótki, a generator, który go ignoruje, tworzy pliki wyglądające w przeglądarce całkiem poprawnie. Plik musi być w UTF-8. Każda wartość, łącznie z adresami, musi zamieniać pięć znaków na encje: & na &, ' na ', " na ", > na > i < na <. Jeden parametr zapytania z gołym & robi z całego pliku niepoprawny XML i tak pojedynczy adres zamienia się w Search Console w błąd parsowania.
Każdy <loc> musi być pełnym adresem zaczynającym się od protokołu. Położenie pliku ogranicza to, co może zawierać: sitemapa pod daną ścieżką może wymieniać adresy z tej ścieżki i niższych, a sitemapa na jednym hoście nie może wymieniać adresów z subdomeny. Limity to 50 000 adresów i 50 MB (52 428 800 bajtów) bez kompresji na jedną sitemapę oraz 50 000 sitemap w jednym pliku indeksu. <lastmod> używa formatu W3C Datetime, w którym sama data RRRR-MM-DD jest poprawna.
26 czerwca 2023 r. Google wycofał endpoint ping dla sitemap i zapowiedział, że po sześciu miesiącach przestanie on działać. Zapytania do niego zwracają teraz 404; według Google stary kod, który go wywołuje, nie szkodzi, ale też nic nie robi. Sitemapy zgłasza się linią Sitemap: w robots.txt albo w Search Console. W tym samym wpisie Google zdefiniował lastmod jako datę „ostatniej istotnej zmiany” (tłumaczenie własne): zmiana w pasku bocznym albo stopce się nie liczy, zmiana głównego tekstu, danych strukturalnych albo linków już tak. Google pisze też, że można pominąć lastmod dla stron takich jak strona główna czy strony kategorii, przy których oprogramowanie nie potrafi ustalić, kiedy naprawdę się zmieniły. Nasza druga poprawka lastmod działa dokładnie według tej zasady.
Co rdzeń WordPressa umieszcza w wp-sitemap.xml
Od WordPressa 5.5 rdzeń generuje sitemapy bez wtyczki. Zapowiedź na make.wordpress.org opisuje ustawienia domyślne: indeks leży pod /wp-sitemap.xml, obejmuje publiczne i publicznie odpytywalne typy treści i taksonomie, archiwa autorów oraz stronę główną, a jedna sitemapa mieści najwyżej 2000 wpisów. Ten limit zmienia filtr wp_sitemaps_max_urls. WordPress dopisuje też indeks do robots.txt, który sam serwuje.
Trzy ustawienia domyślne tłumaczą większość pytań. Rdzeń nie zapisuje lastmod, tylko sam adres; filtr wp_sitemaps_posts_entry pozwala dodać datę do każdego wpisu. Gdy w Ustawienia, Czytanie zaznaczona jest opcja „Proś wyszukiwarki o nieindeksowanie tej witryny”, sitemapy rdzenia są wyłączone, więc serwis uruchomiony z kopii stagingowej z wciąż zaznaczonym polem nie ma sitemapy rdzenia wcale. Całą funkcję wyłącza filtr wp_sitemaps_enabled, a zawęża ją wp_sitemaps_post_types, wp_sitemaps_taxonomies, wp_sitemaps_add_provider (na przykład żeby usunąć sitemapy użytkowników) i wp_sitemaps_posts_query_args dla pojedynczych wpisów.
Wtyczki SEO zwykle zastępują sitemapę rdzenia. W komentarzach pod zapowiedzią Pascal Birchler, współtwórca rdzenia, potwierdził, że Yoast SEO wyłącza sitemapę rdzenia na rzecz własnej. Zanim zaczniesz debugować sitemapę WordPressa, ustal, który indeks serwis faktycznie serwuje, i tylko ten zgłoś w Search Console.
Jak sprawdzić generator mapy strony XML
Kontrola wpisów jest warunkiem koniecznym, nie wystarczającym. Te pięć punktów sprawdza generator, a nie sam plik:
- Policz różne wartości
lastmodw każdym pliku. Jedna wartość na setki wpisów oznacza stempel, nie datę. To samo przed podstawieniem nowego pola daty: jeśli prawie wszystkie pliki mają w nim tę samą wartość, pole nie nadaje się nalastmod. Braklastmodjest lepszy niż nieprawdziwy. - Porównuj zbiór adresów przed zmianą generatora i po niej. Liczba dodanych i usuniętych adresów, z listą. Spadek liczby adresów wymaga wyjaśnienia tak samo jak wzrost.
- Każde pole niosące adres podlega tym samym filtrom.
loc, alternatywy językowe,x-default,image:loc. Filtr na jednym z nich nie chroni pozostałych. - Reguła skopiowana z innego komponentu przychodzi razem ze swoim warunkiem. Przekierowanie „gdy 404” to nie to samo co przekierowanie zawsze.
- Sitemapa jest jedynym źródłem adresów dla wszystkiego, co wysyła adresy dalej: IndexNow, Indexing API, listy do ręcznego zgłoszenia. I raz na tydzień: data ostatniego pobrania w Search Console i liczba adresów, którą tam widać, obok liczby
<loc>w żywym pliku.
Dwie rzeczy z dokumentacji Google, które warto mieć pod ręką: jeden plik sitemapy mieści najwyżej 50 000 adresów lub 50 MB bez kompresji, a wartości <priority> i <changefreq> są ignorowane. Nie szkodzą, ale nie warto nad nimi pracować.
Jeśli serwis działa jako headless WordPress, dochodzi pytanie, kto w ogóle generuje sitemapę, front czy WordPress. Opisaliśmy to osobno w tekście o sitemapie i kanonicznym adresie w headless WordPress.