W 2012 roku, żeby dodać stronę do Google, wypełniałeś formularz addurl.html i czekałeś.

W 2026 roku masz trzy realne narzędzia: raport pokrycia w Search Console, URL Inspection oraz - w wąskim, oficjalnie udokumentowanym zakresie - Indexing API. Do tego dochodzi sitemap XML jako kanał odkrywania i IndexNow jako protokół innych wyszukiwarek. Mylenie tych warstw to najczęstszy błąd w skryptach “natychmiastowej indeksacji” pod WordPressem.
Ten przewodnik jest dla dewelopera, który utrzymuje WordPressa albo headless front pod Google. Cel: wiedzieć, co mierzyć w GSC, kiedy Indexing API ma sens według dokumentacji Google, kiedy sitemap wystarczy, i kiedy spamowanie powiadomieniami tylko marnuje quota projektu.
Jak skonfigurować Google Search Console dla WordPressa
Zanim sięgniesz po zaawansowane narzędzia, skonfiguruj usługę w Search Console tak, jak oczekuje tego Google. Google oferuje dwa typy usług: Domena i Prefiks URL.
Usługa typu Domena obejmuje wszystkie subdomeny i protokoły (http, https, www, bez www) w jednej usłudze. To zalecane podejście dla większości witryn. Wymaga weryfikacji przez DNS, czyli dodania rekordu TXT w konfiguracji DNS domeny. Przy WordPressie na hostingu zarządzanym zajmuje to zwykle mniej niż pięć minut w panelu hostingu.
Usługa typu Prefiks URL przydaje się, gdy chcesz śledzić konkretny podkatalog (np. example.com/blog/) albo nie masz dostępu do DNS. Weryfikacja: przesłanie pliku HTML, metatag, Google Analytics albo Google Tag Manager.
Po weryfikacji wykonaj te kroki:
- Połącz z GA4: w ustawieniach GSC powiąż usługę Google Analytics 4. Dane z GSC zobaczysz wtedy bezpośrednio w raportach GA4 i dostaniesz pełniejszą analizę atrybucji.
- Ustaw uprawnienia użytkowników: dodaj członków zespołu z odpowiednim poziomem dostępu. Użytkownik z pełnymi uprawnieniami widzi wszystkie dane i może wykonywać działania, użytkownik z ograniczonymi uprawnieniami tylko przegląda dane. W układzie agencyjnym ostrożnie nadawaj rolę właściciela, bo pozwala ona usuwać innych użytkowników.
- Zgłoś główną mapę witryny: w sekcji Mapy witryn podaj adres mapy XML. W WordPressie z Yoast albo Rank Math to zwykle
https://twojadomena.pl/sitemap_index.xml. - Sprawdź kierowanie międzynarodowe: jeśli prowadzisz witrynę wielojęzyczną, sprawdź
hreflangcrawlerem i wyrywkowo w URL Inspection. Google wycofało raport kierowania międzynarodowego w 2022 roku, więc Search Console nie pokazuje już błędów hreflang.
Jak sprawdzić URL w raporcie stron Google Search Console
Google Search Console nie jest jednym ekranem. Dwa widoki rozwiązują inne problemy i nie wolno ich używać zamiennie.
Raport Pages (dawniej Coverage) to widok agregatowy. Pokazuje, ile URL-i jest w indeksie, ile wykluczonych, i z jakiego powodu: Discovered - currently not indexed, Crawled - currently not indexed, przekierowania, noindex, soft 404, błędy serwera. To miejsce, w którym szukasz trendów: skok wykluczeń po deployu, masa sierot po migracji slugów, spekulacja parametrów UTM w indeksie.
URL Inspection to diagnostyka jednego adresu. Pokazuje, czy Google zna URL, jaki kanoniczny wybrał, kiedy ostatnio crawlowano, czy rendering HTML się udał, czy structured data przechodzi. Przycisk “Request indexing” w Inspection to ręczny ping crawl budżetu dla tego jednego URL-a - nie jest zamiennikiem Indexing API i nie skaluje się do tysięcy ścieżek.
Praktyczny workflow na produkcji WPPoland wygląda tak:
- W Pages znajdź kategorię wykluczenia z rosnącym licznikiem.
- Weź 5-10 przykładowych URL-i z tej kategorii.
- Odpal URL Inspection na każdym: sprawdź status HTTP, kanoniczny, datę crawla, rendered HTML.
- Dopiero potem zmieniaj treść, linkowanie albo robots - nie wysyłaj masowo powiadomień API “na wszelki wypadek”.
Jeśli Inspection mówi Submitted and indexed, a strona nie rankinguje, problem nie leży w indeksacji. Kończysz debug crawl/index i wracasz do treści, intencji zapytania i konkurencji SERP.
Do czego służy Google Indexing API
Dokumentacja Google Search Central jest jednoznaczna: Indexing API służy do powiadamiania Google o stronach z markupiem JobPosting albo BroadcastEvent (transmisje na żywo / livestream). Typy powiadomień to URL_UPDATED i URL_DELETED.
To nie jest ogólny “push do indeksu” dla blogów, landingu usług, portfolio ani sklepu WooCommerce. Powiadomienie dowolnego URL-a poza tym zakresem:
- wykracza poza udokumentowany use case,
- nie gwarantuje szybszego crawl ani indeksacji,
- zużywa quota konta serwisowego w Google Cloud.
Społeczność SEO od lat testuje API na “zwykłych” stronach. Wyniki są niespójne: czasem Googlebot pojawia się szybko, czasem status w Inspection nie zmienia się wcale. Traktuj takie testy jako eksperyment, nie jako fundament architektury. W kodzie produkcyjnym zakładaj oficjalny kontrakt: oferty pracy i livestreamy z poprawnym JSON-LD.
Dla WordPressa oznacza to konkretne scenariusze:
- wtyczka lub CPT ofert pracy z
JobPostingw head - wtedyURL_UPDATEDprzy publikacji / aktualizacji / wygaśnięciu oferty ma sens, - strona wydarzenia z
BroadcastEventi realną transmisją - sens ma powiadomienie o starcie i o zakończeniu (URL_DELETEDalbo aktualizacja statusu), - zwykły post blogowy, landing usług, kategoria WooCommerce - zostań przy sitemap + wewnętrznym linkowaniu + ewentualnym ręcznym Request indexing dla krytycznych URL-i.
Jak skonfigurować konto serwisowe dla Indexing API
Indexing API działa przez Google Cloud: włączasz API w projekcie, tworzysz service account, pobierasz klucz JSON, dodajesz e-mail konta serwisowego jako właściciela (Owner) property w Search Console. Bez Owner API odrzuci requesty.
Limitu dziennego nie kopiuj z artykułów ani z pamięci. Quota jest przypisana do projektu w Google Cloud Console (Quotas / Metrics dla Indexing API). Google może ją zmieniać; twój limit widzisz tylko w konsoli swojego projektu. Zanim napiszesz crona, odczytaj aktualny limit i zostaw zapas na peaki publikacji ofert. Punkt odniesienia daje strona kontyngentów: domyślnie 200 żądań publish dziennie na projekt (URL_UPDATED i URL_DELETED razem), 180 żądań getMetadata i 380 żądań łącznie na minutę. Google opisuje te 200 jako wartość na start i testy; produkcja wymaga dodatkowej akceptacji przez formularz, a kontyngent może rosnąć albo spadać zależnie od jakości dokumentów.
Implementacja w PHP typowo używa googleapis/google-api-php-client:
$client = new Google_Client();
$client->setAuthConfig('/secure/path/service-account.json');
$client->addScope(Google_Service_Indexing::INDEXING);

$service = new Google_Service_Indexing($client);
$notification = new Google_Service_Indexing_UrlNotification();
$notification->setUrl('https://example.com/pl/oferta/senior-wordpress/');
$notification->setType('URL_UPDATED');

$service->urlNotifications->publish($notification);
Uwagi inżynierskie, które omijają “hello world” z dokumentacji:
- trzymaj JSON klucza poza webrootem i poza repozytorium,
- loguj
url,type, HTTP status imessagez odpowiedzi API, - nie retry’uj w pętli przy 429 / quota - odkładaj do kolejki z backoffem,
- przed
URL_UPDATEDupewnij się, że strona zwraca 200, nie manoindex, a JSON-LD JobPosting/BroadcastEvent jest w HTML (nie tylko w JS po hydracji).
Po publish sprawdź URL Inspection. Powiadomienie to sygnał, nie gwarancja indeksacji. Jeśli markup jest zepsuty albo strona jest thin, Google może zignorować URL mimo 200 z API.
Kiedy nie używać Indexing API
Najkrótsza reguła: jeśli strona nie jest ofertą pracy ani livestreamem w sensie dokumentacji, nie buduj wokół Indexing API pipeline’u “każdy publish = publish notification”.
Nie spamuj API w tych sytuacjach:
- codzienny post blogowy albo aktualizacja treści marketingowej,
- masowa regeneracja permalinków po zmianie struktury URL,
- cron co 5 minut “odświeżający” te same ścieżki,
- próba “naprawy”
Discovered - currently not indexedtysiącami powiadomień, - deploy CSS/JS bez zmiany treści indeksowanej,
- staging / preview URL-e (nawet jeśli przypadkiem są w GSC).
Dlaczego to szkodzi: zużywasz quota, którą potrzebujesz w dniu masowej publikacji ofert. Generujesz szum w logach. Nie naprawiasz przyczyny wykluczenia - Google i tak ocenia jakość, kanoniczność i crawl budget. Jeśli Pages pokazuje Crawled - currently not indexed, problem zwykle siedzi w treści, duplikatach, braku linków wewnętrznych albo słabym sygnale E-E-A-T - nie w braku pingu API.
Zamiast spamu:
- Popraw treść i linkowanie wewnętrzne.
- Upewnij się, że URL jest w sitemap i sitemap jest zaakceptowany w GSC.
- Dla pojedynczego krytycznego URL użyj Request indexing w URL Inspection.
- Indexing API zostaw dla JobPosting / BroadcastEvent zgodnie z dokumentacją.
Jak dodać mapę witryny do Google Search Console
Sitemap nadal jest domyślnym, skalowalnym sposobem powiedzenia Google “te URL-e istnieją”. WordPress (core, Yoast, Rank Math, własny generator Astro) powinien emitować aktualną mapę; Ty jako deweloper odpowiadasz za poprawność, nie za “czy plugin coś robi”.
Minimum techniczne:
- każdy indeksowalny kanoniczny URL w
<loc>, - aktualizacja mapy po publish / unpublish,
- zgłoszenie sitemap w Search Console (Sitemaps) albo przez robots.txt (
Sitemap: https://…/sitemap.xml), - brak soft 404 i przekierowań w
<loc>- mapuj cele 200, - osobne rozszerzenia obrazów (
image:image), gdy zależy Ci na Google Images / Lens.
Sitemap nie wymusza indeksacji. Mówi Google o istnieniu URL-a. Jeśli URL ląduje w Discovered - currently not indexed, mapa zadziałała jako odkrycie; brak indeksu to decyzja jakościowa / budżetowa, nie “zepsuta mapa”.
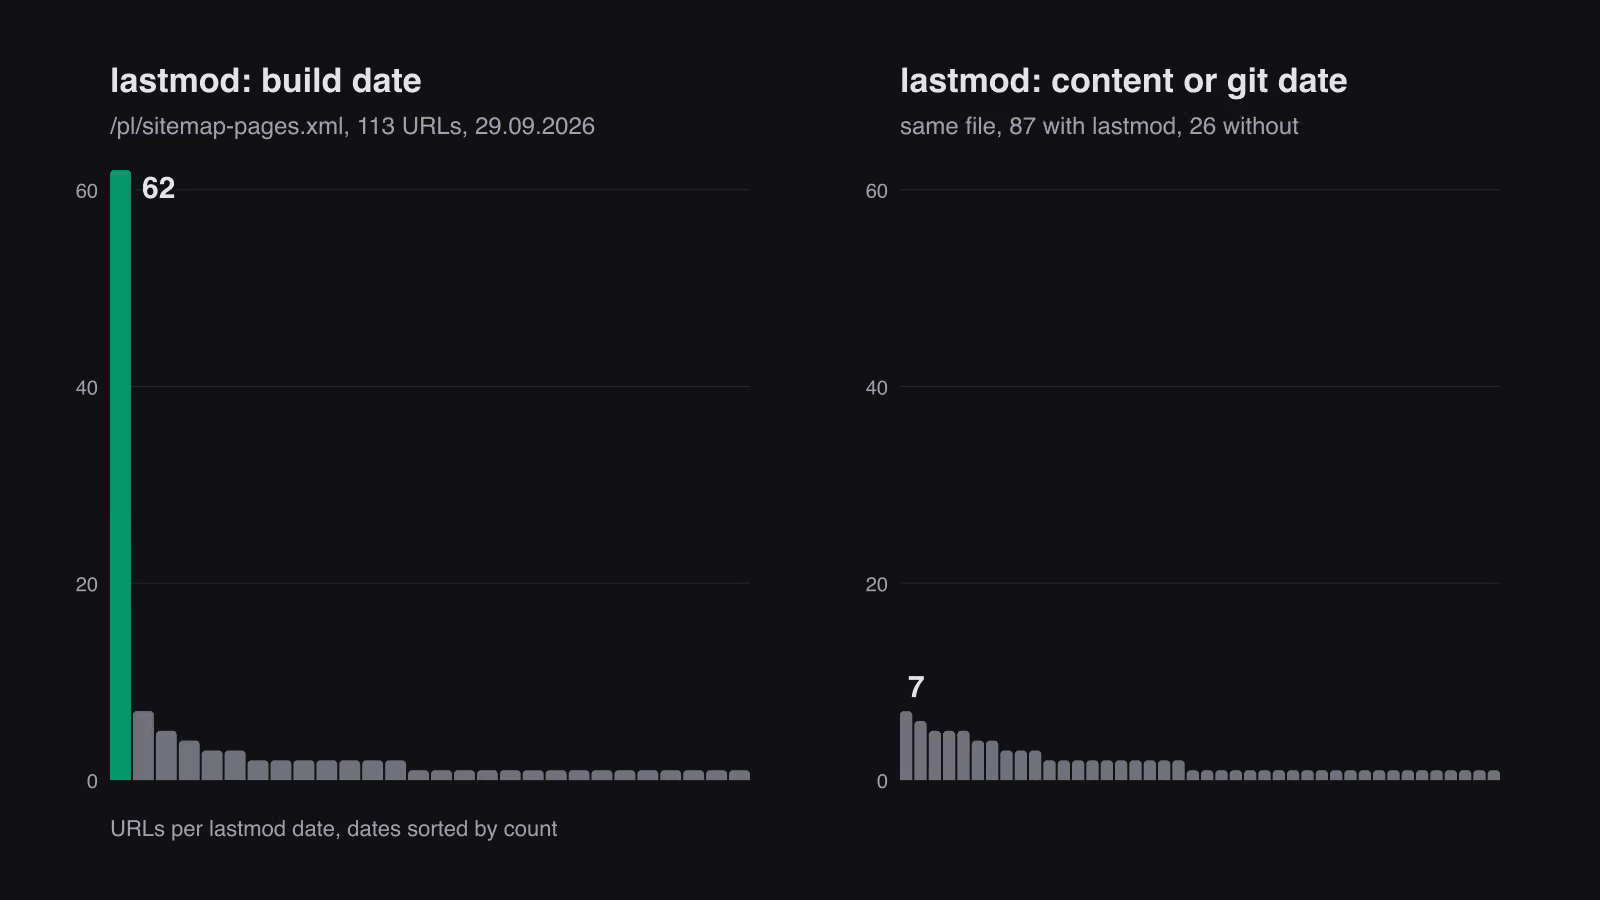
Starego endpointu ping nie używaj. Google ogłosiło jego wycofanie 26 czerwca 2023, pół roku później przestał działać i odpowiada 404. W tym samym wpisie Google pisze, że lastmod służy do planowania crawla tylko wtedy, gdy konsekwentnie zgadza się z rzeczywistością. Obrazom poświęcona jest osobna sekcja poniżej.
Programowe zgłaszanie map (Search Console API) ma sens przy wielu property albo automatyzacji CI. Monitorując status przez API, nie licz zaindeksowanych z contents[].indexed: dokumentacja zasobu sitemaps oznacza to pole jako wycofane. Patrz na lastDownloaded, errors i warnings. Dla jednej witryny wystarczy jednorazowe dodanie w UI i monitoring statusu “Success” / “Couldn’t fetch”.
Jak zbudować mapę obrazów dla AVIF i WebP
Yoast i Rank Math dodają wpisy obrazów automatycznie, ale własny albo headless stack musi to zrobić sam. Dokumentacja image sitemap opisuje te tagi jako sposób na wskazanie obrazów, których Google mógłby inaczej nie znaleźć, np. ładowanych JavaScriptem. Zwykły <img> w HTML renderowanym po stronie serwera Google znajduje bez nich.
Przykład fragmentu z obrazem:
<url>
  <loc>https://wppoland.com/pl/przyklad/</loc>
  <image:image>
    <image:loc>https://wppoland.com/images/przyklad.avif</image:loc>
  </image:image>
</url>
Jeden <url> mieści do 1000 <image:image>. <image:caption>, <image:title>, <image:geo_location> i <image:license> zniknęły z dokumentacji, więc generatory, które nadal je emitują, marnują bajty. Obrazy na domenie CDN są w porządku, o ile ta domena też jest zweryfikowana w Search Console, a robots.txt jej nie blokuje.
Ile naprawdę trwa crawl, indeksacja i serwowanie
Zanim zaczniesz szukać błędu w stronie, “która jeszcze się nie zaindeksowała”, sprawdź kalendarz. Gary Illyes pokazał w Barcelonie na Search Central Live wewnętrzne czasy Google, a Search Engine Roundtable opublikował tabelę 5 października 2026. Każdy wiersz ma czas typowy i najwolniejszy:
| Proces | Typowo | Najwolniej |
|---|---|---|
| Odkrycie nowego URL | ~20 godzin | Tygodnie do nigdy |
| Odświeżenie znanego URL | ~30 dni | Tygodnie do nigdy |
| Przetwarzanie sitemapy | ~24 godziny | Do 14 dni, albo nigdy (jakość) |
| Renderowanie | Sekundy, godziny w kolejce | Dni do tygodni |
| Indeksacja od końca do końca | ~1,5 godziny | Miesiące albo nigdy (jakość) |
| Zmiana canonicala | 1-3 tygodnie | Miesiące (sprzeczne sygnały) |
| Dane strukturalne | Godziny do 1-2 tygodni | Tygodnie albo nigdy (jakość) |
| Usunięcie w Search Console (właściciel) | ~2 godziny | 24 godziny |
| Zmiana tytułu | 1-2 dni | Kilka tygodni do miesięcy |
| Zdjęcie akcji ręcznej | 1-2 tygodnie | 4-6 tygodni, a dla uśpionych stron dużo dłużej |
| Odbudowa po core update | 3-6 miesięcy | 6 miesięcy do roku (następny core update) |
| Efekt spam update | 1-2 tygodnie (ciągle) | Miesiące (odświeżenia partiami) |
Procesy są połączone: strona nie wejdzie do indeksu przed crawlem, więc opóźnienia się sumują. Sam Gary dodał:
“miejcie na uwadze, że było to ćwiczenie, które miało sprawdzić, czy publiczność odnajdzie się w liczbach, które wyciągnęliśmy wewnętrznie i umieściliśmy na tych slajdach.”
Gary Illyes, Google, Search Engine Roundtable, tłumaczenie własne
To rzędy wielkości, nie umowa o poziomie usług.
Obok tabeli warto zapisać jeszcze jeden limit. Strona limitów Search Console API pozwala URL Inspection API na 2000 zapytań dziennie i 600 na minutę na witrynę, więc sprawdzenie 6000 adresów jednej witryny zajmuje trzy dni.
Przykłady opóźnień indeksowania w Search Console
- Nieaktualne pobranie sitemapy ukryło 2034 URL-i. GSC ostatni raz pobrał nasze sześć sitemap lokalizacji 1 września o 10:08, gdy miały 2037 URL-i. Korpus urósł do 4071, a przez pięć dni nie było nowego pobrania, choć sitemapy bloga były czytane codziennie. Ponowne przesłanie przez API 6 września zostało pobrane tego samego dnia. Strony z wyświetleniami: z 223 na 343, wyświetlenia z 1570 na 4382, ale tylko 2 kliknięcia w 7 dni. Odblokowało się odkrywanie, nie konwersja.
- Werdykt to zdjęcie z dnia crawla. 17 września 3609 z 6747 URL-i z sitemap (53,5%) nie miało ani jednego wyświetlenia w 90 dni. Z 19 sprawdzonych 6 miało “Excluded by noindex”, choć na żywo szło
index, follow. 27 września wciąż 3 z 20, ostatni crawl od 7 maja do 20 sierpnia. - IndexNow z URL-ami zgadniętymi z nazw plików. Skrypt wygenerował 2328 adresów, żadnego nie było w sitemapie, wszystkie dawały 301.
Zanim uznasz stronę za słabą, porównaj datę werdyktu z datą ostatniej zmiany.
Strona odkryta lub zeskanowana, ale obecnie niezindeksowana
Te dwa stany mylą się w ticketach SEO.
Discovered - currently not indexed: Google zna URL (sitemap, link, inny sygnał), ale jeszcze nie crawlowano albo crawl odłożono. Częste przyczyny: niski priorytet w budżecie, masa nowych URL-i naraz, słabe linkowanie, parametry / facety.
Crawled - currently not indexed: Googlebot był na stronie i zdecydował, że na razie nie wrzuca jej do indeksu. Tu patrzysz na thin content, near-duplicate, kanoniczny wskazujący indziej, render bez treści, niski sygnał z linków wewnętrznych.
Checklist deweloperski przed eskalacją do “włączmy Indexing API”:
- HTTP 200, bez
noindex/X-Robots-Tag, - kanoniczny self-reference zgodny z URL w GSC,
- treść w pierwszym HTML (nie dopiero po client-side fetch),
- ≥ jednego znaczącego linku wewnętrznego z indeksowanej strony,
- brak kopii pod drugim slugiem / parametrem,
- URL obecny w sitemap.
Dopiero gdy checklist jest zielony, a URL jest JobPosting/BroadcastEvent, wracasz do Indexing API. W pozostałych przypadkach API nie jest lekarstwem.
IndexNow a Google Indexing API
IndexNow to otwarty protokół powiadamiania wyszukiwarek o nowych i usuniętych URL-ach. Bing, Yandex i partnerzy go obsługują. Google nie jest uczestnikiem IndexNow - powiadomienie IndexNow nie idzie do Googlebota.
Różnice praktyczne:
| Mechanizm | Kogo powiadamia | Typowy use case |
|---|---|---|
| Google Indexing API | Google (wąski zakres JobPosting / BroadcastEvent) | Oferty pracy, livestreamy |
| Request indexing (GSC UI) | Google, jeden URL | Ręczna interwencja |
| Sitemap + crawl | Google (i inne boty czytające mapę) | Stałe odkrywanie witryny |
| IndexNow | Bing / Yandex / partnerzy | Szybkie powiadomienie poza Google |
W WordPressie plugin “IndexNow” albo własny endpoint z kluczem w rootcie ma sens, jeśli zależy Ci na Bing. Nie myl go z Google Indexing API w nazwie zmiennej, cronie ani dokumentacji wewnętrznej - to dwa różne kontrakty, dwa różne authy, dwa różne efekty.
robots.txt i budżet crawla
robots.txt nie indeksuje i nie deindeksuje. Steruje dostępem botów. W 2026 warto świadomie rozdzielić:
- Googlebot / Google-InspectionTool - pozwól na ścieżki, które mają być w indeksie,
- boty AI / scrapery, które nie budują Twojego ruchu z wyszukiwarki - decyzja produktowa (blokada vs allow),
- ścieżki admin, preview, feedy parametryczne - Disallow tam, gdzie crawl nic nie daje.
Przykład obronny (dostosuj do polityki firmy):
User-agent: GPTBot
Disallow: /

User-agent: CCBot
Disallow: /

User-agent: Googlebot
Allow: /
Blokada scrapera nie naprawi Crawled - currently not indexed. Może jedynie ograniczyć zbędny ruch. Budżet Googlebota zarządzasz jakością URL-i, sitemapą i linkowaniem - nie listą Disallow na konkurencyjne LLM-y.
Automatyczne indeksowanie stron w WordPressie
Dla typowej witryny firmowej / agencyjnej:
- Generator sitemap (plugin lub SSG) + status Success w GSC.
- Monitoring Pages raz w tygodniu (albo Search Console API w CI).
- URL Inspection na URL-ach z regresją po deployu.
- Indexing API tylko jeśli publikujesz JobPosting / BroadcastEvent.
- Opcjonalnie IndexNow pod Bing - osobny job, osobny klucz.
Dla portalu z setkami ofert pracy dziennie dodaj kolejkę powiadomień, odczyt quoty z Cloud Console, alert przy zbliżeniu do limitu i walidację JSON-LD przed publish. Bez walidacji markupu marnujesz requesty.
Jak zautomatyzować indeksowanie w Google w pipeline CI/CD
Dla stron statycznych budowanych w Astro, Next.js albo podobnych frameworkach (jak stack wppoland.com) wpięcie indeksowania w pipeline builda sprawia, że każdy deploy wysyła właściwe powiadomienia.
Przykład hooka po buildzie
Utwórz skrypt uruchamiany po buildzie, który czyta wygenerowaną mapę witryny, wybiera nowe lub zmienione URL-e i wysyła je do IndexNow. Do Google Indexing API trafiają tylko URL-e ofert pracy i transmisji na żywo:
const { readFileSync } = require('fs');
const { XMLParser } = require('fast-xml-parser');

async function postBuildIndex(sitemapPath) {
  const xml = readFileSync(sitemapPath, 'utf-8');
  const parser = new XMLParser();
  const sitemap = parser.parse(xml);

  const urls = sitemap.urlset.url
    .filter(entry => {
      const lastmod = new Date(entry.lastmod);
      const oneDayAgo = new Date(Date.now() - 86400000);
      return lastmod > oneDayAgo;
    })
    .map(entry => entry.loc);

  console.log(`Found ${urls.length} recently modified URLs`);
  // submitIndexNow i submitBatch to własne funkcje wysyłające żądania do IndexNow i Indexing API
  await submitIndexNow(urls, process.env.INDEXNOW_KEY, 'wppoland.com');  // IndexNow
  const jobUrls = urls.filter(u => u.includes('/jobs/'));  // only JobPosting pages
  await submitBatch(jobUrls);  // Google Indexing API
}Integracja z CI/CD
W pipeline GitHub Actions albo GitLab CI dodaj krok po jobie deployu:
- name: Notify search engines
  env:
    GOOGLE_INDEXING_CREDENTIALS: ${{ secrets.GOOGLE_INDEXING_CREDENTIALS }}
    INDEXNOW_KEY: ${{ secrets.INDEXNOW_KEY }}
run: node scripts/post-build-index.jsJak gospodarować limitem
Przy domyślnym limicie 200 żądań publish dziennie dla całego projektu Cloud portal z ofertami pracy musi ustalić priorytety:
- Najpierw nowe oferty: oferta, której Google jeszcze nie widział, ma najwyższy priorytet.
- Potem wygasłe oferty: wyślij
URL_DELETED, gdy stanowisko jest obsadzone, żeby oferta zniknęła z wyników, zamiast kierować kandydatów na martwą stronę. - Pomijaj niezmienioną treść: porównuj daty
lastmodalbo hashe treści, żeby nie marnować limitu na strony bez zmian. - Nadmiar do kolejki na następny dzień: jeśli deploy ma więcej URL-i niż limit, zapisz resztę i przetwórz ją następnego dnia zaplanowanym zadaniem.
Jak porównać kilka krajów w raporcie skuteczności Search Console
Od października 2026 filtr Kraj w raporcie skuteczności przyjmuje kilka krajów naraz. Google ogłosił zmianę na LinkedInie, a 6 października opisał ją Barry Schwartz:
„Jeśli działasz w kilku krajach, możesz teraz zobaczyć ich łączny ruch z wyszukiwarki Google.”
Google na LinkedInie, cytowane przez Barry’ego Schwartza w Search Engine Roundtable, 6 października 2026, tłumaczenie własne
Do tej pory sumę kliknięć z dwóch rynków składało się w arkuszu z dwóch eksportów. Teraz zaznaczasz kraje i dostajesz jedną linię kliknięć i wyświetleń. Sklep, który poza Polską sprzedaje też do Czech i na Słowację, zaznacza wszystkie trzy kraje, a potem porównuje wynik z samą Polską. Jeśli Czechy i Słowacja ledwo podnoszą linię, osobna wersja językowa jeszcze się nie zwróci.
Podsumowanie
- Pages = trend i kategorie wykluczeń; URL Inspection = jeden URL pod lupą.
- Indexing API = oficjalnie JobPosting i BroadcastEvent; generic URL notification jest poza kontraktem.
- Quota: tylko z Google Cloud Twojego projektu, bez liczb z pamięci.
- Sitemap zostaje podstawą odkrywania; API go nie zastępuje.
- Nie spamuj powiadomieniami przy problemach jakościowych.
- IndexNow ≠ Google; to inna wyszukiwarka i inny protokół.
Nie czekaj na cudowny ping. Najpierw spraw, żeby URL był wart crawl. Potem wybierz właściwy kanał powiadomienia - i tylko ten.
Dla osoby w zespole, która zaczyna z Search Console od zera: 6 października 2026 Google Search Central udostępnił dwie playlisty na YouTube (ogłosił je Daniel Waisberg). Search fundamentals for beginners to podstawy dla początkujących: crawl, indeksowanie, serwowanie i raporty skuteczności. Technical SEO fundamentals to podstawy technicznego SEO: robots.txt, budżet crawla, narzędzie do sprawdzania adresów URL oraz zbiorcze eksporty danych i API Search Console.