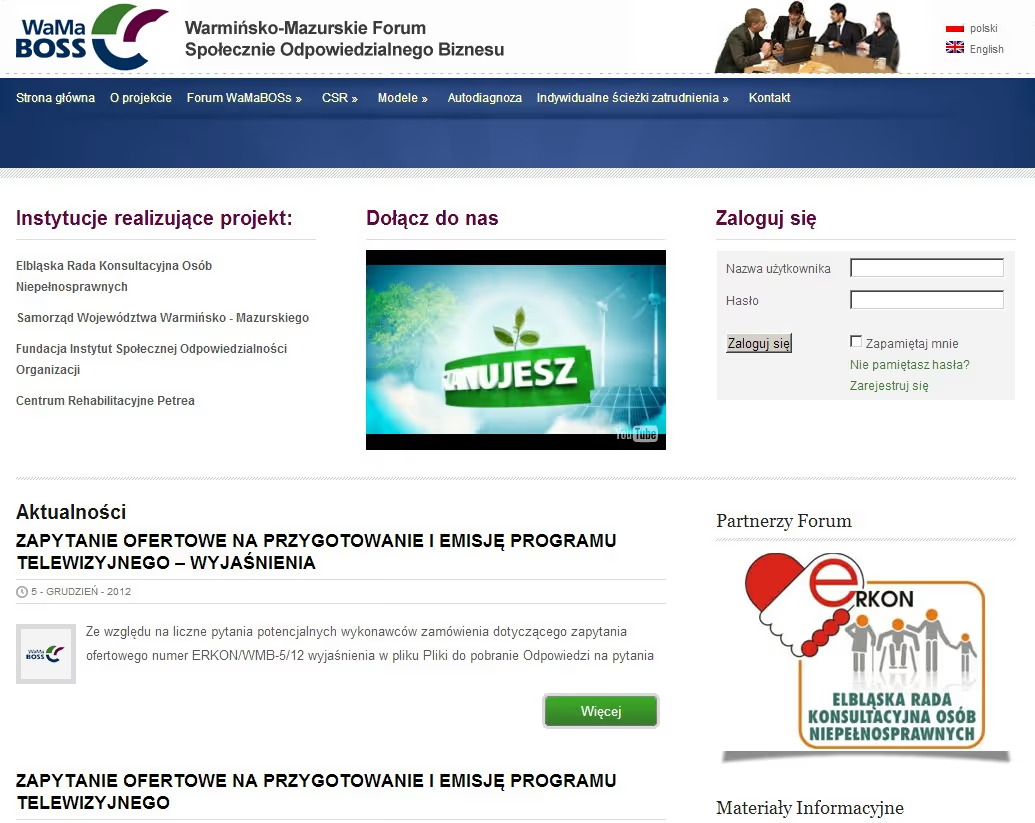
centrum-csr.com, Twoje centrum wiedzy o społecznej odpowiedzialności biznesu
Serwis o społecznej odpowiedzialności biznesu ma wbudowany problem, którego nie ma sklep ani wizytówka: połowa jego treści starzeje się z datą w środku. Raport z jednego roku, wytyczne, które za dwa lata zostaną zastąpione nowymi, opis praktyki firmy, która zdążyła zmienić właściciela. Druga połowa nie starzeje się prawie wcale, bo definicje, sposób liczenia wpływu społecznego i mechanika wdrażania polityk działają tak samo po dekadzie. Jeśli obie połowy trafią do jednego worka o nazwie “artykuły”, serwis po kilku latach przestaje być źródłem wiedzy, a staje się archiwum, w którym czytelnik nie wie, co jest nadal aktualne.
centrum-csr.com powstał w 2012 roku jako serwis poświęcony idei CSR i zrównoważonego rozwoju, kierowany do firm, organizacji pozarządowych i osób, które wdrażają takie praktyki u siebie. Stoi na WordPressie, korzysta z REST API i Redisa, warstwa frontowa to HTML5, CSS3 i SASS, a pliki multimedialne idą przez CDN. Wdrożenie zajęło około sześciu tygodni. Układ i rozmieszczenie elementów dostarczył klient, a moją rolą było przełożenie go na model treści, szablony i integracje.
Wiedza i aktualności to dwa różne rodzaje treści
Najważniejsza decyzja redakcyjna dotyczyła rozdzielenia bazy wiedzy od strumienia aktualności. Wyglądają podobnie, bo jedno i drugie jest tekstem z tytułem i datą, a zachowują się inaczej w każdym istotnym wymiarze.
Aktualność ma sens przez tydzień, jest warta wypchnięcia na stronę główną i nie musi wracać. Poradnik z bazy wiedzy jest wart tyle, ile jego aktualność po dwóch latach, więc potrzebuje przeglądu, oznaczenia daty weryfikacji i miejsca w strukturze, które nie zależy od tego, kiedy go opublikowano. Praktyczny skutek tego rozdziału jest taki, że treść trwała dostaje własne kategorie tematyczne, takie jak ekologia czy etyka w biznesie, i własne szablony, a strumień informacyjny zostaje strumieniem.
Kosztem jest dyscyplina redakcyjna. Ktoś musi decydować, do której szuflady trafia tekst, a to jest decyzja, której nie da się w pełni zautomatyzować, bo ten sam materiał można napisać jako notatkę o wydarzeniu albo jako wprowadzenie do tematu. Zysk jest widoczny dopiero po latach, kiedy okazuje się, że da się zrobić przegląd dwudziestu poradników, a nie dwustu wpisów, z których większość i tak jest historią.
Ta sama logika stoi za osobną sekcją prezentującą przykłady wdrożeń. To nie jest galeria dla ozdoby, tylko zbiór przypadków, do którego odsyła się z tekstów merytorycznych. Żeby taki zbiór dało się utrzymać, każdy przypadek musi mieć swoje pola, a nie być kolejnym akapitem z wklejonym zdjęciem.
Dynamiczne ładowanie treści i granica, której nie warto przekraczać
Serwis korzysta z asynchronicznego ładowania treści, czyli listy i sekcje doczytują kolejne pozycje bez przeładowania całej strony. Przy rozbudowanej bazie artykułów i raportów to realna wygoda: czytelnik przegląda listę, zawęża ją i nie płaci za każdym razem pełnym kosztem renderowania strony.
Granica jest jedna i warto ją znać przed wdrożeniem, a nie po. Treść, która istnieje wyłącznie po uruchomieniu skryptu, dla części odbiorców nie istnieje w ogóle. Dotyczy to robotów indeksujących w łagodniejszym scenariuszu i czytników ekranu w poważniejszym. Dlatego każdy artykuł i każdy raport ma własny adres i pełną treść w zwykłym dokumencie HTML, a doczytywanie jest wyłącznie przyspieszeniem nawigacji po listach.
REST API służy tu do tego samego, do czego służy dobrze zaprojektowany endpoint w każdym innym projekcie: oddaje dokładnie te dane, które są potrzebne do narysowania fragmentu interfejsu. Gdyby lista artykułów pobierała pełne wpisy, ciągnęłaby przy każdym doczytaniu całą treść po to, żeby pokazać tytuł, kategorię i dwa zdania wprowadzenia. Mniejsza odpowiedź to nie tylko szybsze ładowanie, ale też lepsze zachowanie cache, bo taki zasób zmienia się rzadziej niż treść artykułu.
Formularze, czyli miejsce, w którym serwis spotyka ludzi
Formularz kontaktowy w serwisie tematycznym pełni inną funkcję niż w sklepie. Nie zbiera zamówień, tylko pytania o konsultacje, prośby o materiały i zgłoszenia od organizacji, które chcą się pokazać z własną praktyką. To oznacza, że wiadomość jest zwykle długa i że nadawcy zależy na odpowiedzi, a nie na potwierdzeniu transakcji.
Z technicznego punktu widzenia są tu trzy rzeczy do przemyślenia. Pierwsza to dostarczalność: wiadomość wysyłana przez serwer serwisu z adresem nadawcy wpisanym w formularzu ląduje w spamie częściej, niż ktokolwiek się spodziewa, więc adres nadawcy musi należeć do domeny serwisu, a adres z formularza ma trafić do pola odpowiedzi. Druga to spam: każdy publicznie dostępny formularz jest znajdowany przez automaty w ciągu kilku tygodni od uruchomienia, więc filtr i ograniczenie częstotliwości nie są dodatkiem, tylko warunkiem tego, żeby skrzynka pozostała czytelna. Trzecia to długość pól: obcięcie treści wiadomości limitem znaków jest defektem, który daje o sobie znać dopiero wtedy, gdy ktoś opisał sprawę na trzy akapity, a do adresata dotarły dwa.
Wydajność, cache i redaktor, który nic z tego nie widzi
Redis obsługuje tu cache obiektowy, czyli warstwę, która trzyma wyniki drobnych odczytów poza bazą danych. WordPress składa stronę z wielu takich odczytów: opcje, metadane, relacje taksonomii. Na widoku listy z kategoriami, tagami i wprowadzeniami ich liczba rośnie szybciej, niż wynikałoby to z liczby widocznych elementów.
Najciekawsze jest to, komu ten cache pomaga. Pełny cache strony obsługuje anonimowego czytelnika i z jego perspektywy załatwia sprawę. Nie działa natomiast dla zalogowanego redaktora, dla widoków z parametrami i dla odpowiedzi API, czyli dokładnie tam, gdzie pracuje zespół publikujący treść. Serwis, który jest szybki dla czytelnika i wolny w panelu, zniechęca do publikowania, a to jest droższy problem niż kilkaset milisekund na stronie głównej.
Pliki multimedialne, czyli zdjęcia, infografiki i materiały wideo ilustrujące inicjatywy, idą przez CDN. Powód jest prozaiczny: to są największe pliki w serwisie, a ich serwowanie z serwera aplikacyjnego zajmuje zasoby, które lepiej zostawić na generowanie stron.
Testy wydajnościowe prowadzę na kopii produkcji, nie na czystej instalacji. Pusty WordPress odpowiada szybko zawsze, bo nie ma czego szukać. Dopiero baza z kompletem artykułów, raportów, powiązań kategorii i historią komentarzy pokazuje, które zapytanie przegląda pół tabeli.
Warstwa frontowa i dług, który się w niej odkłada
Warstwa wizualna powstała w HTML5, CSS3 i SASS. SASS był tu decyzją utrzymaniową, a nie estetyczną: pozwala trzymać kolory, odstępy i punkty łamania w jednym miejscu, zamiast rozsiewać je po arkuszach, co przy serwisie rozbudowywanym latami jest różnicą między zmianą na piętnaście minut a przeglądaniem całego CSS.
Uczciwie trzeba dodać, że warstwa frontowa starzeje się szybciej niż cokolwiek innego w takim projekcie. Konwencje responsywności z 2012 roku, gotowe siatki i biblioteki, na których wtedy budowało się układy, są dziś warstwą, którą przy większej przebudowie wymienia się w całości. Model treści i sposób dostarczania danych przez API przetrwały ten okres znacznie lepiej, i to jest obserwacja, którą warto przenieść na każdy nowy projekt: pieniądze wydane na strukturę danych pracują dłużej niż pieniądze wydane na warstwę prezentacji.
SEO i widoczność treści tematycznej
Warstwa wyszukiwarkowa opiera się na semantycznych znacznikach, uporządkowanych metadanych, czytelnych adresach i danych strukturalnych schema.org, wspartych mapą witryny w formacie XML. Celem jest opisanie maszynie tego, co człowiek odczytuje z układu strony: co jest tytułem, co datą, co autorem, a co elementem nawigacji.
Warto nazwać rzecz po imieniu: w takiej tematyce o widoczności decyduje jakość materiałów i to, kto do nich linkuje, a warstwa techniczna jedynie usuwa przeszkody. Uporządkowana struktura nie postawi słabego tekstu przed dobrym. Sprawi natomiast, że dobry tekst nie przepadnie przez to, że wyszukiwarka nie rozpoznała rodzaju strony. Nie mam pomiarów efektu tej pracy, których mógłbym tu użyć, więc żadnych nie podaję.
Wsparcie i utrzymanie serwisu
Opieka nad serwisem obejmuje aktualizacje rdzenia, motywu i wtyczek, przeglądanie logów, kopie zapasowe oraz drobne zmiany funkcjonalne i graficzne. Aktualizacje testuje się na kopii, bo w serwisie z własnymi szablonami, integracją API i formularzami zmiana we wtyczce potrafi przestawić zachowanie bez żadnego komunikatu o błędzie: znika filtr, na którym opierał się jeden widok, zmienia się sposób budowania zapytania, przestaje działać wysyłka z formularza.
Kopia zapasowa jest procedurą odtworzenia, a nie plikiem na dysku. Ta, z której nigdy nie odtwarzano serwisu, jest deklaracją. Wartość ma ta, z której raz postawiono działający serwis i zapisano, ile to trwało.
Podsumowanie
centrum-csr.com jest serwisem, w którym treść merytoryczna jest produktem, a technologia ma ją utrzymać w stanie nadającym się do czytania przez lata. Zadecydowało kilka rzeczy niewidocznych z zewnątrz: rozdzielenie bazy wiedzy od aktualności, doczytywanie treści jako przyspieszenie nawigacji, a nie jako jedyna droga do tekstu, cache obiektowy ustawiony pod pracę redakcji, i oddzielenie struktury danych od warstwy prezentacji, która i tak zestarzeje się pierwsza.
Na kolejne wdrożenie przenosi się warstwa techniczna i metoda: WordPress, Redis, REST API, CDN, testowanie na kopii produkcji. Nie przenosi się model treści tego serwisu ani jego integracje, bo powstały pod jeden zbiór materiałów i jeden sposób pracy redakcji. Nowy projekt zaczyna się od analizy zakresu, a wycena idzie po niej.
Często zadawane pytania
Najważniejsze odpowiedzi, które pomagają wdrożyć temat w praktyce.
Jakiego zakresu dotyczył projekt centrum-csr.com?
#Jak wyglądał przebieg prac przy centrum-csr.com?
#Co było najtrudniejsze technicznie w centrum-csr.com?
#Co z projektu centrum-csr.com da się wykorzystać przy kolejnym wdrożeniu?
#Potrzebujesz FAQ dopasowanego do branży i rynku? Przygotujemy wersję pod Twoje cele biznesowe.
Porozmawiajmy