Wycena druku nie jest ceną, tylko funkcją
Najważniejsza różnica między tym projektem a zwykłym sklepem leży w jednym miejscu: tutaj produkt nie ma ceny. Książka do wydrukowania jest zestawem parametrów, a cena jest wynikiem działania na tym zestawie. Format, gramatura papieru, liczba stron, rodzaj oprawy, kolor albo czerń, nakład, uszlachetnienia. Każdy z tych parametrów zmienia wynik, a kilka z nich zmienia go skokowo.
To nie jest problem, który da się obejść cennikiem. Liczba kombinacji rośnie iloczynowo, więc wypisanie ich wszystkich jako pozycji katalogu przestaje być wykonalne po trzecim parametrze. Wycena musi więc liczyć się na żądanie, na podstawie struktury stawek, a nie być odczytywana z listy. To z kolei ustawia całą resztę architektury, bo dane wejściowe przychodzą z formularza, a wynik ma pojawić się od razu i ma być powtarzalny.
Druga cecha tej dziedziny jest mniej oczywista i łatwo ją w kodzie przeoczyć. Koszt druku nie rośnie liniowo z nakładem, ponieważ przygotowanie maszyny kosztuje tyle samo przy stu i przy dziesięciu tysiącach egzemplarzy, a rozkłada się na nakład. Do tego zmiana formatu potrafi przenieść zlecenie na inną maszynę albo na inny arkusz, co zmienia koszt skokowo, a nie płynnie. Naiwna implementacja, która interpoluje między dwoma punktami cennika, daje wyniki poprawne w środku zakresu i fałszywe dokładnie przy progach, czyli tam, gdzie klient najczęściej dopytuje. Kalkulacja musi więc odwzorowywać progi, a nie krzywą przez nie przeprowadzoną.
Klient: Have a Book z Gdyni
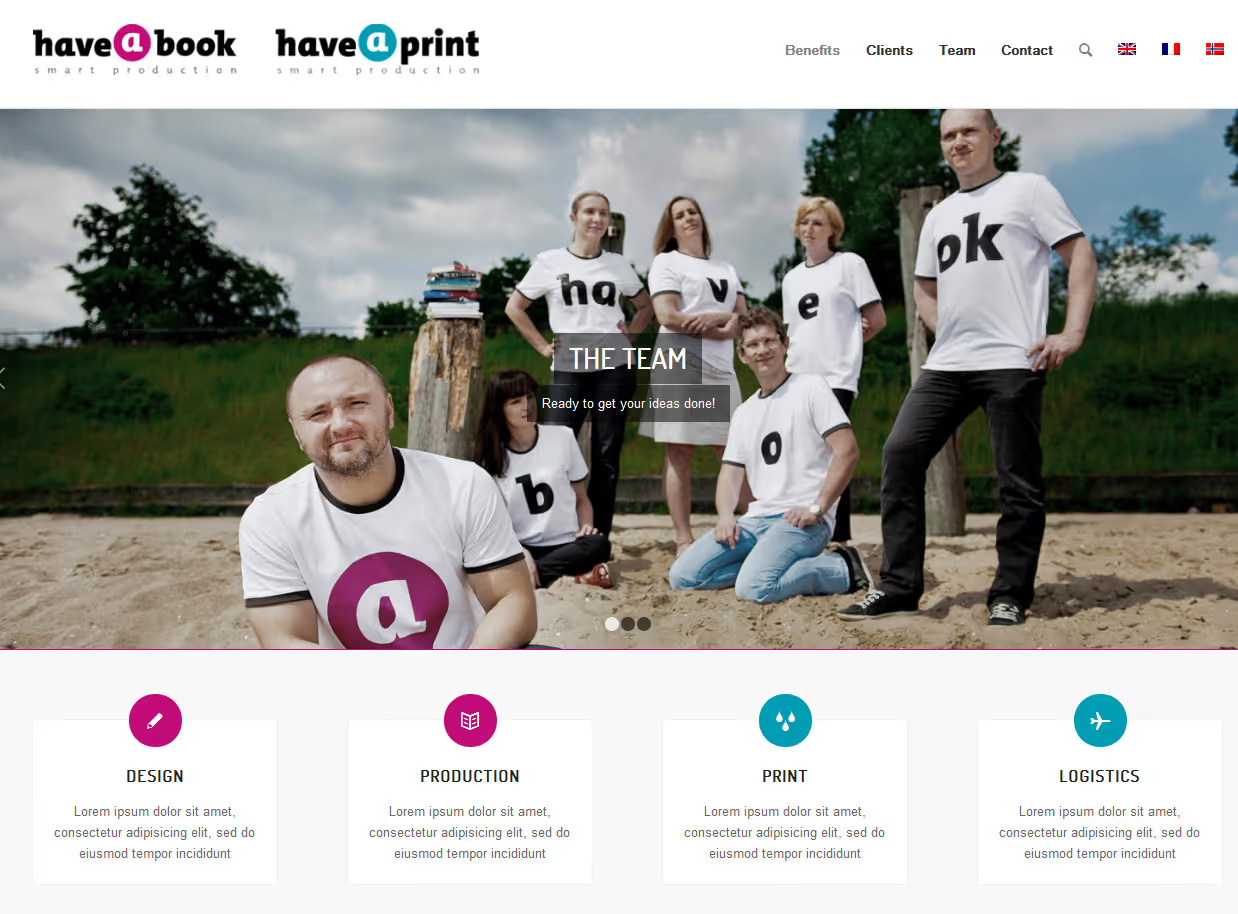
Have a Book to gdyńska firma działająca od 2007 roku, z siedzibą przy ulicy Wierzbowej, zatrudniająca kilkadziesiąt osób. Opisuje się jako jedno miejsce obsługi dla wydawców edukacyjnych w Europie: skład i przygotowanie do druku, projekt graficzny, typografia, druk i oprawa, a także konwersja publikacji do formatów elektronicznych z uwzględnieniem dostępności według WCAG. Klienci firmy to wydawcy edukacyjni z Norwegii, Francji, Szwajcarii i Belgii.
Ten profil odbiorcy przesądza o kształcie serwisu. Wydawca edukacyjny nie kupuje impulsowo i nie kupuje jednej książki. Kupuje serię tytułów w kilku wariantach, a decyzję podejmuje zespół, w którym ktoś patrzy na budżet, ktoś inny na termin, a ktoś jeszcze na to, czy drukarnia poradzi sobie z konkretnym rodzajem oprawy przy podręczniku, który będzie otwierany codziennie przez trzy lata. Serwis, który obsługuje taką decyzję, potrzebuje trzech rzeczy naraz: wyceny, terminu i dowodu na jakość wykonania.
Rynek skandynawski dokłada do tego własne wymagania. Serwis obsługuje treść po szwedzku, norwesku i duńsku oraz po angielsku, a to znaczy coś więcej niż cztery zestawy tłumaczeń, o czym niżej.
Wielojęzyczność, która nie jest tylko tłumaczeniem
Najczęstszy błąd w projektach wielojęzycznych polega na potraktowaniu języka jako etykiety założonej na te same dane. Przy rynku skandynawskim ta uproszczona wersja psuje się w miejscu, którego nikt nie sprawdza przed odbiorem: przy sortowaniu list.
Alfabety szwedzki i duńsko-norweski zawierają znaki, których w alfabecie angielskim nie ma, i co ważniejsze, umieszczają je w innej kolejności. To nie jest ozdoba typograficzna, tylko reguła porządkowania. Lista tytułów albo lista klientów posortowana według jednej reguły dla wszystkich języków będzie dla części odbiorców po prostu nieposortowana, a przy wyszukiwaniu w katalogu dojdzie do tego, że fraza wpisana bez znaku diakrytycznego nie znajdzie pozycji, która go zawiera. Rozwiązanie polega na tym, żeby reguła porównywania tekstu była właściwością wersji językowej, a nie globalnym ustawieniem bazy.
Druga rzecz to rozróżnienie języka od rynku. Klient z Norwegii i klient ze Szwecji mogą oglądać serwis po angielsku, a mimo to potrzebować innych formatów papieru i innych terminów opisujących oprawę. Model treści musi więc dopuszczać, że wariant językowy i wariant rynkowy to dwie osie, a nie jedna. Serwisy, które sklejają je w jedno, kończą tłumaczeniem tych samych danych po raz drugi tylko po to, żeby podmienić jedną tabelę.
Trzecia rzecz dotyczy adresów. Każda wersja językowa musi mieć własny, trwały adres i deklarację powiązania z pozostałymi wersjami, bo inaczej wyszukiwarka pokazuje szwedzkiemu wydawcy wersję angielską, a to w praktyce oznacza zapytanie ofertowe, które nie przychodzi.
Katalog oferty i portfolio realizacji
Katalog usług drukarskich i wydawniczych jest widokiem filtrowanym po kategoriach, typach usług i specyfikacjach. Filtrowanie idzie po stronie zapytania, nie po stronie przeglądarki, i to rozstrzygnięcie ma tę samą przyczynę co w każdym katalogu technicznym: zbiór urośnie, a przesyłanie go w całości do przeglądarki przestanie się opłacać wcześniej, niż ktokolwiek to zauważy podczas testów na danych przykładowych.
Katalog ma jeszcze jedną właściwość, która odróżnia go od katalogu produktów. Pozycja w ofercie drukarni nie jest rzeczą, tylko zdolnością wykonawczą, a ta opisuje się zakresami: od tylu do tylu stron, w takich formatach, na papierze o takiej gramaturze, z taką oprawą. Przeniesienie tego do modelu treści oznacza, że atrybut pozycji katalogowej bywa przedziałem, a nie wartością, i że filtr po specyfikacji musi pytać o zawieranie się w przedziale, a nie o równość. Filtry zbudowane na równości wyglądają poprawnie na etapie budowy i cicho wycinają połowę oferty, gdy ktoś wpisze liczbę stron spoza wypisanych wariantów.
Portfolio realizacji pełni tu funkcję, której nie pełni w większości serwisów usługowych. Wydawca ocenia drukarnię po tym, jak wygląda gotowa książka, a zdjęcie okładki w małej rozdzielczości nie mówi nic o tym, jak zachowuje się grzbiet po roku używania ani jak wypada kolor na danym papierze. Galerie muszą więc pokazywać detal, a to znaczy pliki duże, i stąd bierze się osobna praca nad tym, żeby strona z galerią nie ładowała wszystkiego naraz. Podglądy idą pierwsze, pełne wersje dopiero przy otwarciu, a same pliki są oddawane z warstwy dostarczania treści, nie z serwera aplikacji.
Wyzwania i rozwiązania programistyczne
Pierwszym wyzwaniem był silnik wyceny wystawiony przez własne punkty końcowe interfejsu. Formularz wysyła zestaw parametrów, serwer zwraca wynik. Kluczowa decyzja brzmi: gdzie mieszka logika liczenia. Kuszące jest policzenie ceny w przeglądarce, bo wtedy wynik pojawia się natychmiast i nie kosztuje żadnego zapytania. Kuszące i błędne, ponieważ struktura stawek staje się wtedy publiczna, a kopia logiki w przeglądarce rozjeżdża się z serwerem przy pierwszej zmianie cennika, której nikt nie przeniesie w obie strony. Liczenie siedzi więc na serwerze, a przeglądarka odpowiada wyłącznie za zebranie parametrów i pokazanie wyniku.
Drugim wyzwaniem była powtarzalność wyceny. Cena podana w poniedziałek musi dać się odtworzyć w czwartek, nawet jeżeli w międzyczasie zmieniła się tabela stawek. Dlatego z wyceną zapisywany jest komplet parametrów oraz wersja struktury stawek, na podstawie której powstała, a nie sama liczba. Bez tego każda zmiana cennika unieważnia historię i nie da się odpowiedzieć na proste pytanie, dlaczego klient widział taką kwotę. To samo rozstrzygnięcie porządkuje cache: klucz zapisanego wyniku musi zawierać wersję stawek, bo inaczej po aktualizacji cennika serwis przez jakiś czas oddaje stare kwoty i robi to bez śladu w logach.
Trzecim wyzwaniem była wydajność przy dużej liczbie materiałów multimedialnych. Cache w pamięci skraca pracę bazy dla tego, co i tak musi przejść przez warstwę aplikacji: zestawów pozycji katalogu, tabel stawek, ustawień. Sieć dostarczania treści przejmuje pliki. To są dwa różne problemy i warto je rozdzielić wprost, bo bywają mylone: cache w pamięci nie przyspieszy pobrania zdjęcia w pełnej rozdzielczości, a warstwa brzegowa nie skróci zapytania do bazy.
Czwartym wyzwaniem było przyjmowanie plików. Zamówienie druku nie jest koszykiem, tylko zleceniem produkcyjnym, do którego dołącza się materiał. Plik do druku bywa duży, a przesłanie go przez zwykły formularz zawodzi na limitach po stronie serwera i na zerwanym połączeniu. Do tego plik, który wygląda poprawnie w przeglądarce, potrafi być nieprzydatny w produkcji, bo ma złą przestrzeń barw albo brakuje w nim spadów. Wstępna kontrola po przyjęciu pliku jest tu częścią procesu, a nie dodatkiem, bo wykrycie takiego błędu przy przyjęciu zlecenia kosztuje minutę, a wykrycie go przy maszynie kosztuje cały nakład.
Piątym wyzwaniem była synchronizacja z systemami po stronie firmy: harmonogramami produkcji i danymi o dostępności materiałów. Rozwiązanie polega na tym, że aplikacja nie pyta systemu produkcyjnego w trakcie generowania strony. Dane są pobierane niezależnie i buforowane z czasem życia dobranym osobno do każdego źródła, bo harmonogram zmienia się inaczej niż tabela stawek. Najważniejsze jest jednak zachowanie awaryjne: gdy źródło jest niedostępne, widok pokazuje ostatnią znaną wartość albo wariant bez tej sekcji, a nie komunikat o błędzie. Odwiedzający nie ma powodu wiedzieć, że jeden z systemów wewnętrznych akurat nie odpowiada.
Narzędzia i technologie
Zaplecze stoi na PHP i MySQL, warstwa interaktywna na JavaScripcie i własnych punktach końcowych interfejsu, a szybkie ścieżki odczytu na cache w pamięci. Infrastruktura jest chmurowa, a kod prowadzony w systemie kontroli wersji, co przy tym projekcie ma konkretne znaczenie: tabela stawek jest daną, a reguły jej stosowania są kodem, i tylko rozdzielenie tych dwóch rzeczy pozwala zmienić cennik bez wdrożenia oraz zmienić regułę bez ruszania cennika.
Warstwa prezentacji opiera się na standardach responsywnych i preprocesorze arkuszy stylów, który utrzymuje punkty przełamania układu w jednym miejscu. W serwisie z formularzem o kilkunastu polach to nie jest kosmetyka. Formularz wyceny jest najważniejszym widokiem w tym projekcie i jednocześnie tym, który najtrudniej ułożyć na wąskim ekranie, bo pola są ze sobą powiązane, a zmiana jednego bywa widoczna w drugim.
Dostępność jako część oferty, nie tylko cecha strony
Warto odnotować rzecz, która w opisie wdrożenia zwykle nie pada. Have a Book zajmuje się konwersją publikacji do formatów elektronicznych z uwzględnieniem dostępności według WCAG, czyli sprzedaje kompetencję, którą serwis musi umieć pokazać. To ma konsekwencję prostą i niewygodną: strona firmy, która sprzedaje dostępne publikacje, nie może sama mieć katalogu nieobsługiwalnego z klawiatury ani tabel specyfikacji bez powiązania nagłówków z komórkami.
Tabela parametrów technicznych bez tego powiązania jest dla czytnika ekranu ciągiem liczb bez znaczenia, a w tym serwisie tabele specyfikacji są główną treścią. Podobnie jest z formularzem wyceny: pola powiązane ze sobą logicznie muszą być powiązane także w znacznikach, bo inaczej informacja o tym, że wybór oprawy ograniczył dostępne formaty, dociera wyłącznie wzrokowo i tylko do osoby, która akurat patrzy na właściwy fragment ekranu.
Wsparcie i rozwój serwisu
Utrzymanie obejmuje aktualizacje, monitorowanie i bieżące zmiany. W serwisie z kalkulatorem dochodzi do tego obowiązek, którego nie ma w zwykłej wizytówce: zmiany w strukturze stawek trzeba sprawdzać na danych historycznych. Zmiana, która wygląda poprawnie na jednym przykładzie, potrafi przestawić wynik przy innym progu nakładu, a zauważy to dopiero klient, który dostanie kwotę rozjeżdżającą się z tą sprzed tygodnia.
Aktualizacje idą najpierw na kopię produkcji, i to nie jest formalność. Pusta instalacja nie ma katalogu tej wielkości, nie ma czterech wersji językowych tego samego wpisu, nie ma galerii z plikami w rozdzielczości produkcyjnej i nie ma zestawu zapisanych wycen z różnych wersji cennika. Wszystkie cztery są tym, na czym psują się aktualizacje, i żadna z nich nie wystąpi w środowisku testowym zbudowanym od zera.
Kopie zapasowe podlegają tej samej regule co wszędzie: kopia, której nikt nigdy nie odtworzył, nie jest kopią, tylko plikiem. W tym projekcie dochodzi jeszcze jedno, bo pliki przesłane przez klientów są materiałem produkcyjnym, a nie treścią strony, i ich utrata jest zdarzeniem innej klasy niż utrata opisu usługi.
Przebieg wdrożenia
Wdrożenie zajęło około sześciu tygodni, licząc od ustalenia zakresu do publikacji. Układ i rozmieszczenie elementów dostarczył klient, więc czas poszedł na te części, których na makiecie nie widać: model treści rozdzielający język od rynku, strukturę stawek i reguły jej stosowania, punkty końcowe wyceny oraz przyjmowanie i sprawdzanie plików.
Testy szły na kopii produkcji. Przy kalkulatorze ma to szczególną wagę, bo poprawność wyceny nie jest cechą, którą widać na ekranie. Trzeba ją sprawdzić przez porównanie wyników z tym, co firma policzyłaby ręcznie, i trzeba to zrobić na progach, a nie w środku zakresów. Jeden przypadek testowy na parametr daje wrażenie pokrycia i nie mówi nic o zachowaniu przy przejściu między maszynami czy formatami arkusza.
Po starcie serwis wszedł w utrzymanie: aktualizacje, monitorowanie, zmiany w strukturze stawek i rozbudowa katalogu w miarę, jak zmieniała się oferta. Warto zaznaczyć, że wdrożenie pochodzi z 2015 roku i część rozwiązań, jak własna obsługa przesyłania dużych plików, była wtedy pracą do wykonania, a dziś w dużej mierze przejmują ją gotowe usługi.
Podsumowanie i analiza wymagań
Serwis haveabook.pl miał odpowiedzieć na cztery wymagania naraz. Po pierwsze na prezentację oferty, której nie da się opisać cennikiem, bo cena jest wynikiem działania na parametrach. Po drugie na obsługę czterech wersji językowych, w tym trzech skandynawskich, z regułami porządkowania tekstu właściwymi dla każdej z nich. Po trzecie na powiązanie z systemami po stronie firmy w sposób, który nie przenosi ich awarii na stronę. Po czwarte na przyjmowanie materiałów produkcyjnych, a nie tylko zamówień.
Z tych czterech wymagań wynika cała konstrukcja: liczenie po stronie serwera, wersjonowanie struktury stawek razem z zapisaną wyceną, cache z kluczem zawierającym tę wersję, rozdzielenie osi języka i rynku w modelu treści oraz warstwa dostarczania plików trzymana z dala od serwera aplikacji. Efektem jest serwis, który wspiera codzienną pracę wydawnictwa i drukarni, a nie tylko pokazuje, czym się zajmują.
Często zadawane pytania
Najważniejsze odpowiedzi, które pomagają wdrożyć temat w praktyce.
Jakiego zakresu dotyczył projekt haveabook.pl?
#Jak wyglądał przebieg prac przy haveabook.pl?
#Co było najtrudniejsze technicznie w haveabook.pl?
#Co z projektu haveabook.pl da się wykorzystać przy kolejnym wdrożeniu?
#Potrzebujesz FAQ dopasowanego do branży i rynku? Przygotujemy wersję pod Twoje cele biznesowe.
Porozmawiajmy