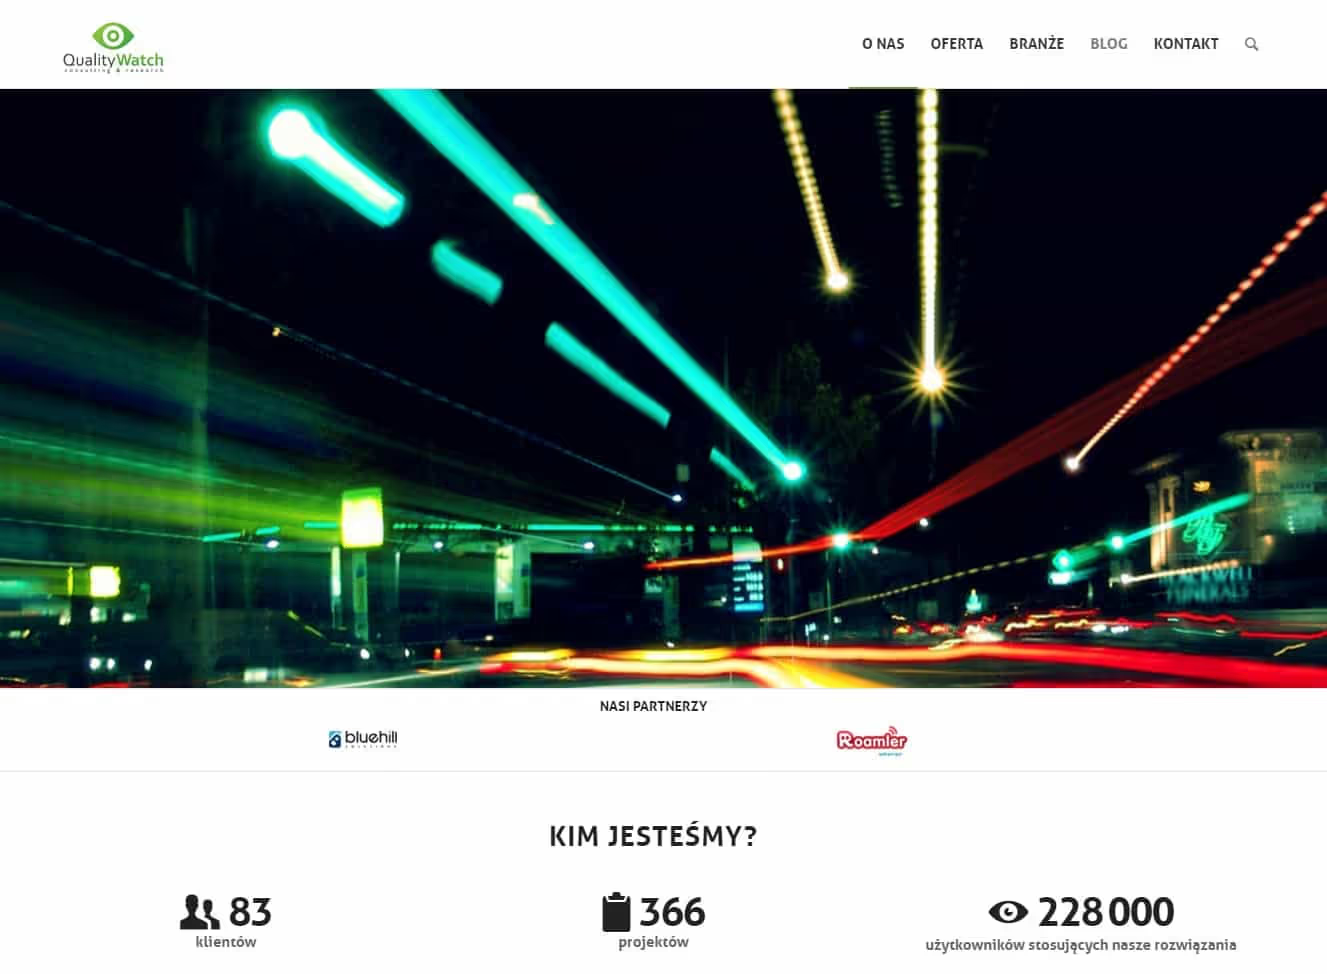
Projekt Quality Watch powstał po to, żeby pokazać ofertę firmy zajmującej się standardami obsługi klienta, zarządzaniem jakością, doświadczeniem klienta, mapowaniem ścieżki zakupowej i analityką customer intelligence. Quality Watch to warszawska agencja badawcza z siedzibą przy ulicy Franciszka Klimczaka, której podstawowym przedmiotem działalności są badania rynku i opinii publicznej, a najbardziej rozpoznawalną częścią oferty pozostaje Mystery Shopping oraz badania satysfakcji i testy wiedzy. Wdrożenie ruszyło w 2017 roku i zajęło około sześciu tygodni, z kategorii Strony www.
Dzięki tej stronie Quality Watch komunikuje wartość metod takich jak Mystery Shopper, Mystery Client, Mystery Caller czy Mystery E-mail, a odbiorca ma szansę zrozumieć, czym różnią się one od siebie, zanim napisze zapytanie ofertowe. To brzmi banalnie, dopóki nie zestawi się tych nazw obok siebie. Cztery z nich opisują ten sam mechanizm badawczy zastosowany do czterech różnych kanałów kontaktu, a piąta i szósta pozycja w cenniku to już zupełnie inny rodzaj usługi. Strona, która wrzuca to wszystko do jednej listy, zostawia czytelnika z wrażeniem, że firma robi dziesięć rzeczy naraz i żadnej konkretnie.
Kim jest odbiorca tej strony i co z tego wynika dla kodu
Zamawiającym badanie jakości obsługi rzadko bywa osoba, która sama podpisuje umowę. W praktyce po stronie klienta Quality Watch siedzi menedżer jakości albo dyrektor sieci sprzedaży, który zbiera materiał, żeby przekonać zarząd. To zmienia wymagania wobec serwisu bardziej, niż zmienia je jakakolwiek decyzja o kolorystyce. Treść musi dać się wyjąć ze strony i przenieść do wewnętrznej prezentacji: opis metody, zakres raportu, sposób doboru audytorów, przykładowa struktura wyników.
Stąd bierze się pierwszy wniosek techniczny. Nie potrzeba tu wodotrysków, potrzeba adresów URL, które przetrwają. Każda metoda badawcza dostała własny, stabilny adres, własny nagłówek H1 i własny zestaw danych strukturalnych. Podesłanie linku do jednej metody nie wymaga tłumaczenia, w którą zakładkę trzeba kliknąć po wejściu na stronę główną. Przy treści, która żyje w cudzych mailach i prezentacjach, trwałość adresu jest funkcją, a nie szczegółem konfiguracyjnym.
Druga konsekwencja dotyczy długości. Materiał konsultingowy tego typu jest z natury obszerny, bo klient chce wiedzieć, jak wygląda scenariusz wizyty audytora i czym różni się wizyta w salonie samochodowym od telefonu do infolinii. Jednocześnie ten sam materiał musi dać się przejrzeć w dwie minuty przez kogoś, kto dopiero szuka wykonawcy. Rozwiązaniem nie jest skracanie, tylko warstwowanie: krótkie streszczenie metody na wierzchu, szczegóły dostępne bez przeładowania strony.
Model treści, czyli najtrudniejsza część tego wdrożenia
Warstwowanie treści wygląda w kodzie inaczej, niż wygląda w opisie. Najprostsze podejście, czyli wrzucenie całości do jednej długiej strony i chowanie fragmentów w akordeonie, działa do momentu, w którym firma zaczyna sprzedawać tę samą metodę na kilku rynkach. Wtedy okazuje się, że opis Mystery Shoppingu dla handlu detalicznego i dla sektora motoryzacyjnego różnią się w trzech akapitach na dwadzieścia, a zredagowanie ich osobno oznacza trzy miejsca, w których ten sam błąd trzeba poprawić trzy razy.
Dlatego model treści rozdzielił metodę od zastosowania. Metoda jest jednym rekordem i opisuje mechanizm: kto prowadzi obserwację, w jakim wcieleniu, co notuje i w jakiej formie wraca wynik. Zastosowanie jest osobnym rekordem i opisuje kontekst branżowy. Strona łączy jedno z drugim w chwili wyświetlenia. Koszt tego rozwiązania jest realny i warto go nazwać wprost: redaktor musi zrozumieć podział, zanim doda nowy tekst, a dodanie nietypowego przypadku bywa wolniejsze niż wklejenie gotowego akapitu. Zysk pojawia się po roku, przy piętnastym wariancie opisu.
Trzecim typem treści są studia przypadku, i to one wymusiły najwięcej ustaleń poza kodem. Agencja badawcza operuje danymi, których w większości nie wolno jej pokazać z nazwy klienta. Struktura rekordu musiała więc przewidzieć wersję anonimową jako stan domyślny, a nie jako wyjątek: branża i skala sieci są polami osobnymi, nazwa marki polem opcjonalnym. Kiedy nazwa jest pusta, szablon nie zostawia pustego miejsca po logotypie, tylko układa kafelek inaczej. Brzmi to jak drobiazg do momentu, w którym połowa listy referencyjnej ma puste pole.
Po co AJAX i REST API na stronie wizerunkowej
Rozbudowane mechanizmy AJAX i dedykowane endpointy REST API to w 2017 roku nie była oczywista decyzja dla serwisu ofertowego i nie każdemu projektowi bym ją wtedy polecił. Tutaj wynikała z kształtu oferty. Portfolio usług Quality Watch jest szerokie i mocno przecinające się, więc odbiorca nie przechodzi przez nie liniowo. Otwiera Mystery Shopping, wraca, sprawdza Mystery Caller, porównuje zakres raportu, wraca jeszcze raz. Każde takie przejście przy klasycznym przeładowaniu strony kosztuje pełny cykl: nowe żądanie, renderowanie szablonu, ponowne pobranie tych samych zasobów.
Przy filtrowaniu listy usług przez REST API przeglądarka pobiera tylko dane, których wcześniej nie miała. Reszta układu zostaje. Koszt tej decyzji jest jednak dwojaki i nie da się go ukryć. Po pierwsze, trzeba zadbać, żeby każdy stan filtra miał własny adres, bo inaczej użytkownik nie prześle koledze tego, co właśnie ogląda, a wyszukiwarka nie zindeksuje niczego poza stanem domyślnym. Po drugie, warstwa danych musi działać bez JavaScriptu, bo strona konsultingowa bywa otwierana w środowiskach korporacyjnych z restrykcyjną polityką przeglądarki. Widok podstawowy renderuje się więc po stronie serwera, a AJAX jedynie skraca drogę tam, gdzie jest dostępny.
Endpointy REST API przydały się jeszcze w jednym miejscu, mniej widocznym. Opinie klientów i wyniki badań publikowane na stronie zmieniają się częściej niż sama oferta i mają inny cykl akceptacji wewnętrznej. Wyniesienie ich do osobnego zasobu oznaczało, że aktualizacja nie wymaga dotykania szablonów stron usługowych ani unieważniania ich pamięci podręcznej.
Wydajność pod realnym ruchem i dlaczego test na pustej instalacji kłamie
Wąskim gardłem tego wdrożenia była wydajność przy realnym ruchu i zachowanie pamięci podręcznej, nie zaś sam czas ładowania strony głównej. Różnica jest istotna. Pusta instalacja WordPressa z tym samym motywem odpowiada szybko, ponieważ nie ma czego liczyć: baza jest mała, powiązania płytkie, a lista usług mieści się w jednym zapytaniu. Ten sam kod na kopii produkcji, z pełnym katalogiem metod, zastosowań, studiów przypadku i taksonomii, zachowuje się zupełnie inaczej, bo złożenie listy z filtrami dotyka kilku tabel naraz.
Dlatego ścieżki, którymi idzie ruch, sprawdzałem na kopii produkcji, a nie na czystym środowisku. To reguła, która kosztuje kilka godzin przygotowania i oszczędza tydzień zdziwienia po starcie. Kopia produkcji ujawnia rzeczy, których nie ma na pustej instalacji: zapytanie, które przy trzech rekordach jest niezauważalne, a przy dwustu robi się najdroższą operacją na stronie, albo cache, który technicznie działa, ale jest unieważniany przy każdym zapisie dowolnej treści, więc w praktyce nie istnieje.
Napięcie architektoniczne leży tu na styku pamięci podręcznej i świeżości treści. Strona ofertowa może być trzymana w cache agresywnie, bo zmienia się rzadko. Sekcja z aktualnościami i opiniami zmienia się często i redaktor oczekuje, że zobaczy swoją zmianę od razu. Rozstrzygnięcie polegało na rozdzieleniu tych dwóch rzeczy: szkielet i strony usług są cache’owane długo, a fragmenty zmienne dociągane osobnym żądaniem, z krótkim czasem życia i unieważnianiem punktowym przy zapisie konkretnego rekordu, a nie globalnie.
Układ dostarczył klient, kolejność informacji ustalaliśmy razem
Rozmieszczenie elementów i warstwa wizualna przyszły od klienta. Naszą częścią było przełożenie tego na szablony, zachowanie responsywne i model treści, który da się utrzymywać po starcie. Estetyka nie była przedmiotem sporu, kolejność informacji owszem, i to jest zwykle jedyna rozmowa warta prowadzenia przy tego typu projekcie.
Strona jest responsywna nie dlatego, że tak wypada, tylko dlatego, że w tej branży spora część ruchu to ktoś, kto dostał link w mailu i otwiera go na telefonie między spotkaniami. Na małym ekranie kolejność sekcji przestaje być kwestią gustu, bo użytkownik zobaczy pierwsze dwa ekrany i albo zrozumie, czym jest ta firma, albo wróci do skrzynki. Technologie warstwy frontendowej, czyli HTML5, CSS3 z preprocesorem SASS i JavaScript, dają czytelny układ i stabilne działanie, ale nie rozstrzygają za nikogo, co ma stać wyżej.
Osobnym tematem była dostępność tabel porównawczych. Zestawienie metod badawczych jest w tym serwisie główną treścią, a tabela bez powiązania nagłówków z komórkami jest dla czytnika ekranu ciągiem słów bez struktury. To poprawka tania w implementacji i kosztowna w dorabianiu po fakcie, więc weszła od razu.
Formularze i to, co dzieje się z zapytaniem po kliknięciu
Serwis agencji badawczej zbiera zapytania o wycenę, a nie zamówienia, i ta różnica ma swoje konsekwencje w kodzie. Zapytanie o badanie jakości obsługi nie daje się sprowadzić do trzech pól, bo wycena zależy od liczby placówek, liczby wizyt w cyklu, kanałów objętych badaniem i tego, czy klient chce raport zbiorczy, czy rozbicie na lokalizacje. Formularz, który pyta o wszystko naraz, zniechęca. Formularz, który pyta o nic, generuje zapytania, na które i tak trzeba odpowiedzieć pytaniem.
Kompromis polegał na rozdzieleniu pierwszego kontaktu od kwalifikacji. Pola obowiązkowe są krótkie, a rozszerzenia pojawiają się tylko wtedy, gdy odbiorca sam wskaże, że wie, czego szuka. Po stronie technicznej to oznacza walidację po serwerze, a nie wyłącznie w przeglądarce, bo walidacja po stronie klienta jest wygodą użytkownika, a nie zabezpieczeniem. Oznacza też ochronę antyspamową, która nie opiera się na przepisywaniu znaków z obrazka, ponieważ w tym akurat serwisie każdy dodatkowy krok na ścieżce kosztuje zapytanie ofertowe.
Osobną decyzją było ograniczenie długości pola tekstowego dopiero na poziomie, który nie ucina realnej wiadomości. Wydaje się to trywialne, ale krótkie ograniczenie w polu opisu potrafi po cichu skrócić zapytanie w połowie zdania, a nadawca nigdy się o tym nie dowie, bo widzi tylko potwierdzenie wysyłki. To błąd, którego nie widać w logach ani w testach, tylko w rozmowie, która nie doszła do skutku.
Dane strukturalne i to, czego wyszukiwarka nie zgadnie sama
Architektura serwisu została przygotowana pod SEO i dane strukturalne, co przy tego rodzaju treści znaczy coś konkretnego, a nie ogólnego. Wyszukiwarka sama z siebie nie odróżni opisu metody badawczej od artykułu blogowego o tej metodzie, a to dwa różne zamiary czytelnika i dwa różne wyniki wyszukiwania. Oznaczenie typu treści w danych strukturalnych jest tanie na etapie budowy szablonu i praktycznie niemożliwe do dorobienia sensownie, kiedy pięćdziesiąt stron już żyje w indeksie z niewłaściwym typem.
Drugi obszar to nazewnictwo. Firma używa terminów, które w polskim internecie mają kilka pisowni naraz, bo część z nich to kalki z angielskiego przyjęte przez branżę w różnych wariantach. Strona musi trafić w język odbiorcy, a nie w preferencję redaktora, i jednocześnie nie może rozsypywać tej samej treści na cztery adresy różniące się odmianą słowa. Rozwiązaniem był jeden adres kanoniczny na metodę i konsekwentne odmiany w treści, zamiast osobnej strony na każdy wariant frazy.
Trzecia rzecz dotyczy tego, co strona mówi o sobie maszynie. Karta faktów w danych strukturalnych opisuje, czym jest to wdrożenie, jaki ma zakres i na czym stoi. To kosztuje kilka linii w szablonie, a decyduje o tym, czy model językowy streszczający tę stronę powtórzy zakres prac, czy zmyśli go na podstawie okładki.
Co się w tym projekcie nie udało od pierwszego podejścia
Warto nazwać rzecz, która wymagała poprawki już po starcie, bo bez tego opis wdrożenia zamienia się w folder reklamowy. Pierwsza wersja filtrowania listy usług zapamiętywała stan wyboru w adresie, ale nie zapamiętywała pozycji przewinięcia. Odbiorca, który przeszedł do opisu metody i wrócił przyciskiem wstecz, lądował na górze listy i musiał szukać miejsca, w którym był. Na liście złożonej z sześciu pozycji to niezauważalne. Na liście, która po dodaniu zastosowań branżowych urosła do kilkudziesięciu, jest to powód, dla którego ktoś przestaje przeglądać.
Druga poprawka dotyczyła obrazów. Zdjęcia w sekcjach referencyjnych były wgrywane w rozdzielczości, w jakiej przyszły od klienta, czyli znacznie większej niż jakikolwiek widok na stronie. System generuje warianty rozmiarowe automatycznie, ale tylko dla obrazów wgranych po włączeniu odpowiedniej konfiguracji, więc materiały przeniesione ze starego serwisu zostały z oryginałami. Wykrycie tego wymagało spojrzenia na rozmiar transferu konkretnej podstrony, a nie na wynik pomiaru strony głównej, która akurat była lekka.
Trzecia rzecz nie była błędem, tylko kompromisem, który do dziś uważam za słuszny, choć kosztownym. Zrezygnowaliśmy z rozbudowanego mechanizmu personalizacji treści pod branżę odwiedzającego. Technicznie było to wykonalne i brzmiało atrakcyjnie, ale wymagałoby rozróżniania odwiedzających na poziomie, na którym cache przestaje mieć sens, a wartość dla odbiorcy byłaby widoczna dopiero przy ruchu o rząd wielkości większym niż realny. Zamiast tego branża jest wyborem, który użytkownik robi świadomie, w jednym kliknięciu, i ten wybór da się przesłać dalej linkiem.
Wsparcie techniczne po starcie
Żeby utrzymać serwis na poziomie, na którym został oddany, prowadzimy wsparcie techniczne obejmujące regularne aktualizacje, monitoring logów, systematyczne tworzenie kopii zapasowych oraz bieżące modyfikacje funkcjonalne. Aktualizacje trafiają najpierw na środowisko testowe, bo na stronie z dedykowanym motywem i własnymi endpointami to właśnie one, a nie sam rdzeń WordPressa, bywają miejscem, w którym coś się rozjeżdża po podbiciu wersji.
Z tego wdrożenia przenosi się na kolejne projekty warstwa techniczna: JavaScript, HTML5, CSS3, SASS oraz AJAX wyglądają podobnie za każdym razem. Nie przenosi się model treści ani integracje, bo powstały pod dane jednego klienta i pod konkretny brief. Kolejne wdrożenie zaczyna się więc od analizy zakresu, a wycena idzie po niej, nie przed nią.
Klient: Quality Watch
Zakres prac: Web development, layout
Aby dowiedzieć się więcej, odwiedź stronę: qualitywatch.pl
Często zadawane pytania
Najważniejsze odpowiedzi, które pomagają wdrożyć temat w praktyce.
Jakiego zakresu dotyczył projekt QUALITY WATCH?
#Jak wyglądał przebieg prac przy QUALITY WATCH?
#Co było najtrudniejsze technicznie w QUALITY WATCH?
#Co z projektu QUALITY WATCH da się wykorzystać przy kolejnym wdrożeniu?
#Potrzebujesz FAQ dopasowanego do branży i rynku? Przygotujemy wersję pod Twoje cele biznesowe.
Porozmawiajmy