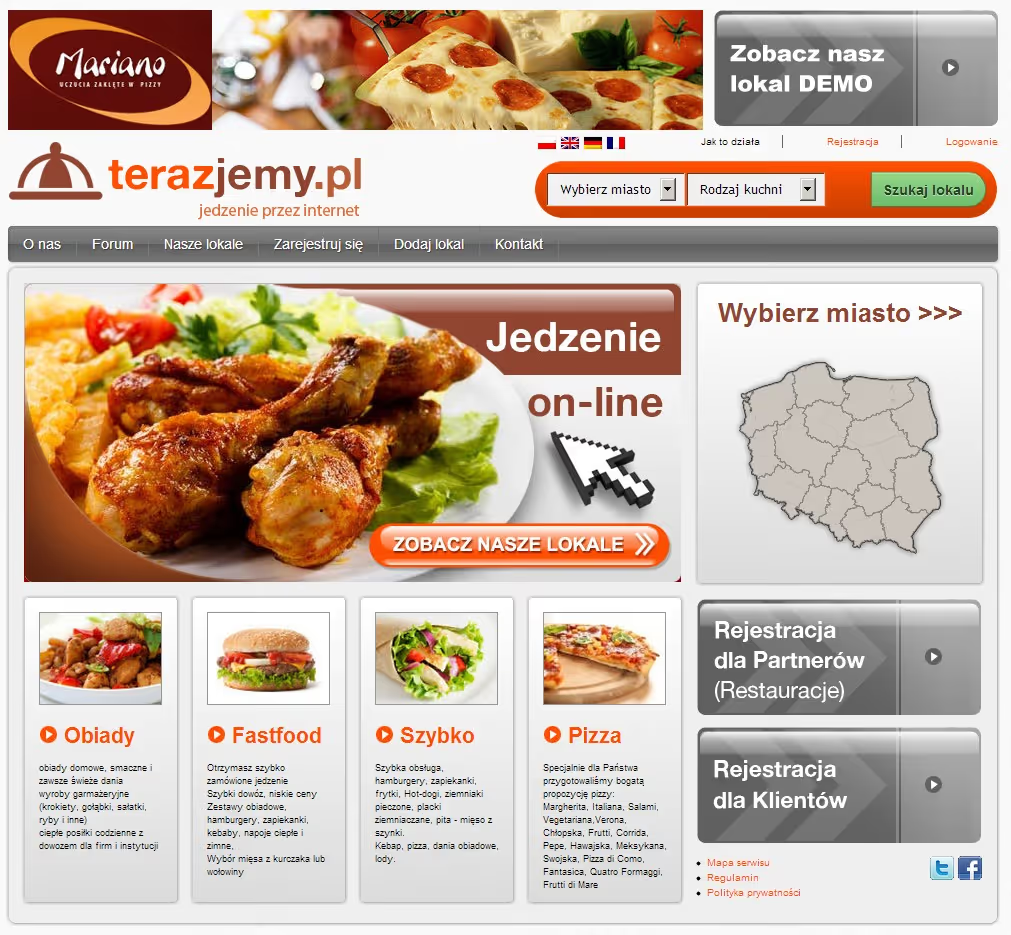
Przepis nie jest artykułem
Terazjemy.pl był serwisem o zdrowym odżywianiu i aktywności fizycznej, z przepisami, artykułami poradnikowymi i materiałami edukacyjnymi. Witryna nie działa już od jakiegoś czasu, więc poniżej opisuję decyzje projektowe, a nie stan bieżący. Wdrożenie oddaliśmy w 2012 roku i zajęło ono około sześciu tygodni.
Pierwsza rzecz, którą trzeba rozstrzygnąć w takim projekcie, jest mniej oczywista, niż wygląda. Przepis wygląda na artykuł: ma tytuł, zdjęcie i tekst. Zachowuje się jednak zupełnie inaczej. Artykuł czyta się raz, od góry do dołu. Przepis czyta się na dwa razy, najpierw w sklepie po listę składników, potem w kuchni po kolejność czynności, przy czym drugi raz odbywa się przy zabrudzonych rękach i wygaszającym się ekranie. Artykuł ma jednego autora i jedną datę. Przepis ma czas przygotowania, liczbę porcji, poziom trudności, listę składników z ilościami i zestaw etykiet dietetycznych, i wszystkie te rzeczy są pytaniami wyszukiwania, a nie ozdobą.
Dlatego przepis nie mógł być zwykłym wpisem z tekstem. Musiał mieć własną strukturę, w której składniki są listą pozycji z ilością i jednostką, kroki są uporządkowaną sekwencją, a czas, porcje i kategorie dietetyczne leżą w osobnych polach. Dopiero taka struktura pozwala odpowiedzieć na pytanie w rodzaju “obiad bezglutenowy do trzydziestu minut”, i dopiero taka struktura da się opisać danymi strukturalnymi w sposób, który wyszukiwarka faktycznie rozumie.
Jednostki, czyli miejsce, w którym polska kuchnia komplikuje sprawę
Kiedy składniki są osobnymi pozycjami, pojawia się problem, którego nie ma w tekstowym przepisie: trzeba zdecydować, czym jest jednostka. W polskich przepisach obok gramów i mililitrów żyją szklanka, łyżka, łyżeczka, szczypta i dekagram, przy czym dekagram jest jednostką, której poza polską kuchnią właściwie nikt nie używa, a w starszych przepisach domowych stoi zupełnie normalnie. Szklanka z kolei nie ma jednej pojemności i oznacza co innego przy mące, a co innego przy kaszy, bo w obu przypadkach chodzi o objętość, a czytelnik myśli o wadze.
Można to rozwiązać na dwa sposoby i oba mają cenę. Można wymusić jednostki metryczne i przeliczyć wszystko, co daje spójne dane i przepisy brzmiące jak instrukcja laboratoryjna. Można zostawić jednostki takie, jakie wpisała autorka, co daje naturalny język i uniemożliwia automatyczne przeliczanie porcji. Wybraliśmy trzecią drogę: jednostka jest polem z listy zamkniętej, a przy tych, które da się przeliczyć na metryczne, przelicznik jest zapisany obok. Dzięki temu przepis wyświetla się tak, jak został napisany, a mechanizm skalowania porcji działa wszędzie tam, gdzie ma czym operować, i jawnie odpuszcza tam, gdzie nie ma.
Skalowanie porcji jest zresztą funkcją, która wygląda na banalną, a rzadko bywa zrobiona porządnie. Podwojenie liczby porcji nie podwaja czasu pieczenia i nie podwaja szczypty soli. Mechanizm, który mnoży wszystko przez dwa, produkuje przepisy niemożliwe do wykonania, więc przeliczaniu podlegają wyłącznie pozycje z ilością liczbową i jednostką miary, a czas i wskazówki opisowe zostają nietknięte.
Ruch w serwisie kulinarnym ma kalendarz
Serwis z przepisami nie ma równomiernego ruchu. Ma wyraźne szczyty w okolicach świąt, a w polskich warunkach największym z nich jest Wigilia, ze wzrostem zainteresowania potrawami, których przez pozostałe jedenaście miesięcy nikt nie szuka. Drugi szczyt przypada na początek stycznia, kiedy zmienia się nie potrawa, tylko intencja: ludzie szukają tych samych dań w wersji lżejszej.
To ma dwie konsekwencje techniczne. Pierwsza dotyczy wydajności: obciążenie nie rozkłada się na rok, więc konfiguracja, która wystarcza w marcu, może nie wystarczyć w tygodniu przed świętami, i to na kilku konkretnych adresach, a nie na całym serwisie. Ruch wchodzi wtedy wąskim strumieniem na kilkanaście stron, co z jednej strony jest groźne, a z drugiej łatwe do obsłużenia, bo te same kilkanaście stron da się wcześniej rozgrzać w pamięci podręcznej.
Druga konsekwencja dotyczy treści. Materiał sezonowy, który leży w serwisie przez rok, nie jest martwy, tylko uśpiony, więc kasowanie go po sezonie jest błędem. Zamiast tego przepisy sezonowe mają datę pierwszej publikacji i datę ostatniej aktualizacji, a w okresie, w którym są szukane, wracają na widoczne miejsca przez powiązania tematyczne, a nie przez ponowne publikowanie tego samego tekstu pod nową datą.
Zdjęcia jedzenia i to, ile naprawdę ważą
Zdjęcie potrawy jest w tym serwisie treścią, nie ilustracją. Przepis bez zdjęcia praktycznie nie działa, bo czytelnik podejmuje decyzję wzrokiem, zanim przeczyta listę składników. Zdjęcia kulinarne są przy tym wyjątkowo kosztowne transmisyjnie: mają dużo faktury, mało płaskich obszarów i źle się kompresują, a często występują w kilku ujęciach.
Praca wydajnościowa poszła więc tam, gdzie leżała masa. Pliki są przetwarzane przy wgraniu na zestaw rozmiarów odpowiadających miejscom, w których faktycznie się pojawiają: kafel na liście, zdjęcie główne przepisu, ewentualne ujęcia etapów. Miniatura na liście nigdy nie jest zdjęciem głównym przeskalowanym w przeglądarce, bo takie przeskalowanie oszczędza piksele, a nie transfer.
Obrazy poniżej pierwszego ekranu ładują się dopiero, gdy zbliżają się do widoku. Warto jednak zaznaczyć granicę tej techniki, bo bywa stosowana bez zastanowienia: zdjęcie główne przepisu jest zwykle najważniejszym elementem pierwszego ekranu, więc opóźnianie właśnie jego pogarsza odbiór strony zamiast go poprawiać. Leniwe ładowanie ma sens poniżej zgięcia, a nie na elemencie, na który czytelnik czeka.
Dane strukturalne i to, co dostaje wyszukiwarka
Przepis jest jednym z nielicznych typów treści, dla których wyszukiwarki mają osobne, rozbudowane traktowanie. Opis strukturalny przepisu obejmuje składniki, kroki, czas przygotowania i gotowania, liczbę porcji i informacje żywieniowe, a poprawnie opisany przepis pojawia się w wynikach inaczej niż zwykły artykuł.
Kluczowa rzecz w tym miejscu jest jednak organizacyjna, nie techniczna. Dane strukturalne mają sens tylko wtedy, gdy powstają z tego samego źródła co treść widoczna. Jeżeli redakcja wpisuje składniki w tekst, a ktoś osobno uzupełnia pola dla wyszukiwarki, to te dwa zestawy rozjadą się w ciągu kilku miesięcy, i rozjadą się po cichu, bo nikt nie czyta danych strukturalnych okiem. Dlatego pola przepisu są jedynym miejscem wprowadzania danych, a zarówno widok dla człowieka, jak i opis dla wyszukiwarki, są z nich generowane.
Ta sama zasada ratuje przed drugim typowym błędem. Informacja żywieniowa podana jako liczba jest twierdzeniem o konkretnej potrawie i zależy od produktów, których użyto, więc pole na nią jest opcjonalne i puste, dopóki ktoś świadomie go nie wypełni. Pole, które domyślnie wstawia wyliczoną wartość, produkuje dane wyglądające na pomiar, którym nie są.
Zapis na newsletter i to, czego nie widać w formularzu
Serwis zbierał adresy do newslettera, i to jest ta część, w której najczęściej robi się skrót. Formularz z polem na adres i przyciskiem da się postawić w kwadrans. Problem zaczyna się poniżej.
Adres podany w formularzu nie jest zgodą, tylko deklaracją, i dopóki nie zostanie potwierdzony kliknięciem w link z wiadomości, nie wiadomo nawet, czy należy do osoby, która go wpisał. Dlatego zapis jest dwuetapowy: wpisanie adresu tworzy wpis oczekujący, a dopiero potwierdzenie czyni z niego subskrypcję. Bez tego kroku każdy może zapisać cudzy adres, a lista rośnie o pozycje, które przy pierwszej wysyłce zamieniają się w zgłoszenia nadużycia.
Równie ważne jest wyjście. Link rezygnacji musi działać bez logowania i bez formularza, w jednym kliknięciu, bo każda przeszkoda postawiona na tej drodze przenosi rezygnację do przycisku zgłaszania spamu w kliencie pocztowym, a to kosztuje znacznie więcej niż utrata jednego adresu.
Sama wysyłka nie może odbywać się w trakcie żądania od użytkownika. Wysyłka do listy trwa i zawodzi w sposób, na który nie ma wpływu ktoś siedzący przed formularzem. Zadania tego rodzaju trafiają więc do kolejki i są wykonywane poza żądaniem, z możliwością ponowienia, bo chwilowa odmowa serwera pocztowego nie powinna oznaczać, że wiadomość przepadła.
Wydajność, czyli co właściwie cache’ujemy
Serwis treściowy jest z punktu widzenia pamięci podręcznej przypadkiem wdzięcznym: prawie wszystko, co pokazuje, jest takie samo dla wszystkich odwiedzających i zmienia się rzadko. Dlatego zysk bierze się tu głównie z tego, żeby żądanie o gotowy przepis w ogóle nie schodziło do PHP.
Elementy, które faktycznie się zmieniają, są nieliczne i dają się wyliczyć: licznik komentarzy, blok najnowszych wpisów, stan zalogowania. Każdy z nich, wstawiony bezpośrednio w dokument, unieważnia cache całej strony. Dlatego są wydzielone i dociągane osobno, co brzmi jak komplikacja, a jest dokładnie odwrotnie: pozwala trzymać resztę strony w pamięci podręcznej długo, zamiast odświeżać ją za każdym razem, gdy ktoś skomentuje.
Redis obsługuje tu warstwę pod spodem, czyli wyniki zapytań, które powtarzają się na wielu stronach: listy kategorii, powiązania między przepisami, agregaty tagów dietetycznych. To nie są rzeczy kosztowne pojedynczo, tylko rzeczy liczone przy każdym wyświetleniu, a taki koszt widać dopiero pod ruchem, nie na testach na pustej instalacji.
Unieważnianie pamięci podręcznej jest w tym układzie trudniejsze niż jej zapełnianie. Publikacja jednego przepisu zmienia nie tylko jego stronę, ale też listę kategorii, stronę główną, blok powiązanych i mapę witryny. Jeżeli czyszczone jest tylko to pierwsze, reszta serwisu przez godzinę udaje, że nowego przepisu nie ma. Jeżeli czyszczone jest wszystko, każda publikacja kasuje pracę cache dla całego serwisu. Rozsądny środek polega na czyszczeniu tego, co faktycznie zależy od zmienionego obiektu, i to musi być wypisane wprost przy budowie, bo domyślnie żaden mechanizm tego nie wie.
Kopie zapasowe i ciągłość
Kopie zapasowe były wykonywane automatycznie i składowane poza serwerem serwisu, z wersjonowaniem, żeby dało się wrócić nie tylko do stanu sprzed awarii, ale też do stanu sprzed pomyłki redakcyjnej sprzed kilku dni. Te dwa scenariusze są różne i tylko drugi zdarza się często.
Warto przy tym powtórzyć rzecz, która w opisach wdrożeń zwykle nie pada. Kopia, której nikt nigdy nie odtworzył, jest hipotezą, a nie zabezpieczeniem. Odtworzenie trzeba wykonać przynajmniej raz, na osobnym środowisku, żeby wiedzieć, ile trwa i czego w niej brakuje, bo braki w kopiach mają to do siebie, że ujawniają się wyłącznie przy odtwarzaniu.
Utrzymanie i kierunki, których nie zrealizowano
Opieka nad serwisem obejmowała aktualizacje silnika, motywu i wtyczek, przegląd logów, monitorowanie indeksowania i porządkowanie zapytań do bazy, które rosły wraz z liczbą przepisów. Testy szły przez środowisko z kopią realnych danych, bo serwis z kilkuset przepisami i rozbudowanymi taksonomiami zachowuje się zupełnie inaczej niż czysta instalacja z motywem demonstracyjnym.
W planach, które nigdy nie doszły do realizacji, były moduł planowania posiłków, integracja z aplikacjami dietetycznymi i część społecznościowa. Piszę o nich jako o kierunkach, a nie o funkcjach, bo żadna z nich nie powstała. Każda z tych trzech rzeczy zmieniałaby zresztą charakter projektu: plan posiłków wprowadza dane należące do konkretnej osoby, integracja z aplikacją dietetyczną wprowadza zależność od cudzego interfejsu, a część społecznościowa wprowadza moderację, czyli stałą pracę ludzką, której serwis treściowy do tej pory nie potrzebował.
Co przenosi się dalej
Przenosi się sposób pracy: traktowanie przepisu jako danych, a nie jako tekstu, jedno źródło dla widoku i dla danych strukturalnych, rozdzielenie treści stabilnej od elementów zmiennych przy planowaniu pamięci podręcznej, kolejka na wszystko, co wychodzi poza serwis, oraz testy na kopii produkcji.
Nie przenosi się model treści tego projektu, bo powstał pod jedną redakcję i pod brief z kategorii Strony www. Zestaw pól przepisu odzwierciedla decyzje redakcyjne konkretnego zespołu, a zestaw etykiet dietetycznych to rozstrzygnięcie merytoryczne, nie techniczne. Kolejne wdrożenie zaczyna się więc od analizy zakresu, a wycena idzie po niej.
Często zadawane pytania
Najważniejsze odpowiedzi, które pomagają wdrożyć temat w praktyce.
Jakiego zakresu dotyczył projekt terazjemy.pl?
#Jak wyglądał przebieg prac przy terazjemy.pl?
#Co było najtrudniejsze technicznie w terazjemy.pl?
#Co z projektu terazjemy.pl da się wykorzystać przy kolejnym wdrożeniu?
#Potrzebujesz FAQ dopasowanego do branży i rynku? Przygotujemy wersję pod Twoje cele biznesowe.
Porozmawiajmy