Prognozy Thorstena Balla i dane, na których je sprawdzamy
19 września 2026 roku Thorsten Ball opublikował na X krótki wpis: większość prognoz, które widzi, jest jego zdaniem wciąż o wiele za ostrożna, więc podaje własne. Do wpisu dołączył notatkę zatytułowaną “What I believe about the future of software development” z 16 tezami. Ball jest współzałożycielem i współtwórcą Amp, wcześniej pracował w Sourcegraph i w Zed, wydał własnym nakładem dwie książki o programowaniu. To nie jest głos z zewnątrz branży.
Tezy są ostre: code review umrze, testy jednostkowe mogą umrzeć, terminal nie żyje, open source w obecnej formie nie ma sensu. Odpowiadamy na każdą z nich osobno, z oceną: zgadzamy się, zgadzamy się częściowo albo się nie zgadzamy.
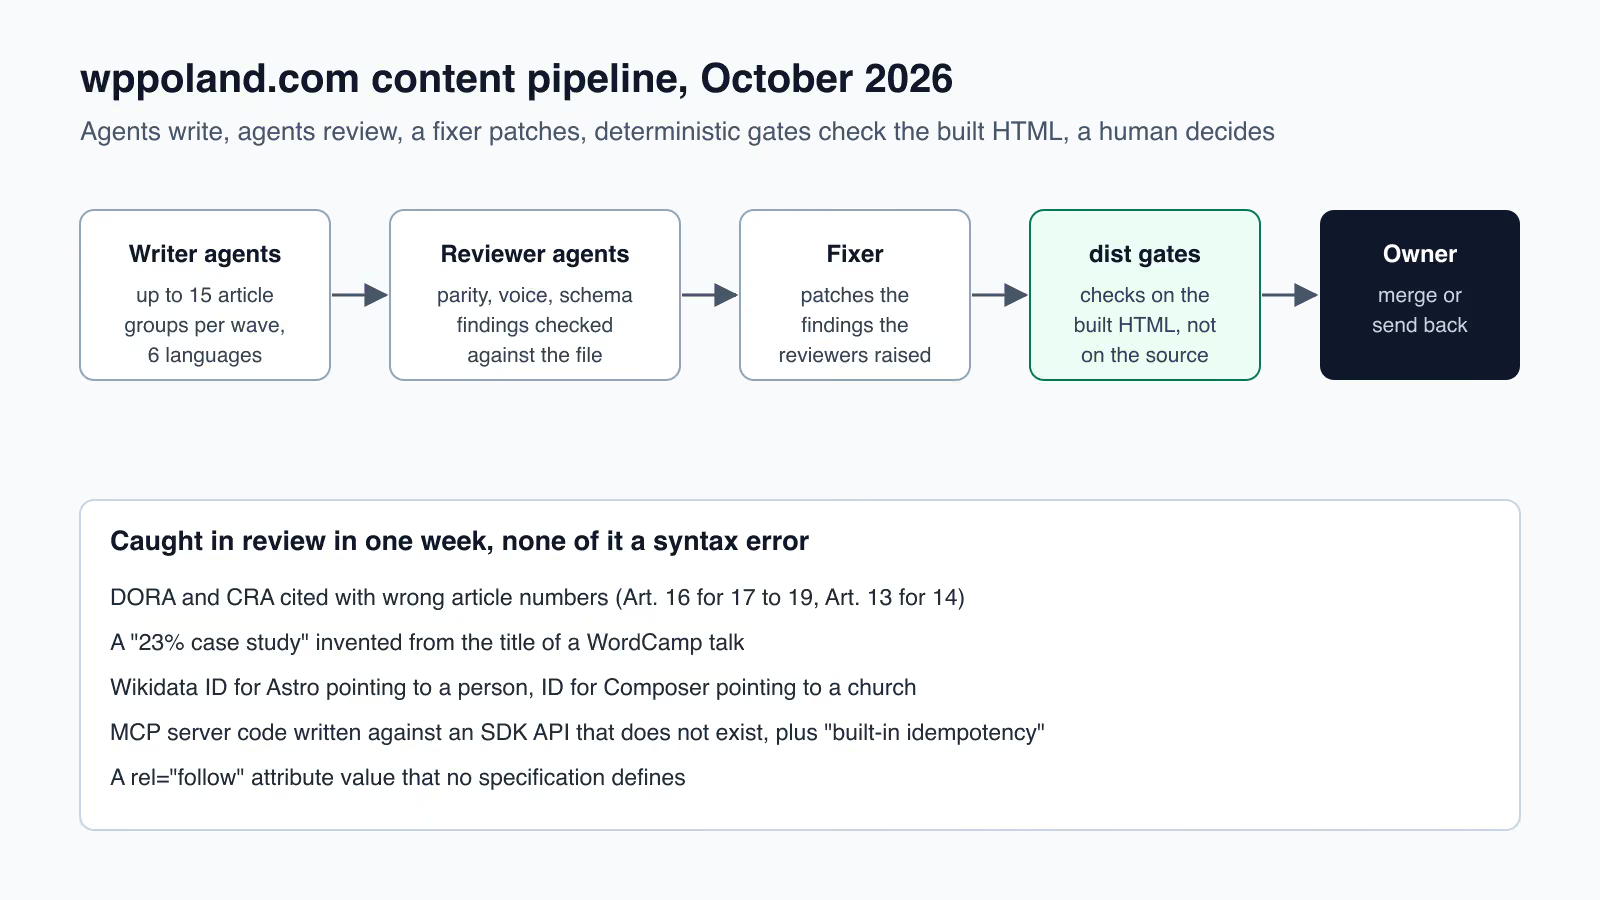
Nasze dowody pochodzą z jednego miejsca, które znamy z bliska: z potoku agentów AI, który w październiku 2026 roku rozbudowuje treści tego serwisu. Agenci piszący pracują równolegle i w jednej fali obsługują do 15 grup artykułów w sześciu językach. Według historii repozytorium fala 20 z 15 października objęła 14 grup i 85 plików. Niezależni agenci recenzujący sprawdzają zgodność wersji językowych, styl i dane strukturalne, a osobny agent poprawia to, co zgłosili. Na końcu bramki uruchamiane na zbudowanym HTML decydują, czy zmiana w ogóle może trafić dalej. Schemat jest na ilustracji na górze strony.
Potok pracuje na żywym serwisie z tysiącami stron, więc błąd agenta, którego nikt nie złapie, trafia prosto do wyszukiwarki. Dlatego nasze zdanie o przyszłości programowania jest węższe niż Balla, ale oparte na tym, co sami widzieliśmy w ostatnim tygodniu.
Przyszłość programowania według Thorstena Balla w skrócie
Poniżej wszystkie tezy z notatki w kolejności autora, z naszą oceną. Każdą rozwijamy w dalszej części tekstu.
| Teza Thorstena Balla | Nasza ocena |
|---|---|
| Code review umrze | Nie zgadzamy się, recenzja zmienia przedmiot |
| Testy jednostkowe mogą umrzeć | Nie zgadzamy się |
| Rzemiosło pisania kodu zniknie | Zgadzamy się częściowo |
| Rzemiosło budowania oprogramowania będzie ważniejsze niż kiedykolwiek | Zgadzamy się |
| Większość błędów to “poprosiłeś o złą rzecz” | Zgadzamy się |
| Open source w obecnej formie nie ma sensu | Nie zgadzamy się |
| Wkład ludzi w wydajność zostanie przypadkiem brzegowym | Zgadzamy się częściowo |
| Terminal nie żyje | Nie zgadzamy się |
| Tokeny to nowy paradygmat obliczeniowy | Zgadzamy się częściowo |
| Triada PM, design, inżynieria zniknie | Zgadzamy się częściowo |
| Przepaść między dużymi a małymi firmami wzrośnie | Zgadzamy się częściowo |
| Nie ma dowodu, że “dobry kod” będzie miał znaczenie | Zgadzamy się częściowo |
| Część ludzi nie będzie stać na wytwarzanie oprogramowania | Zgadzamy się częściowo |
| Wątpliwe, czy tańsze modele będą używane | Zgadzamy się |
| UI będzie generowany w locie | Brak danych po naszej stronie |
| To potrwa pokolenie | Zgadzamy się |
Bilans: w czterech punktach przyznajemy Ballowi rację, w czterech się z nim nie zgadzamy, w siedmiu widzimy kierunek, ale nie skalę, a w jednym nie mamy danych.
Czy code review ma sens przy kodzie z AI
„Code review umrze. To znaczy: ono już nie żyje. Ale w przyszłości ludzie nie znajdą błędu ani problemu w kodzie wyprodukowanym przez model, a przynajmniej nie w rozsądnym czasie. Ludzie będą recenzować tylko system i jego kompozycję, ale nie w PR-ach i nie przez przeglądanie każdej linii kodu.”
(Thorsten Ball, wpis na X z 19 września 2026, tłumaczenie własne)
Ocena: nie zgadzamy się, choć druga połowa tezy jest trafna.
Ball ma rację w jednym: człowiek przeglądający linia po linii setki plików na falę nie ma szans. Myli się we wniosku. Recenzja nie umiera, tylko zmienia przedmiot. W naszym potoku nikt już nie szuka brakującego średnika. Recenzent szuka fałszywego twierdzenia, które jest poprawne składniowo.
Lista z jednego tygodnia października 2026 roku, wyłapana przez recenzentów:
- Agenci podali błędne numery artykułów w tekstach o regulacjach: artykuł 16 DORA tam, gdzie właściwe były artykuły 17 do 19, i artykuł 13 CRA tam, gdzie właściwy był artykuł 14.
- Agent zrobił “studium przypadku z wynikiem 23 procent” z samego tytułu wystąpienia na WordCampie. Takiego studium nie było.
- Identyfikator Wikidata podany dla Astro wskazywał na osobę, a ten dla Composera na kościół.
- Agent napisał kod serwera MCP pod API SDK, które nie istnieje, i przypisał protokołowi MCP “wbudowaną idempotentność”, której nie ma.
- W tekście o linkach pojawił się atrybut
rel="follow", którego nie definiuje żadna specyfikacja.
Żaden z tych błędów nie jest błędem w kodzie w klasycznym sensie. Każdy przeszedłby kompilację, parser YAML i walidator Markdown. Każdy zostałby opublikowany, gdyby recenzja umarła. Co więcej, część z nich to twierdzenia, które czytelnik przyjmie na wiarę, bo brzmią jak fakty z dokumentacji.
Druga połowa tezy Balla jest trafna: recenzja przenosi się z PR-ów na system. Nasi recenzenci nie czytają diffów, tylko porównują twierdzenia ze źródłami i wersje językowe między sobą. Recenzja zmienia się z “czy ta linia jest poprawna” na “czy to zdanie jest prawdziwe i czy całość trzyma się razem”. Tego nie robi się w okienku pull requesta, ale robi się to nadal, i to po stronie człowieka zostaje decyzja, czy zmiana trafia na produkcję.
Czy testy jednostkowe są potrzebne przy AI
„Testy jednostkowe też mogą umrzeć. Po co boczne kółka, jeśli nigdy się nie przewracasz? Modele napisały mi 900 linii C na Arduino, skompilowały je bez ani jednego błędu i wysłały na urządzenie, gdzie program zadziałał bezbłędnie. 900 linii to w przyszłości będzie nic.”
(Thorsten Ball, wpis na X z 19 września 2026, tłumaczenie własne)
Ocena: nie zgadzamy się.
Przykład z Arduino jest prawdziwy i robi wrażenie. Dowodzi jednak czegoś innego, niż sugeruje teza. Program, który się kompiluje i działa, spełnia jedno kryterium: robi coś bez awarii. Nie wiadomo, czy robi to, czego chciał autor przy każdym wejściu, ani czy będzie to robił po następnej zmianie.
W naszym serwisie najcenniejsze okazały się testy, które sprawdzają wynik builda, a nie kod źródłowy. Bramki uruchamiane na katalogu dist liczą nagłówki H1 na każdej stronie, sprawdzają, czy znacznik Markdown nie wyciekł jako tekst, czy dane strukturalne pasują do adresu kanonicznego. Te bramki wyłapywały regresje w zmianach, które skompilowały się bez jednego ostrzeżenia. Kompilator nie wie, że strona miała mieć jeden nagłówek H1, a ma dwa.
Test nie jest bocznym kółkiem. Jest zapisem oczekiwania w formie, którą maszyna sprawdzi przy każdej kolejnej zmianie, także tej zrobionej przez agenta za pół roku. Im więcej kodu piszą modele, tym bardziej taki zapis się opłaca, bo człowiek nie przeczyta wszystkiego, co wygenerowały. Zmienia się raczej poziom testów: mniej testów pojedynczej funkcji, więcej testów zachowania całego systemu i jego wyniku.
Czy warto uczyć się programowania w 2027
„Rzemiosło pisania kodu zniknie. Owszem, wciąż są włoscy szewcy. Ale spójrz na swoje stopy.”
„Rzemiosło budowania oprogramowania będzie ważniejsze niż kiedykolwiek. Wiedza, jak rozwiązywać problemy biznesowe oprogramowaniem, jak zrobiło to inne oprogramowanie i dlaczego tak, a dlaczego nie, kiedy i jak to wypuścić, jak zebrać informację zwrotną: to jest nowa gra.”
(Thorsten Ball, wpis na X z 19 września 2026, tłumaczenie własne)
Ocena: z pierwszą tezą zgadzamy się częściowo, z drugą w pełni.
Pisanie kodu linia po linii rzeczywiście traci znaczenie. W naszym potoku agenci piszą treść, poprawki i skrypty pomocnicze szybciej niż ktokolwiek z nas. Ale żeby ocenić, czy kod serwera MCP wywołuje API, które istnieje, trzeba umieć ten kod przeczytać i wiedzieć, gdzie sprawdzić SDK. Czytanie kodu nie znika razem z pisaniem. Szewc z metafory Balla nie musi już szyć butów, ale ktoś musi wiedzieć, że podeszwa jest przyklejona krzywo.
Druga teza to najtrafniejsze zdanie w całej notatce. Wiedza, co zbudować, jak to podzielić, kiedy wypuścić i jak zmierzyć skutek, jest dziś wąskim gardłem. Nasze repozytorium ma na to osobny dokument z zasadami produktowymi, który zaczyna się od tego, że problemem przestało być “jak to zaimplementować”, a stało się “co w ogóle powinno powstać”.
Na pytanie, czy uczyć się programowania, odpowiadamy więc: uczyć się budowania oprogramowania, a pisanie kodu traktować jako drogę do zrozumienia, co agent produkuje. Szerzej o tym, czy AI odbierze pracę programistom stron, piszemy w tekście czy AI zastąpi programistów WordPressa, a o pracy z agentami w zespole w artykule o inżynierii agentowej.
Błędy w kodzie z AI to często źle zadane zadanie
„Większość błędów nie będzie błędami »w kodzie«. Będą to błędy typu »poprosiłeś o złą rzecz«.”
(Thorsten Ball, wpis na X z 19 września 2026, tłumaczenie własne)
Ocena: zgadzamy się.
To teza, którą potwierdza nasza najdroższa lekcja. Wcześniejsze partie zadań dla agentów prosiły o rozbudowę artykułów do określonej liczby słów. Agenci wykonali dokładnie to polecenie: dopisali tekst, który podnosił licznik i nie wnosił treści. Kod skryptów był bezbłędny. Błędna była prośba. Dziś reguła repozytorium zakazuje skryptów dopychających treść do liczby słów, a osobna bramka łapie powtarzające się bloki wypełniacza.
Ten sam mechanizm widać w przypadku zmyślonego studium przypadku z wynikiem 23 procent. Agent dostał zadanie “dodaj sekcję opartą na źródłach” i źródło, które było tylko tytułem wystąpienia. Model wypełnił lukę liczbą. Prośba nie mówiła, co zrobić, gdy źródło jest za słabe.
Wniosek praktyczny: najwięcej czasu w pracy z agentami zajmuje dziś pisanie zadania, czyli opis, co jest wynikiem, czego nie wolno i co zrobić, gdy brakuje danych. To jest specyfikacja, tylko krótsza i pisana częściej niż kiedyś.
Czy open source przetrwa AI
„Open source w obecnej formie nie ma już sensu. »Przy wystarczającej liczbie oczu wszystkie błędy są płytkie« to wciąż prawda, tyle że teraz mamy sztuczne oczy.”
(Thorsten Ball, wpis na X z 19 września 2026, tłumaczenie własne)
Ocena: nie zgadzamy się.
Ball odwołuje się do prawa Linusa, sformułowanego przez Erica S. Raymonda: przy dużej liczbie uczestników błędy znajduje się szybko. Teza brzmi, że skoro modele mogą patrzeć na kod zamiast ludzi, otwarty model wkładu traci sens.
Dane z jednego z najważniejszych projektów open source pokazują odwrotny efekt. Daniel Stenberg, autor curl, zakończył program bug bounty projektu 31 stycznia 2026 roku. Program od 2019 roku przyniósł 87 potwierdzonych podatności i ponad 100 000 USD nagród dla badaczy. Według Stenberga w poprzednich latach ponad 15 procent zgłoszeń okazywało się prawdziwymi podatnościami, a od 2025 roku odsetek spadł poniżej 5 procent przy zalewie raportów generowanych przez AI. Nawet jedno na dwadzieścia nie było prawdziwe.
Sztuczne oczy istnieją, ale w tej postaci produkują zgłoszenia, a nie poprawki, i obciążają tych samych ludzkich opiekunów, którzy mieli na nich zyskać. Open source zmienia więc filtry wejściowe, a nie zasadę. WordPress, na którym pracujemy na co dzień, nadal żyje z otwartego kodu i z ludzi, którzy decydują, co trafia do rdzenia. Ten wybór nie zniknie, gdy kodu będzie więcej. Będzie ważniejszy.
Optymalizacja wydajności kodu a AI
„Wkład ludzi w krytyczną wydajność pozostanie tym, czym jest: przypadkiem brzegowym. W 99% oprogramowania nie ma znaczenia, że mógłbyś napisać szybszy algorytm albo wybrać lepszą strukturę danych. […] Kiedy ma to znaczenie, modele potrafią to naprawić.”
(Thorsten Ball, wpis na X z 19 września 2026, tłumaczenie własne)
Ocena: zgadzamy się częściowo.
Z pierwszą częścią trudno dyskutować. Większość kodu nie jest wąskim gardłem i nigdy nie będzie. Spór dotyczy zdania “modele potrafią to naprawić”. Model naprawi wydajność, jeśli ktoś wie, gdzie ona ucieka. W naszym buildzie kłopot nie siedział w algorytmie, który ktoś mógł napisać lepiej, tylko w kroku, o którym nikt nie myślał, dopóki nie zmierzyliśmy czasu poszczególnych etapów. Pomiar zrobił człowiek, poprawkę mógł potem napisać model.
W praktyce stron WordPress wygląda to podobnie: wolny sklep rzadko ma jeden zły algorytm. Ma za dużo wtyczek, zapytania bez indeksu albo cache ustawiony nie tam, gdzie trzeba. Decyzja, co usunąć, wymaga zrozumienia biznesu klienta, a nie tylko profilera.
Czy terminal umrze przez agentów AI
„Terminal nie żyje. Większość narzędzi deweloperskich zmyją tokeny. Ludzie nie będą już używać powłok, edytorów tekstu ani narzędzi CLI.”
(Thorsten Ball, wpis na X z 19 września 2026, tłumaczenie własne)
Ocena: nie zgadzamy się, choć rozumiemy, skąd teza.
Ball sam zaznacza, że pisze to jako miłośnik terminala. Ma rację, że człowiek coraz rzadziej pamięta flagi jq. Nasz potok pokazuje jednak, że terminal nie znika, tylko zmienia użytkownika. Agenci pracują właśnie w powłoce: uruchamiają npm run gates:run, czytają pliki, wywołują git. Każda bramka, która łapie ich błędy, jest skryptem wiersza poleceń.
Terminal staje się interfejsem dla agentów i dla człowieka, który sprawdza, co agent zrobił. Kiedy recenzent zgłasza błąd, najszybszy sposób na weryfikację to jedno polecenie grep na pliku. Człowiek pisze mniej poleceń, ale czyta ich więcej.
Tokeny zamiast kodu binarnego, co to znaczy
„Tokeny to nowy paradygmat obliczeniowy. Wszystko zostanie zbudowane od nowa na ich bazie. […] Wchodzimy w erę postbinarną.”
(Thorsten Ball, wpis na X z 19 września 2026, tłumaczenie własne)
Ocena: zgadzamy się częściowo.
Ball zauważa, że przez 80 lat mieliśmy deterministyczne komputery i mylimy to, jak działały, z tym, jak muszą działać. To uczciwa uwaga. Nasze doświadczenie dodaje do niej jedno zastrzeżenie: im więcej pracy wykonują modele niedeterministyczne, tym większą wartość mają deterministyczne bramki wokół nich.
W naszym potoku agent może napisać to samo zdanie na dziesięć sposobów, ale bramka liczy nagłówki zawsze tak samo. To połączenie działa: model generuje, skrypt sprawdza. Era postbinarna, jeśli nadejdzie, będzie stała na binarnym fundamencie kontroli. Trudno nam wyobrazić sobie odpowiedzialne wdrożenie, w którym model sprawdza sam siebie bez twardego kryterium.
Czy AI zastąpi product managera i projektanta
„Triada PM/Design/Eng zniknie. […] »Inżynierowie«, którzy działają jak »mięsne proxy«, wrzucają tickety do agentów i raportują z powrotem ludziom, przestaną być wartościowi.”
(Thorsten Ball, wpis na X z 19 września 2026, tłumaczenie własne)
Ocena: zgadzamy się częściowo.
Teza o “mięsnych proxy” jest trafna. Rola, która polega tylko na przekazywaniu zadań między człowiekiem a agentem, nie ma wartości, bo agent przyjmie zadanie bezpośrednio. W naszym potoku nie ma pośrednika między właścicielem a agentami.
Decyzje, które dzieliła triada, nie znikają jednak razem z podziałem ról. Ktoś nadal musi zdecydować, co budujemy i czego nie budujemy, jak ma wyglądać interfejs i czy zmiana jest gotowa. U nas te decyzje skupiły się w jednej osobie, a nie rozpłynęły. To raczej łączenie ról w jednej głowie niż ich koniec. Z tego wynika wymaganie: osoba, która prowadzi agentów, potrzebuje kompetencji z wszystkich trzech obszarów.
AI w małej firmie a w korporacji
„Różnica między inżynierią oprogramowania w dużych korporacjach i w małych firmach się zwiększy.”
„Niektórzy zostaną wypchnięci z wytwarzania oprogramowania przez koszty. […] jeśli nie masz dostępu do wystarczającej liczby tokenów, grasz w drugiej lidze. Musisz dostać się do tokenów.”
(Thorsten Ball, wpis na X z 19 września 2026, tłumaczenie własne)
Ocena: zgadzamy się częściowo z obiema tezami.
Ball pisze, że start-upy kopiujące praktyki Google będą wyglądać jeszcze śmieszniej, bo mogą budować szybciej i z mniejszymi ograniczeniami. Z perspektywy małego zespołu to prawda: nasz potok agentów nie ma komitetu architektonicznego, a fala zmian w kilkudziesięciu plikach przechodzi w ciągu dnia. Ale to, co nas chroni przed błędami, to dokładnie praktyka znana z dużych firm: automatyczne bramki, niezależna recenzja, jeden właściciel decyzji. Mała firma może zrezygnować z procesu, ale nie z kontroli.
Co do kosztu tokenów: dostęp do mocnych modeli rzeczywiście kosztuje i ten koszt rośnie razem z liczbą równoległych agentów. Granica nie przebiega jednak między bogatymi a biednymi, tylko między tymi, którzy umieją zamienić tokeny na sprawdzony wynik, a tymi, którzy płacą za tekst do wyrzucenia. Wypełniacz pisany pod licznik słów też kosztował tokeny.
Tańszy czy mądrzejszy model AI do programowania
„Wątpliwe, czy tańsze modele będą używane. […] mądrzejszy model popełnia mniej błędów i potrzebuje mniej tur. Kiedy naprawdę myślisz: »nie przeszkadza mi, że kilka razy się pomyli«?”
(Thorsten Ball, wpis na X z 19 września 2026, tłumaczenie własne)
Ocena: zgadzamy się.
Nasz potok ma tę zasadę zapisaną w instrukcjach repozytorium. Agent, który pisze prozę i tłumaczenia, pracuje na domyślnym, mocniejszym modelu. Tańszy model obsługuje wyłącznie recenzje tylko do odczytu, a każde jego zgłoszenie jest sprawdzane w pliku, zanim ktokolwiek zrobi poprawkę.
Ten podział odpowiada na pytanie Balla wprost. Tani model jest akceptowalny tam, gdzie pomyłka kosztuje jedno sprawdzenie. Tam, gdzie pomyłka trafia do tekstu na produkcji w sześciu językach, oszczędność na tokenach zamienia się w dłuższą recenzję i więcej poprawek. Liczy się koszt całego cyklu, a nie cena jednego wywołania.
Czy czysty kod ma znaczenie przy AI
„Nie ma dowodu, że »dobry kod« będzie miał znaczenie w przyszłości. Samo pojęcie »dobrego kodu« opiera się głównie na założeniu, że ludziom łatwo, tanio i wydajnie się z nim pracuje. Ale ludzie nie będą modyfikować większości kodu.”
(Thorsten Ball, wpis na X z 19 września 2026, tłumaczenie własne)
Ocena: zgadzamy się częściowo.
Szerokość 80 kolumn rzeczywiście nie ma znaczenia dla agenta. Część zasad “czystego kodu” przetrwa jednak z innego powodu niż wygoda człowieka: kod musi dać się sprawdzić. Nasze bramki działają tylko dlatego, że wynik ma przewidywalną strukturę. Frontmatter z jasnym kontraktem pól, jeden właściciel każdego identyfikatora w danych strukturalnych, jedna funkcja wyznaczająca adres usługi. Kiedy dwa miejsca w kodzie emitowały ten sam identyfikator schematu, problem nie polegał na brzydocie, tylko na tym, że żadna bramka nie wiedziała, które z nich jest źródłem prawdy.
“Dobry kod” przestaje znaczyć “przyjemny do czytania”. Zaczyna znaczyć “taki, którego poprawność da się zweryfikować automatycznie”. To przesunięcie, a nie koniec.
Interfejs generowany przez AI w locie
„Modele staną się tak szybkie, że UI będzie generowany w locie. Dużo UI istnieje, bo oprogramowanie nie rozumie, czego chcesz.”
(Thorsten Ball, wpis na X z 19 września 2026, tłumaczenie własne)
Ocena: nie mamy danych, które potwierdzają albo obalają tę tezę.
Ball pisze, że menu, ekrany ustawień, pulpity i filtry to w dużej części interfejs dla człowieka do “głupiej maszyny”. Obserwacja jest ciekawa. Nie generujemy interfejsu w locie i nie mamy pomiaru, który pozwoliłby ocenić, jak taki interfejs radzi sobie z dostępnością, przewidywalnością i zaufaniem użytkownika. Wolimy to zaznaczyć niż zgadywać.
Jedna obserwacja z naszej pracy: użytkownicy stron, które budujemy, nadal oczekują, że przycisk będzie w tym samym miejscu przy drugiej wizycie. Interfejs zmieniany przy każdym wejściu musiałby tę potrzebę jakoś spełnić.
Kiedy AI zmieni programowanie
„Minie pokolenie, zanim »nowe oprogramowanie« zastąpi »stare oprogramowanie«. […] będą ludzie zatrudnieni do pisania kodu za 10 lat. Ale czy chcesz mieć taką pracę?”
(Thorsten Ball, wpis na X z 19 września 2026, tłumaczenie własne)
Ocena: zgadzamy się.
Nawet zmierzenie, ile AI daje programistom, okazuje się trudne. Organizacja METR przeprowadziła w 2025 roku badanie z losową grupą kontrolną na doświadczonych programistach open source pracujących we własnych repozytoriach. Z narzędziami AI zadania zajmowały im o 19 procent więcej czasu. W lutym 2026 roku METR opisał drugie badanie: dla programistów z pierwszej edycji szacunek zmiany czasu zadania wyniósł minus 18 procent (przedział ufności od minus 38 do plus 9 procent), a dla nowych uczestników minus 4 procent. Sam METR uznał jednak te dane za niewiarygodny sygnał, bo coraz więcej programistów odmawiało udziału, ponieważ nie chciało pracować bez AI.
To dobry obraz okresu przejściowego: narzędzia są już tak wrośnięte w pracę, że trudno znaleźć grupę kontrolną, a jednocześnie nie ma twardej liczby, ile dają. Pokolenie to rozsądna skala czasu dla takiej zmiany. Pytanie Balla na końcu notatki zostawiamy czytelnikowi.
Co z tego wynika dla firm zamawiających oprogramowanie
Z 16 tez wyciągamy cztery praktyczne wnioski dla firm, które zamawiają strony, sklepy i integracje.
- Pytaj, kto i jak recenzuje twierdzenia, a nie tylko kod. Kod z AI kompiluje się poprawnie. Błędy siedzą w faktach, numerach przepisów, nazwach API i założeniach biznesowych.
- Wymagaj automatycznych bramek na wyniku. Test, który sprawdza zbudowaną stronę albo działanie integracji, złapie regresję, której nie widać w kodzie źródłowym.
- Inwestuj w opis zadania. Większość błędów to złe prośby. Dobra specyfikacja jest tańsza niż poprawki.
- Nie oszczędzaj na modelu tam, gdzie wynik trafia na produkcję. Tani model w recenzji z weryfikacją, mocny model tam, gdzie powstaje treść albo kod.
Jeśli masz stronę lub aplikację zbudowaną szybko z pomocą AI i nie wiesz, co w niej siedzi, zajmujemy się naprawą stron zrobionych przez AI. Gdy chcesz wprowadzić agentów do własnych procesów z kontrolą, której opis jest wyżej, zobacz wdrożenia AI i budowę serwerów MCP. Szersze tło, dlaczego zyski z AI przychodzą wolniej, niż obiecują dostawcy, opisujemy w tekście o paradoksie produktywności AI.
Ostatnia aktualizacja: 15 października 2026.