Przez większą część historii wyszukiwarek strona wyników była listą dziesięciu niebieskich linków. W 2026 roku coraz więcej zapytań kończy się zamiast tego napisaną odpowiedzią: Google pokazuje AI Overviews i AI Mode, ChatGPT ma funkcję wyszukiwania, a Perplexity odpowiada z ponumerowanymi źródłami. Każda z tych odpowiedzi linkuje do stron, z których skorzystała.
To zmienia stawkę, o którą gra strona na WordPressie. Celem nadal jest pozycja w wynikach, ale także miejsce wśród źródeł cytowanych przez silnik odpowiedzi. Ten poradnik opisuje, co sami dostawcy dokumentują na temat tego, jak ich systemy znajdują i pokazują strony, które crawlery musisz wpuścić oraz jak pisać i oznaczać treść, żeby model mógł wyjąć z niej jasne stwierdzenie.
Jak silniki odpowiedzi AI zmieniają wyszukiwanie w 2026
Google AI Overviews i AI Mode, Perplexity oraz wyszukiwarka ChatGPT zmieniły sposób, w jaki ludzie szukają informacji. Wielu użytkowników nie chce już listy stron do otwierania po kolei. Chcą streszczonej odpowiedzi, która oszczędza im czas, z linkami, w które mogą kliknąć, gdy potrzebują szczegółów albo chcą sprawdzić jakieś twierdzenie.
Dlaczego warto być cytowanym źródłem w odpowiedzi AI
Każda odpowiedź AI ma przypisy. Bycie źródłem konkretnego faktu stało się osobnym celem. W klasycznym SEO walczyłeś o jedną z dziesięciu pozycji. W odpowiedzi AI walczysz o to, żeby być jednym z kilku linków pokazanych obok akapitu, który odpowiada na pytanie.
Czym różni się wyszukiwarka od silnika odpowiedzi
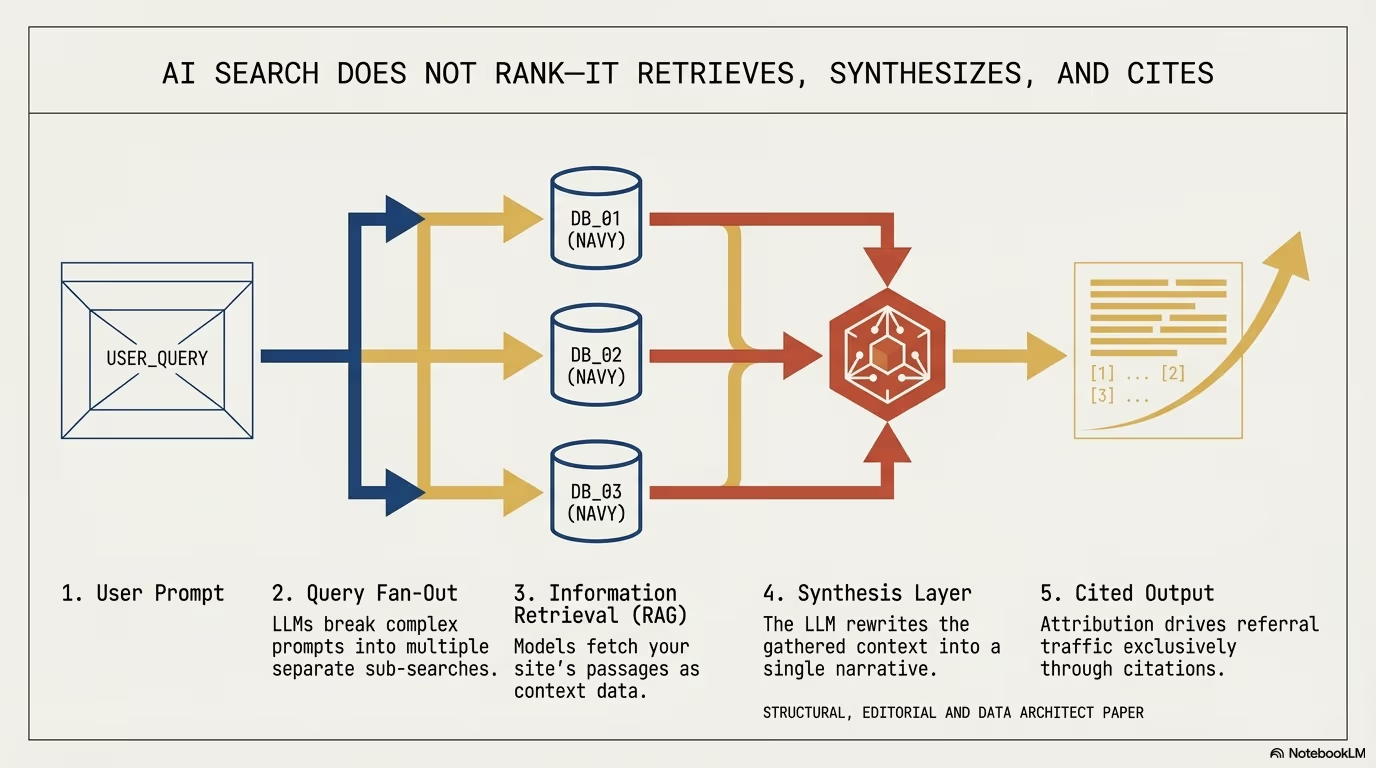
Klasyczna wyszukiwarka działa jak pośrednik, który kieruje odwiedzających na strony. Silnik odpowiedzi czyta kilka źródeł i pisze dla użytkownika syntezę. Twoja strona nadal musi zostać znaleziona i zaindeksowana, ale musi też zawierać stwierdzenia, które da się zacytować samodzielnie, bez otaczającego je akapitu.
Jak Google AI Overviews i AI Mode wybierają strony
Google publikuje dla właścicieli stron jeden dokument na ten temat: stronę o funkcjach AI w Google Search Central. Jest krótka i przeczy wielu rzeczom, które sprzedaje się jako „AI SEO”.
Według Google AI Overviews pomagają szybciej zrozumieć sedno złożonego tematu lub pytania, a AI Mode służy do zapytań wymagających dalszej eksploracji, rozumowania albo złożonych porównań. Obie funkcje mogą korzystać z techniki, którą Google nazywa query fan-out: system wysyła kilka powiązanych wyszukiwań w obrębie podtematów i źródeł danych, a potem składa odpowiedź z tego, co te wyszukiwania zwróciły. Strona może więc zostać zacytowana w podtemacie, który dobrze opisuje, nawet jeśli nie zajęłaby pozycji na pierwotne pytanie.
Warunek kwalifikacji jest taki sam jak w zwykłych wynikach wyszukiwania. Strona musi być zaindeksowana i mieć możliwość wyświetlenia w wyszukiwarce Google z fragmentem (snippetem). Google stwierdza, że nie ma żadnych dodatkowych wymagań technicznych ani specjalnych optymalizacji. Nie potrzebujesz nowych plików czytelnych dla maszyn, plików tekstowych dla AI ani dodatkowego oznaczenia, a dla tych funkcji nie trzeba dodawać żadnych specjalnych danych strukturalnych schema.org.
Google pisze też, że funkcje AI mogą pokazywać szerszy i bardziej zróżnicowany zestaw linków niż klasyczne wyszukiwanie, a AI Overviews pojawiają się tylko wtedy, gdy jego systemy uznają, że wnoszą coś do klasycznego wyszukiwania. Dla strony na WordPressie oznacza to, że podstawą jest zwykłe techniczne SEO: strony, które da się zcrawlować i zaindeksować, które nie mają zablokowanych fragmentów i które warto cytować.
Jak zdobyć cytowania w odpowiedziach AI
AIO (optymalizację pod AI) często opisuje się jako kolejny krok po klasycznym SEO. Przytoczona wyżej dokumentacja Google pokazuje, że strona techniczna nie ma specjalnych wymagań, więc praca przenosi się na treść: na to, jak jest jasna, weryfikowalna i oryginalna.
Jak pisać zdania, które model może zacytować
Unikaj waty słownej. Pisz zdaniami oznajmującymi. Zamiast „sądzimy, że blokowanie botów AI może zaszkodzić twojej widoczności” napisz „Blokowanie Google-Extended nie wpływa na obecność ani na pozycje w wyszukiwarce Google”. Drugie zdanie nazywa podmiot, zawiera jedno sprawdzalne twierdzenie i da się je wkleić do odpowiedzi bez redakcji.
Jasność nie oznacza uproszczenia. Oznacza precyzję i bezpośredniość oraz poparcie twierdzenia źródłem, które czytelnik może otworzyć. Zdania zależnego od poprzedniego akapitu („dlatego to ma znaczenie”) nie da się wyjąć samodzielnie, więc każde ważne twierdzenie powinno mieć własny podmiot.
Information gain, czyli co dać modelowi, czego nie znajdzie gdzie indziej
Jeśli tylko powtarzasz to, co jest w Wikipedii, silnik odpowiedzi nie ma powodu wybrać Twojej strony zamiast dziesiątek innych, które mówią to samo. Strony warte cytowania coś dodają: własne pomiary, dane z własnych projektów, porównanie, które sam przeprowadziłeś, albo wyjaśnienie praktyka, dlaczego udokumentowane ustawienie zachowuje się na produkcji tak, a nie inaczej.
Jak pisać nagłówki, które działają jak samodzielne odpowiedzi
Silniki odpowiedzi pracują na fragmentach, a nie na całych artykułach. Układaj nagłówki tak, żeby odzwierciedlały logikę tematu, i pisz każdą sekcję tak, żeby miała sens czytana w oderwaniu od reszty. Nagłówek sformułowany tak, jak ludzie szukają („jak zablokować GPTBot w WordPressie”), a po nim bezpośrednia odpowiedź w pierwszym zdaniu, łatwiej dopasować do zapytania niż błyskotliwy tytuł.
Jak dodać ramkę z najważniejszymi wnioskami w WordPressie
Na wppoland.com na początku długich wpisów umieszczam uporządkowane podsumowanie najważniejszych faktów. Powód jest prosty: krótki blok samodzielnych stwierdzeń czytelnik łatwo przejrzy, a dowolny system łatwo go sparsuje, zacytuje i porówna z resztą strony.
Jak zrobić ramkę z wnioskami w Gutenbergu
Użyj bloku grupy albo listy w Gutenbergu, ostylowanego jako ramka „Najważniejsze wnioski”. W tle dbaj o to, żeby dane strukturalne Article na stronie były zgodne z treścią ramki. Google nie wymaga specjalnego oznaczenia dla funkcji AI, więc traktuj ramkę przede wszystkim jako treść: musi być prawdziwa, opatrzona źródłami i widoczna dla czytelnika.
Co powinna zawierać ramka z wnioskami
Przydatna ramka nazywa główny podmiot, wymienia od trzech do pięciu weryfikowalnych faktów z konkretnymi wartościami, podaje datę ostatniego sprawdzenia faktów i linkuje do źródła pierwotnego każdego z nich. Unikaj w niej haseł marketingowych. Twierdzenie, którego nikt nie może sprawdzić, słabo nadaje się do cytowania.
Jak pisać FAQ pod zapytania w wyszukiwarkach AI
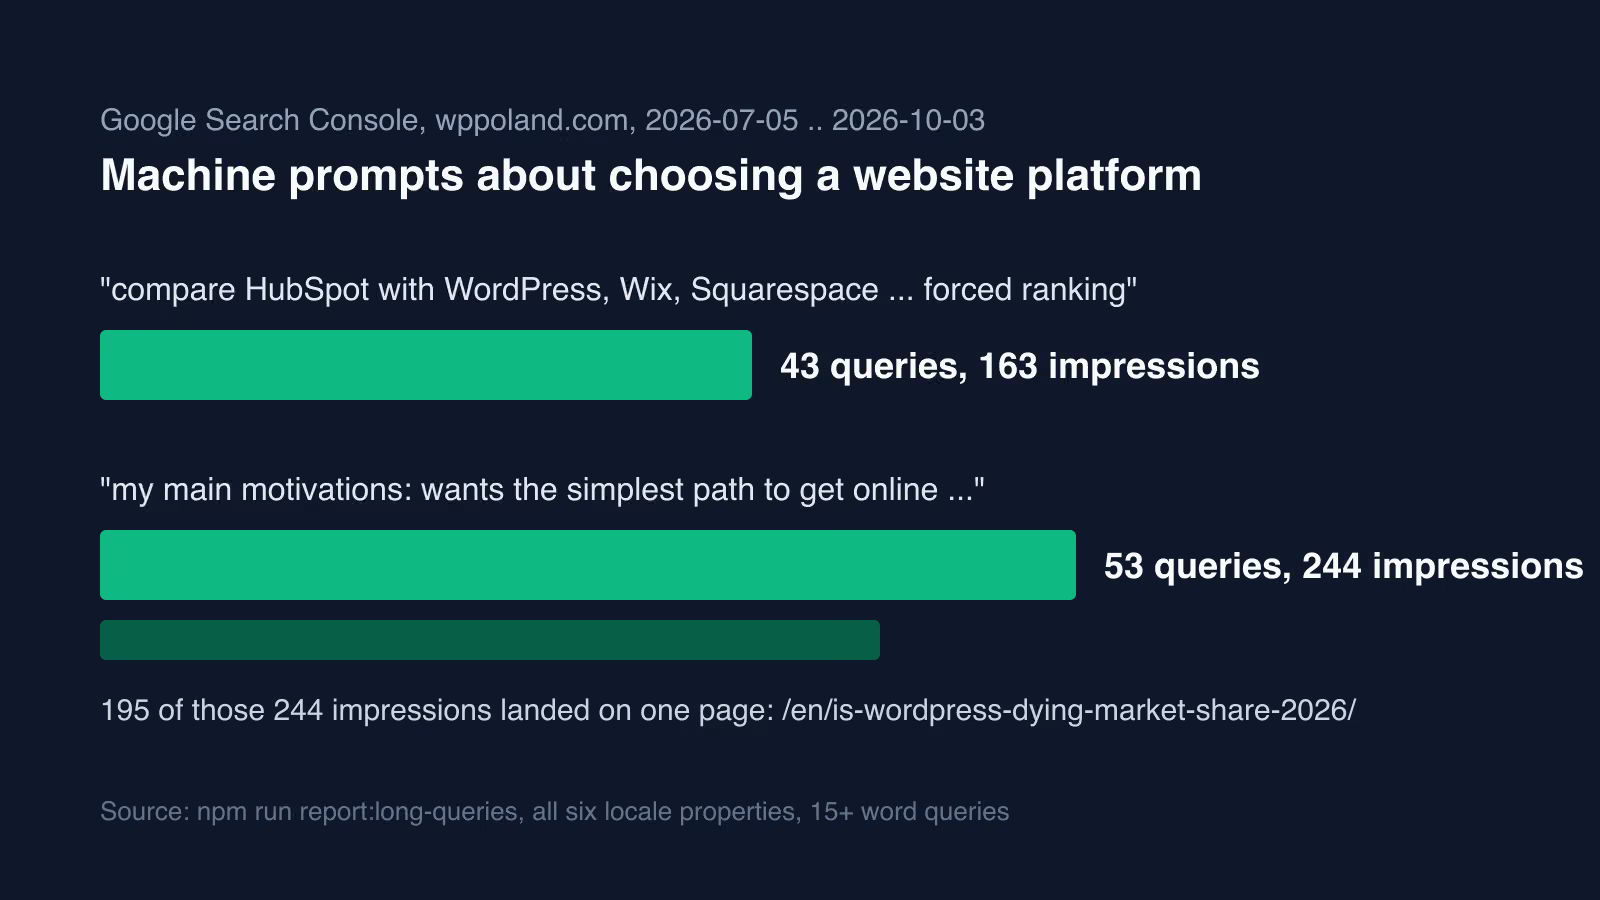
Zapytania w wyszukiwarkach AI są często długie i konwersacyjne: „Jak przeskalować WordPress Multisite na 100 firmowych subdomen z użyciem Dockera?”
Jak formułować pytania tak, jak zadają je użytkownicy
Korzystaj z sekcji FAQ świadomie. Formułuj pytania dokładnie tak, jak użytkownik powiedziałby je do telefonu albo wpisał w okno czatu. Pomijaj wewnętrzny żargon i akademickie sformułowania.
Jak odpowiadać na pytania jak i dlaczego
Odpowiadaj na „jak” i „dlaczego”, a nie tylko na „co”. Jednozdaniowa odpowiedź rzadko komuś pomaga. Odpowiedź, która podaje warunek, w jakim jest prawdziwa, oraz przykład, jest bardziej przydatna dla czytelnika i daje silnikowi odpowiedzi kompletny fragment do pracy.
Miej realistyczne oczekiwania co do oznaczeń. Od sierpnia 2023 Google pokazuje wyniki rozszerzone FAQ tylko dla znanych, wiarygodnych stron rządowych i medycznych (blog Google Search Central). Dane strukturalne FAQ nadal opisują stronę, ale typowej firmowej stronie na WordPressie nie dadzą wyniku rozszerzonego FAQ.
Jak celować w długie zapytania konwersacyjne
Zamiast strony nastawionej na „WordPress SEO” pisz treść, która odpowiada na pytania w rodzaju „jak poprawić SEO sklepu WooCommerce z produktami w kilku językach”. Właśnie takie konkretne zapytania ludzie wpisują w silniki odpowiedzi.
Które crawlery AI wpuścić w robots.txt
Każdy dostawca oddziela crawlery zasilające jego produkt wyszukiwania od crawlerów zbierających dane treningowe oraz od fetcherów działających w imieniu pojedynczego użytkownika. Zablokowanie niewłaściwego usuwa Cię z odpowiedzi. Zablokowanie właściwego trzyma Twoją treść poza treningiem, a Ty nadal jesteś widoczny. Poniższa tabela powstała na podstawie dokumentacji każdego z dostawców.
| Dostawca | Crawler wyszukiwania | Crawler treningowy | Fetcher uruchamiany przez użytkownika | Uwagi dostawcy |
|---|---|---|---|---|
| OpenAI | OAI-SearchBot | GPTBot | ChatGPT-User | Ustawienia są niezależne; zmiany w robots.txt działają po około 24 godzinach |
| Perplexity | PerplexityBot | brak na liście | Perplexity-User | PerplexityBot nie służy do trenowania modeli bazowych |
| Anthropic | Claude-SearchBot | ClaudeBot | Claude-User | Obsługuje Crawl-delay; blokada IP nie jest pewnym sposobem rezygnacji |
| Googlebot | Google-Extended (tylko token) | nie dotyczy | Google-Extended nie wpływa na wyszukiwarkę Google |
Jak działają OAI-SearchBot, GPTBot i ChatGPT-User od OpenAI
Według dokumentacji crawlerów OpenAI OAI-SearchBot służy do pokazywania stron w funkcjach wyszukiwania ChatGPT, a strony, które go wykluczą, nie pojawią się w odpowiedziach wyszukiwarki ChatGPT. GPTBot crawluje treści, które mogą zostać użyte do trenowania generatywnych modeli bazowych OpenAI. Zablokowanie go sygnalizuje, że Twoja treść nie powinna służyć do treningu. Każde ustawienie jest niezależne, więc możesz wpuścić OAI-SearchBot i zablokować GPTBot. ChatGPT-User odwiedza stronę, gdy użytkownik zadaje pytanie ChatGPT albo własnemu GPT. Ponieważ tę akcję uruchamia człowiek, reguły robots.txt mogą nie mieć zastosowania, a OpenAI podaje, że ChatGPT-User nie decyduje o tym, czy treść może pojawić się w wyszukiwaniu. OpenAI zaznacza, że dostosowanie jego systemów po zmianie robots.txt może trwać około 24 godzin, i publikuje listy adresów IP dla każdego bota (na przykład openai.com/searchbot.json).
Jak działają PerplexityBot i Perplexity-User
Dokumentacja Perplexity opisuje PerplexityBot jako crawler, który pokazuje strony i linkuje do nich w wynikach wyszukiwania Perplexity, i zaleca wpuszczenie go w robots.txt, jeśli chcesz się tam pojawiać. Perplexity stwierdza, że nie służy on do crawlowania treści dla modeli bazowych AI. Perplexity-User obsługuje działania użytkowników: gdy ktoś zadaje pytanie, może odwiedzić stronę, żeby pomóc na nie odpowiedzieć. Ponieważ pobranie zlecił użytkownik, z reguły ignoruje on reguły robots.txt. Oba boty mają opublikowane zakresy IP.
Jak działają ClaudeBot, Claude-SearchBot i Claude-User od Anthropic
Artykuł pomocy Anthropic o jego crawlerach wymienia trzech agentów. ClaudeBot zbiera treści z sieci, które mogą trafić do treningu. Zablokowanie go powinno wyłączyć Twoje przyszłe materiały ze zbiorów treningowych. Claude-SearchBot crawluje, żeby poprawić jakość wyników wyszukiwania. Zablokowanie go oznacza, że Twoja treść nie zostanie zaindeksowana na potrzeby wyszukiwania, co może zmniejszyć jej widoczność w odpowiedziach. Claude-User pobiera strony, gdy użytkownik Claude zadaje pytanie, które ich wymaga. Zablokowanie go uniemożliwia Claude pobranie Twojej strony dla tych użytkowników. Boty Anthropic respektują robots.txt i obsługują niestandardową dyrektywę Crawl-delay. Anthropic ostrzega, że blokowanie jego adresów IP może nie zadziałać jako rezygnacja, bo boty nie mogą wtedy odczytać Twojego robots.txt.
Czy Google-Extended wpływa na wyszukiwarkę Google
Lista popularnych crawlerów Google opisuje Google-Extended jako ustawienie decydujące o tym, czy treści crawlowane przez Google mogą być użyte do trenowania przyszłych modeli Gemini i do groundingu w niektórych produktach Gemini. Google stwierdza, że Google-Extended nie wpływa na obecność strony w wyszukiwarce Google i nie jest sygnałem rankingowym. Nie ma osobnego user agenta HTTP, to wyłącznie token w robots.txt. AI Overviews i AI Mode są częścią wyszukiwarki, więc kontrolujesz je przez dostęp Googlebota oraz ustawienia fragmentów opisane niżej.
Jak edytować robots.txt w WordPressie dla crawlerów AI
Jeśli w katalogu głównym serwera nie ma fizycznego pliku robots.txt, WordPress serwuje wirtualny przez do_robots(), funkcję obecną od WordPressa 2.1. Jej wynik przechodzi przez filtr robots_txt (dostępny od WordPressa 3.0), który dostaje wygenerowany tekst i flagę mówiącą, czy strona jest publiczna. Ten filtr to porządne miejsce na dodanie reguł dla crawlerów AI z motywu albo małej wtyczki:
add_filter( 'robots_txt', function ( $output, $public ) {
    if ( ! $public ) {
        return $output;
    }
    $output .= "\nUser-agent: GPTBot\nDisallow: /\n";
    $output .= "\nUser-agent: ClaudeBot\nDisallow: /\n";
    $output .= "\nUser-agent: Google-Extended\nDisallow: /\n";
    return $output;
}, 10, 2 );
Ten przykład blokuje stronę dla trzech crawlerów treningowych, a OAI-SearchBot, PerplexityBot, Claude-SearchBot i Googlebot zostawia bez zmian, więc strona nadal może trafiać do ich odpowiedzi. Sprawdzenie flagi publicznej pomija strony, które zniechęcają wyszukiwarki do indeksowania. Jeśli hosting albo wtyczka SEO zapisuje fizyczny plik robots.txt, serwer WWW zwykle serwuje go bezpośrednio i filtr w ogóle się nie uruchamia, więc wtedy edytuj sam plik. Po zmianie otwórz /robots.txt w przeglądarce i sprawdź, czy reguły tam są.
Jak ograniczyć to, co funkcje AI pokazują z Twoich stron
Strona Google o funkcjach AI odsyła właścicieli stron do tych samych ustawień, które sterują zwykłymi fragmentami. Dostęp Googlebota w robots.txt decyduje o tym, czy stronę w ogóle da się zcrawlować. Poza tym:
noindexcałkowicie wyłącza stronę z wyszukiwarki, a więc także z AI Overviews i AI Mode.nosnippetsprawia, że Google nie pokazuje fragmentu tekstu ze strony, co ogranicza też jej użycie w funkcjach AI.data-nosnippetna elemencie HTML wyłącza z fragmentów tylko tę część strony.max-snippetustala maksymalną długość fragmentu w znakach.
W WordPressie noindex i dyrektywy meta robots ustawiasz zwykle we wtyczce SEO, której już używasz, a data-nosnippet to atrybut, który dodajesz w widoku HTML edytora bloków albo w szablonie. Stosuj je do treści, których nie chcesz streszczać, na przykład płatnych materiałów, zamiast blokować Googlebota, bo to usunęłoby stronę także z klasycznych wyników.
Jakie schema stosować pod wyszukiwanie AI
Google mówi wprost, że AI Overviews i AI Mode nie potrzebują specjalnego oznaczenia schema.org. Dane strukturalne nadal pomagają stronie w klasycznym wyszukiwaniu i jednoznacznie opisują ją każdemu systemowi, który je czyta, więc warto dbać o ich poprawność.
Jak rozbudować schema Article ponad podstawy
Poza podstawowym oznaczeniem Article właściwości takie jak about, mentions, citation i speakable opisują, czego dotyczy strona i na jakich źródłach się opiera. Utrzymuj je w zgodzie z widocznym tekstem. Oznaczenie, które twierdzi więcej, niż pokazuje strona, nikomu nie pomaga.
Jak dodać schema Person dla autorów
Daj każdemu autorowi encję Person z jego rolą, afiliacją i linkami do profili zawodowych, które da się sprawdzić. To wspiera sygnały zaufania opisane niżej i pomaga czytelnikowi, człowiekowi albo maszynie, zobaczyć, kto stoi za danym twierdzeniem.
Jak mierzyć ruch z wyszukiwania AI
Google wlicza ruch z funkcji AI do ogólnego ruchu z wyszukiwania w Search Console. Pojawia się on w raporcie Skuteczność pod typem wyszukiwania „Internet” i nie jest wydzielony osobno, więc nie znajdziesz tam dedykowanego filtra AI Overviews.
W przypadku innych silników zacznij od logów serwera. Filtruj żądania po wymienionych wyżej user agentach (OAI-SearchBot, ChatGPT-User, PerplexityBot, Perplexity-User, Claude-SearchBot, Claude-User), żeby zobaczyć, które strony pobiera każdy dostawca, i porównuj adresy źródłowe z listami IP publikowanymi przez dostawców, bo ciągi user agent łatwo podrobić. Potem sprawdź w narzędziu analitycznym ruch z odesłań z domen silników odpowiedzi i ręcznie sprawdzaj swoje główne tematy w każdym silniku, żeby zobaczyć, czy Twoje strony pojawiają się jako źródła. Powtarzaj to przez kilka dni z rzędu i licz, w ilu z nich strona się pojawiła: jedno sprawdzenie prawie nic nie mówi, a dlaczego, pokazuje następna sekcja.
Dlaczego moja strona znika z odpowiedzi AI z dnia na dzień?
Aktualizacja, . 29 października 2026 Ahrefs opublikował badanie stabilności cytowań w odpowiedziach AI, którego autorem jest Mateusz Makosiewicz. Przez 20 dni Ahrefs codziennie zadawał te same pytania w Google AI Mode, Google AI Overviews, ChatGPT, Gemini i Copilocie i śledził około 37 500 cytowań. Dane pochodzą z Brand Radar, własnego narzędzia Ahrefs, więc to badanie producenta. Dla firmowej strony liczy się z niego kilka liczb:
- Połowa lub więcej cytowań znikała już następnego dnia: około 60% w AI Mode i ChatGPT, 50% w AI Overviews i 80% w Gemini i Copilocie. W ChatGPT, AI Mode i AI Overviews przez wszystkie 20 dni utrzymało się tylko od 4,0 do 6,8% cytowań.
- Około 75% utraconych cytowań wróciło w trakcie badania, połowa z nich w ciągu trzech dni. Na dobre wypadło od 20 do 27% cytowań z pierwszego dnia.
- Strony, które miały pozycję w Google na dane pytanie, utrzymywały cytowanie przez co najmniej siedem dni w 29% przypadków w AI Overviews i w 28% w AI Mode. Strony bez pozycji tylko w 4%.
- Trwałe cytowania od jednodniowych odróżniał ruch organiczny (mediana 88 wizyt miesięcznie wobec 8 w AI Overviews). Domain Rating wynosił od 64 do 78 w obu grupach.
- Gdy pytanie zawierało nazwę marki, przy faktach cytowane były strony samej marki, przez 97 do 100% dni. Przy recenzjach narzędzia AI Google cytowały je tylko przez 0 do 5% dni.
- Najbardziej rotują pytania typu „najlepszy X”, a 64% odpowiedzi Gemini i 53% odpowiedzi Copilota nie podawało żadnego źródła.
Tego samego dnia Search Engine Roundtable opisał wywiad, który David Iwanow nagrał z Johnem Muellerem z Google podczas Search Central Live Deep Dive Europe 2026 (nagranie). Według tej relacji Mueller powiedział, że listy typu „top 10” same w sobie nie są spamem, ale strategia oparta na tysiącach takich list jest ryzykowna. Sztuczki, które szybko się rozchodzą, systemy z czasem rozpoznają i przestają nagradzać, tak jak było z upychaniem słów kluczowych i białym tekstem na białym tle. Radzi też dopytywać konsultantów, którzy obiecują nadzwyczajne wyniki. Nie udało mi się pobrać transkrypcji nagrania, więc to streszczenie relacji, a nie cytat.
Co firmowa strona powinna teraz robić z cytowaniami AI?
- Licz, przez ile z ostatnich siedmiu dni strona była cytowana. Zanim przepiszesz stronę, która wypadła z odpowiedzi, odczekaj dwa, trzy tygodnie.
- Pracuj nad pozycjami w Google na pytania, przy których chcesz być cytowany, i nadaj tym stronom tytuły zgodne z tymi pytaniami.
- Dbaj, żeby strony z ofertą, zakresem usług i kontaktem były aktualne i łatwe do znalezienia. Przy pytaniach z nazwą Twojej firmy to właśnie je cytuje odpowiedź.
- Wzmianki o marce licz osobno od linków, bo cytowana strona często nie pada z nazwy w treści odpowiedzi.
- W Gemini i Copilocie najpierw sprawdź, czy odpowiedź w ogóle podała źródła, zanim uznasz brak cytowania za stratę.
Z jakich taktyk pod wyszukiwanie AI warto zrezygnować?
- Z seryjnych zestawień w rodzaju „najlepsze biuro rachunkowe w Gdańsku”, w których Twoja firma zajmuje pierwsze miejsce. Mueller nazwał taką strategię ryzykowną, a odpowiedzi typu „najlepszy X” to w danych Ahrefs najmniej stabilne cytowania.
- Z kupowania linków dla wyższego Domain Rating z myślą o AI. W tym badaniu trwałe cytowania odróżniał ruch i pozycje, a linki liczą się o tyle, o ile pomagają stronie rankować.
- Z umów, w których ktoś gwarantuje cytowania w AI. Skoro od 50 do 80% cytowań zmienia się z dnia na dzień, takiej gwarancji nikt nie dotrzyma.
Tak prowadzę optymalizację SEO i GEO dla WordPressa: najpierw pozycje i rzetelne strony, potem cytowania mierzone przez kolejne tygodnie.
Jak sprawić, żeby AI uznało Twoją treść za wiarygodną
Silniki odpowiedzi potrafią powtarzać znalezione błędy, więc strona, której twierdzenia łatwo zweryfikować, jest bezpieczniejszym źródłem do cytowania. Żeby Twoja budziła więcej zaufania:
- Linkuj do źródła pierwotnego przy każdym ważnym twierdzeniu, na przykład do oficjalnej dokumentacji, standardu albo informacji o wydaniu.
- Dbaj o kompletne schema autora (
Person), które pokazuje, że autor pracuje w branży. - Datuj fakty i aktualizuj je, gdy zmienia się źródło. Nieaktualna liczba jest gorsza niż żadna.
Dowiedz się więcej o usługach optymalizacji SEO i GEO w WPPoland.
Podsumowanie optymalizacji WordPressa pod wyszukiwanie AI
Optymalizacja pod wyszukiwanie AI to w większości praca, której dobre SEO wymagało już wcześniej: strony, które da się zcrawlować i zaindeksować, jasne stwierdzenia ze źródłami i coś oryginalnego do powiedzenia. Nowością jest wybór, które crawlery wpuścić. Skupiając się w treściach na WordPressie na jasności stwierdzeń i information gain oraz wpuszczając crawlery wyszukiwania, a o crawlerach treningowych decydując osobno, dajesz silnikom odpowiedzi powód, żeby Cię cytowały.
Praca nad cytowaniami w LLM-ach się sprawdza, gdy integracja AI z WordPressem udostępnia encje i fakty, które te silniki faktycznie cytują.