Jeśli twój zespół pisze dokumentację, README, informacje o wydaniu albo firmowego bloga z pomocą Claude Code, Codex albo Cursora, potrzebujesz dwóch warstw kontroli: skilla, który przepisuje tekst, i skryptu w CI, który blokuje znane błędy. Sam prowadzę tak sześciojęzyczną stronę WPPoland. Każdy tekst przechodzi przez humanizer, polski dodatkowo przez miodkuj, a potem przez skrypty w repozytorium. Opisuję, co robią humanizer, miodkuj i unslop, co pokazują ich testy i jak ustawić bramkę, żeby nie zatrzymywała pracy na miękkich uwagach.
Jak wygląda moja droga tekstu od szkicu do publikacji
Piszę szkic z pomocą Claude Code, potem uruchamiam humanizer w trybie pliku. W plikach polskich dokładam miodkuj, też w trybie pliku. Reguła w repozytorium jest krótka: żaden nowy ani rozbudowany wpis nie wychodzi bez obu przebiegów. Od 2 listopada 2026 r. mam też regułę globalną, wspólną dla wszystkich projektów: każdy polski tekst, który przeczyta człowiek (mail, oferta, raport, artykuł), przechodzi przez miodkuj. Mój zakaz długich myślników wygrywa w niej z tym, co miodkuj mówi o myślnikach.
Oba skille zainstalowałem ręcznie jako zwykłe katalogi w ~/.claude/skills/. Dzięki temu wywołuję je krótko, /humanizer i /miodkuj, bez prefiksu wtyczki. Po skillach tekst trafia do skryptów, które opisuję niżej. Skrypty łapią słowa i kształty zdań, skille oceniają, czy zdanie coś mówi.
Jeśli porządkujesz już opublikowane treści, a nie nowe szkice, zacznij od wpisu o czyszczeniu treści AI slop w WordPressie. Ten artykuł dotyczy tekstów, które dopiero powstają.
Czym różnią się humanizer, miodkuj i unslop
| Skill | Co robi | Język | Co dowodzi skuteczności | Kiedy go używam |
|---|---|---|---|---|
| humanizer v3.1.0, MIT | Przepisuje tekst według 26 wzorców w sześciu grupach (inscenizacja, rytm, nadmuchanie, formatowanie, resztki czatu, zły adresat). SKILL.md ma 31,6 KiB | Wzorce opisane po angielsku; skill każe traktować odpowiednik konstrukcji w innym języku tak samo | Brak zestawu testów w repozytorium. Ślepy test z issue #229, zgłoszony przez użytkownika | Po każdym szkicu, we wszystkich sześciu językach |
| miodkuj v2.1.1, MIT | Minimalna edycja polskiego tekstu: urzędowy styl, rzeczowniki odczasownikowe, kalki, zdania do przeniesienia gdziekolwiek. SKILL.md ma 6,6 KiB i jest napisany po angielsku | Polski | Własny test autora: 12 z 13 przypadków, jeden częściowo | Na każdym polskim tekście, po humanizerze |
| unslop 2.3.0 | Cztery polecenia (teach, cleanup, rewrite, mimic) i cztery skanery w Pythonie 3.8+ bez zależności | Tylko angielski | Zestaw testów z trzema tablicami wyników; ostatni niezależny wynik to “nie wydawać” | Na angielskiej dokumentacji, gdy chcesz skanera w CI |
Polecenia unslop różnią się zakresem. /unslop teach buduje głos z twoich próbek tekstu. /unslop cleanup tylko zgłasza oznaki AI jako sugestie i sam niczego nie zmienia. /unslop rewrite diagnozuje szkic i przepisuje go od nowa; to domyślne zachowanie, gdy wpiszesz samo /unslop <tekst>. /unslop mimic pisze w wyuczonym głosie i potem przepuszcza wynik przez wszystkie kontrole.
Miodkuj nie ma skanera. W jego katalogu scripts/ leżą tylko skrypty do budowania paczki i walidacji repozytorium, więc wykrywanie zależy wyłącznie od oceny modelu. Humanizer też nie ma skanera ani CLI; jego validate-package.py sprawdza manifesty, README i CHANGELOG.
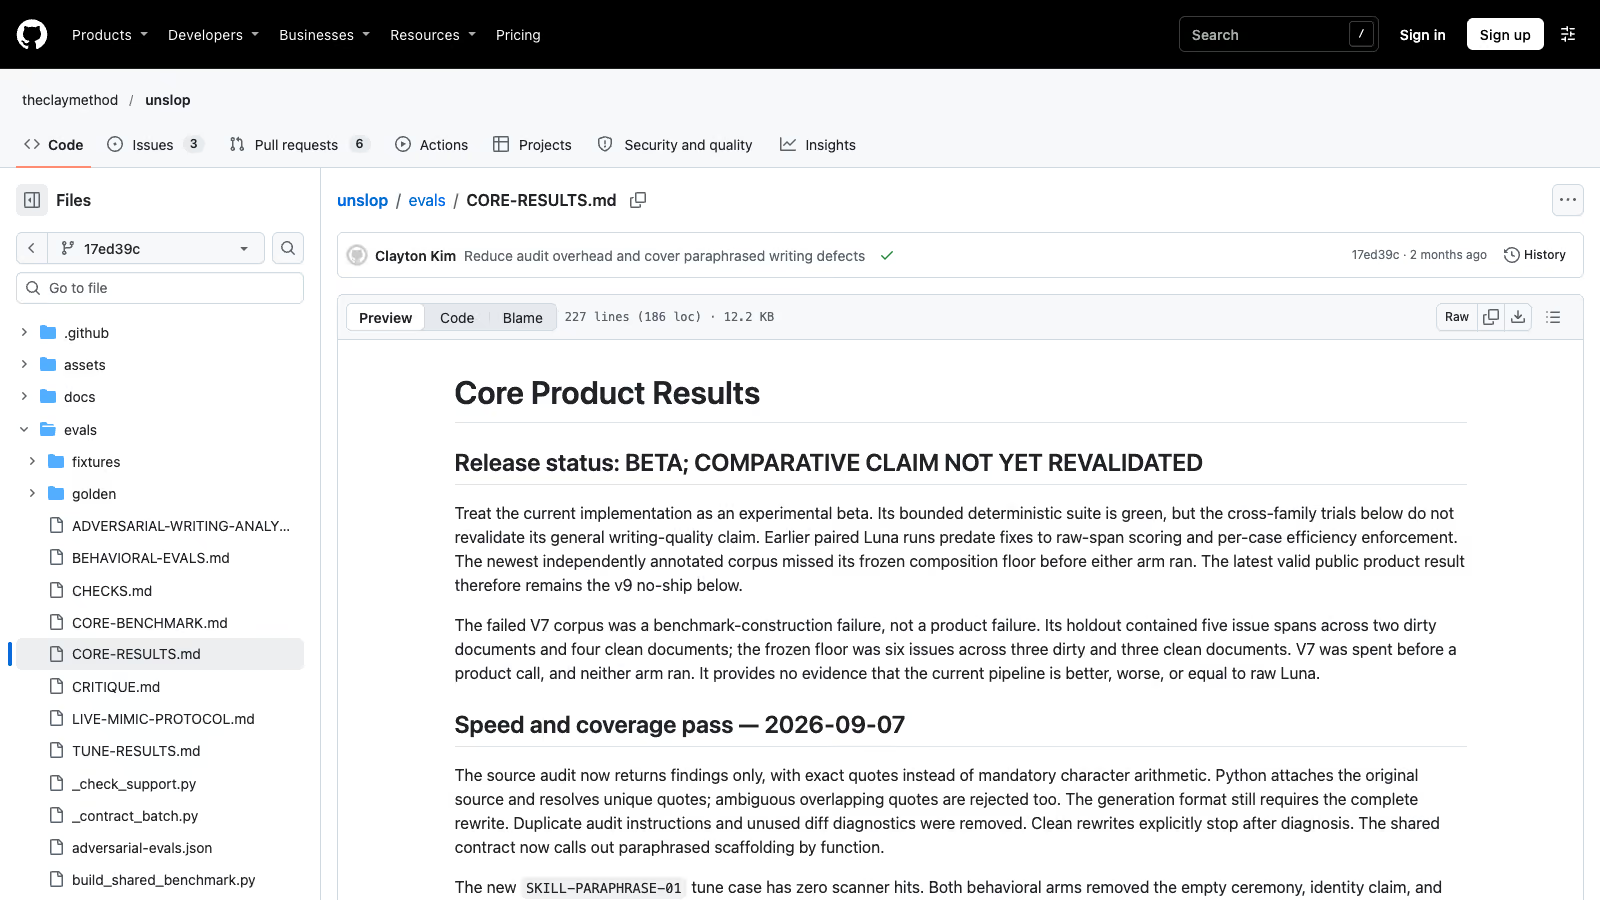 Strona wyników ewaluacji unslopa w commicie 17ed39c: beta, twierdzenie porównawcze nie zostało ponownie potwierdzone (zrzut z 6 listopada 2026).
Co naprawdę pokazują testy tych skilli
Unslop ma najpoważniejszy zestaw testów z tej trójki i najszczerzej opisuje jego wynik. README dzieli wyniki na trzy tablice: produkt (wykrywanie, naprawa, zachowanie treści, szkody), głos (teach i mimic) oraz inżynierię (pokrycie skanerów, schematy, regresje). Według README tylko pierwsza z nich może pokazać, że specyfikacja poprawia tekst.
Najnowszy niezależny, publiczny wynik to werdykt no-ship, czyli “nie wydawać”. README dodaje, że obecna beta “nie deklaruje potwierdzonej przewagi w porównaniu” (README unslop, tłumaczenie własne). Liczby z zamrożonego zestawu v9: oba warianty na modelu gpt-5.6-luna, oceniał niezależny model gpt-5.6-sol, trzy dokumenty z błędami i jeden czysty, 31 opisanych usterek (CORE-RESULTS.md).
| Miara | Luna + unslop | Sama Luna | Wymagane |
|---|---|---|---|
| Precyzja wykrywania | 81,25% | 83,33% | >= 90% |
| Czułość wykrywania | 83,87% | 32,26% | >= 90% |
| Skuteczna naprawa | 87,10% | 58,06% | >= 90% |
| Zachowanie treści | 100% | 100% | 100% |
| Odsetek szkód | 11,11% | 0% | 0% |
| Dokumenty z błędami bezpiecznie poprawione | 0 z 3 | 0 z 3 | >= 80% |
Unslop znalazł ponad dwa razy więcej usterek niż sam model i więcej z nich naprawił. Przy okazji psuł tekst w 11 procentach przypadków, a żadnego z trzech brudnych dokumentów nie poprawił bezpiecznie. Przepisanie przez unslop czytam więc tak samo uważnie jak przepisanie bez niego.
Humanizer w README powołuje się na ślepy test, w którym sędziowie 16 razy na 16 woleli jego wersję od oryginału. Test opisuje issue #229, które otworzył użytkownik, a nie opiekun projektu. Samo issue podaje ograniczenia: każdy sędzia to model językowy z jednej rodziny, a z 144 zaplanowanych porównań przeprowadzono 77, bo zawiodła infrastruktura. Wykrywalność prawie się nie ruszyła: 100%, potem 98,6% i 97,8%. README humanizera mówi to samo innymi słowami: omijanie detektorów AI nie jest celem, a detektory nadal oznaczają większość tego, co skill wytwarza (README humanizera, tłumaczenie własne).
Miodkuj ma własny test zachowania z 14 września 2026 r. Wersje 2.1.0 i 2.1.1 uruchomiono raz, każdą w świeżym podagencie Codex na modelu gpt-5.6-sol. Wersja 2.1.1 przeszła 12 z 13 przypadków, jeden (travel_polish) częściowo. Wersja 2.1.0 oblała 3 z 12 wspólnych przypadków. Ten częściowy wynik najpierw opisano jako zaliczony i poprawiono go tego samego dnia. Autor sam zaznacza, że te testy “nie ustalają ogólnego wskaźnika niezawodności ani poprawy między modelami” (dokumentacja miodkuj, tłumaczenie własne).
Najwięcej wiadomo o unslopie, bo publikuje porażkę razem z liczbami.
Jak miodkuj poprawia polski tekst
Miodkuj opiera się na trzech regułach. Pierwsza: “wprowadź minimalną skuteczną poprawkę” (SKILL.md miodkuj, tłumaczenie własne). Skill nie przepisuje akapitu od zera, tylko usuwa usterkę i zostawia resztę głosu autora.
Druga reguła to drabina konkretu (w źródle Specificity Ladder). Gdy zdanie jest ogólnikowe, skill kolejno: używa faktu, mechanizmu lub przykładu, który już jest w tekście; składa istniejące informacje w bardziej bezpośrednie zdanie, nie podnosząc pewności; zmniejsza twierdzenie bez pokrycia albo je usuwa; a gdy brakującego szczegółu nie da się obejść, zgłasza lukę albo pyta. Do tego zakaz: żadnych wymyślonych liczb, przykładów, klientów, źródeł ani opinii po to, żeby tekst brzmiał po ludzku.
Trzecia reguła to test przenośności. Jeśli zdanie da się bez zmian przenieść do innej firmy, ministerstwa, produktu, projektu albo osoby, to prawdopodobnie jest wypełniaczem (SKILL.md miodkuj, tłumaczenie własne).
Pary przed i po z pliku references/examples.md pokazują, co to znaczy w praktyce:
| Problem | Przed | Po |
|---|---|---|
| Styl urzędowy | W celu dokonania zgłoszenia należy wypełnić niniejszy formularz. | Wypełnij ten formularz, żeby zgłosić sprawę. |
| Rzeczowniki odczasownikowe | Przeprowadzenie analizy danych umożliwiło identyfikację kluczowych obszarów wymagających optymalizacji. | Analiza danych pozwoliła wskazać kluczowe obszary wymagające optymalizacji. |
| Reklama bez dowodu | Nasze kompleksowe rozwiązanie stanowi kluczowy element skutecznej transformacji cyfrowej. | Nasze rozwiązanie wspiera transformację cyfrową. |
| Krążenie synonimów | Agent analizuje zgłoszenie. Asystent wybiera kategorię. Następnie narzędzie przekazuje sprawę konsultantowi. | Agent analizuje zgłoszenie, wybiera kategorię i przekazuje sprawę konsultantowi. |
| Pseudogłębokie zakończenie | Zespół nadal używa trzech definicji aktywnego klienta. Dane są walutą przyszłości. | Zespół nadal używa trzech definicji aktywnego klienta. |
W drugiej parze zostało słowo “kluczowych”. Miodkuj reaguje na skupiska usterek, a pojedyncze takie słowo zostawia. W trzeciej parze działa drabina konkretu: tekst nie podawał dowodu, więc twierdzenie zmalało.
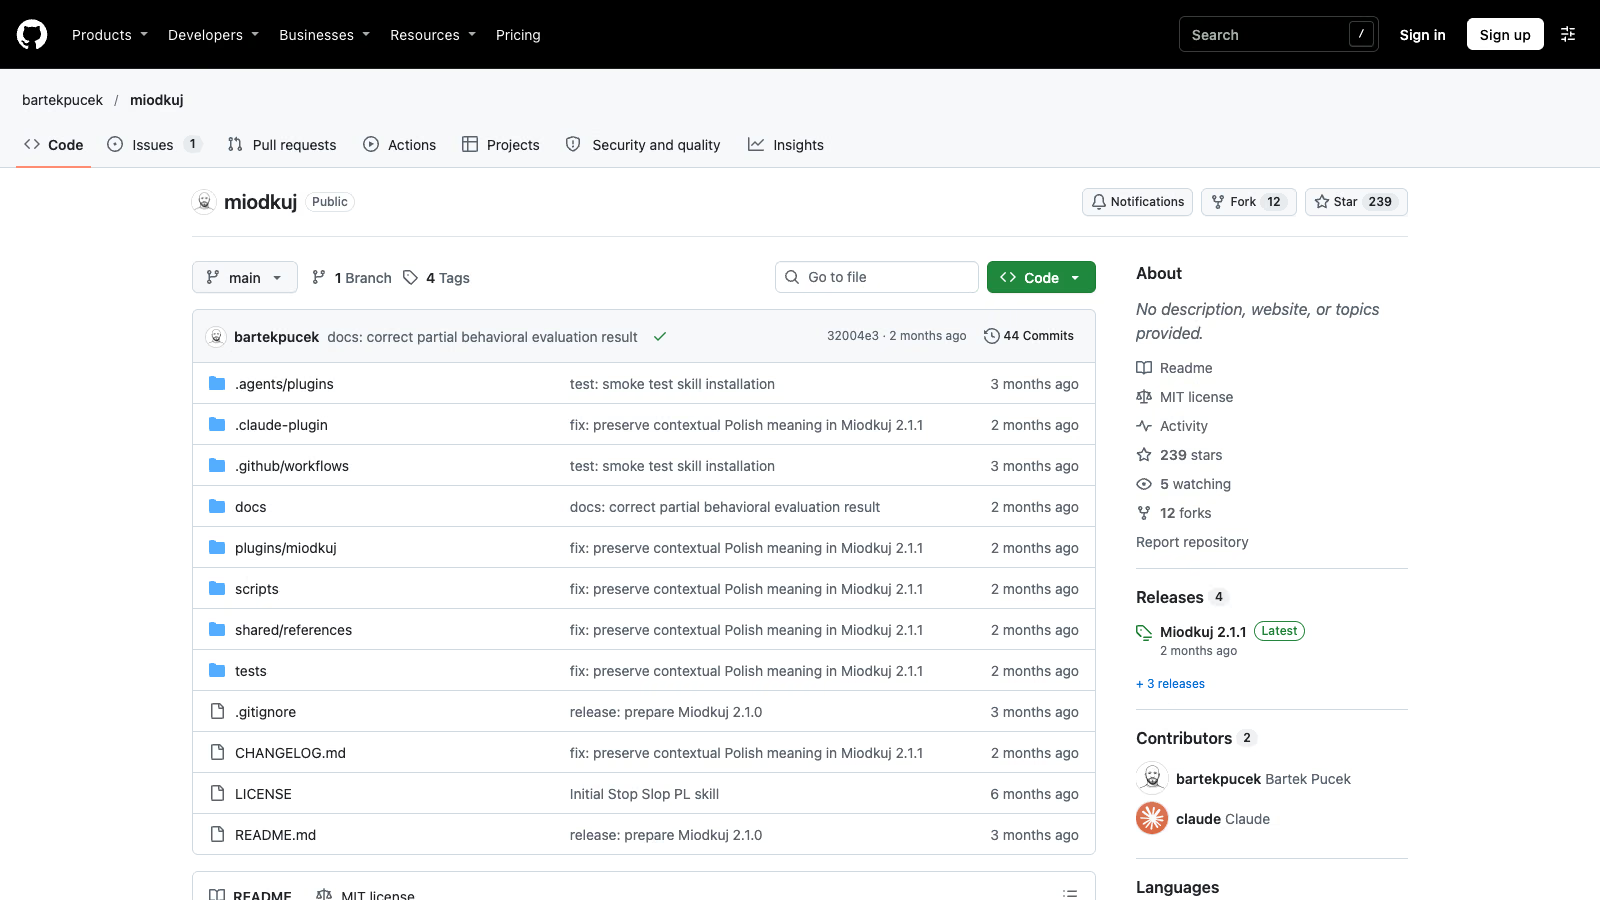
Instalacja w Claude Code według README: /plugin marketplace add bartekpucek/miodkuj, potem /plugin install miodkuj@miodkuj i /reload-plugins. Tak zainstalowany skill wywołasz jako /miodkuj:miodkuj, bo Claude Code dopisuje nazwę wtyczki przed nazwą skilla. Krótkie /miodkuj dostaniesz tylko po ręcznym skopiowaniu katalogu plugins/miodkuj/skills/miodkuj do ~/.claude/skills/miodkuj. Ja tak zrobiłem i zapisałem w pliku SOURCE.txt commit, z którego kopiowałem. W Codex: codex plugin marketplace add bartekpucek/miodkuj, codex plugin add miodkuj@miodkuj, wywołanie $miodkuj.
Dlaczego czysty skan nie oznacza dobrego tekstu
README unslop: “Skanery podsuwają kandydatów, a agent sprawdza każde użycie w kontekście”. Zaraz dalej: “Ani czysty skan, ani znajomo brzmiąca fraza nie dowodzą, kto napisał tekst, a kontrole nie gwarantują, że zniknęła każda usterka” (README unslop, tłumaczenie własne).
Wikipedia, z której listy wzorców korzysta humanizer, ostrzega w tym samym duchu: “Nie traktuj tych oznak po prostu jako problemów do usunięcia; to mogłoby jedynie utrudnić wykrywanie” (Wikipedia: Signs of AI writing, tłumaczenie własne). Tekst, z którego wycięto wszystkie słowa z listy, nadal może być pusty. Jest tylko trudniejszy do rozpoznania.
Widzę to na własnym repozytorium. 6 listopada 2026 r. uruchomiłem trzy bramki na całym korpusie i wszystkie dały zero trafień: check:slop-rhetoric przeskanował 8681 plików, check-ai-slop-copy.mjs --check nie znalazł żadnej kalki, a check-voice-rules.mjs na trzech wybranych wpisach zwrócił 0 naruszeń. Zero mówi, że listy zakazanych fraz są czyste. O jakości prozy mówi tyle, ile mówi czysty skan w unslop.
 Repozytorium blader/humanizer: licencja MIT, wydanie v3.1.0 (zrzut z 6 listopada 2026).
Co sprawdzają bramki w moim repozytorium
Skrypty działają na całym serwisie, ale dla polskiego tekstu liczą się te poniżej. Liczby policzyłem w kodzie źródłowym.
| Skrypt | Co sprawdza | Liczba reguł | Czy blokuje |
|---|---|---|---|
check-voice-rules.mjs | Słowa i linie: długie myślniki, puste czasowniki, zmyślone okrągłe statystyki, nazwy-zaślepki, wycieki znaków CJK, kalki w polskich i portugalskich tekstach, nagłówki z wielkich liter | 42 reguły, z tego 16 z prefiksem pl- | Domyślnie tylko raportuje; kod 1 z --fail-on-findings, które ustawiają skrypty npm dla treści, danych i komponentów |
check-slop-rhetoric.mjs | Kształt zdania w sześciu językach, wzorce wzięte ze skilla no-ai-slop | 12 wzorców, colon-reveal włączany ręcznie, więc domyślnie 11 | Wersja :gate ma budżet 0 i blokuje npm run check |
check-ai-slop-copy.mjs | Stała lista angielskich kalek z żargonu agencji | 9 wzorców | Kod 1 z --check; nie czyta src/content, tylko szablony i kilka plików |
check-loanword-density.mjs | Angielski żargon w zmienionych plikach nieangielskich | Pada przy co najmniej 12 trafieniach i co najmniej 5 na 1000 słów | Tak, w npm run check |
check-diacritic-wordlist.mjs | Słowa z wyciętymi polskimi znakami, z jawnej listy zakazów dla każdego języka | Lista dla polskiego w kodzie | Tak, z --check |
Skrypt do formy zwracania się do czytelnika (check-reader-address.mjs) pilnuje tylko niemieckiego, hiszpańskiego i portugalskiego. Polskiego “ty” żaden skrypt nie sprawdza, to zostaje na miodkuj i na mnie.
Skrypt do zapożyczeń powstał po konkretnym wpisie z października 2026 r. Przeszedł audyt faktów i wszystkie bramki tekstu, a w polskiej wersji miał 68 trafień angielskiego żargonu, 27,5 na 1000 słów. Żadna bramka wtedy tego nie liczyła. Każdą nową regułę dopisuję w ten sposób: najpierw konkretna usterka na stronie, potem skrypt, który ją łapie.
Ten artykuł przepuściłem przez te same skrypty przed publikacją. check-voice-rules.mjs zwrócił 0 naruszeń, check-slop-rhetoric.mjs 0 trafień, a skrypt do zapożyczeń zmieścił plik poniżej progu. Jedno trafienie dał dopiero wzorzec colon-reveal, włączany ręcznie: zdanie o teście przenośności zaczynało się od dwukropka z zapowiedzią. Rozbiłem je na dwa zdania. Skrypty nie oceniły, czy artykuł jest dobry. To sprawdziły humanizer, miodkuj i moje czytanie.
Jak wpiąć skaner unslop w CI, żeby blokował tylko twarde błędy
README unslop mówi, że każdy skaner zwraca JSON i kończy się kodem różnym od zera, gdy coś znajdzie. Z kodu źródłowego wynika szczegół, który zmienia sposób użycia w CI: banned_phrase_scan.py kończy się kodem 1 przy każdym trafieniu, bez względu na wagę. W źródle jest 38 wpisów z wagą hard i 14 z wagą soft. structure_scan.py i silhouette_scan.py oznaczają każde trafienie jako soft i też kończą się kodem 1. Kod wyjścia nie odróżni więc twardego błędu od uwagi stylistycznej. O blokadzie musi decydować pole by_severity w JSON.
Drugi szczegół dotyczy wszystkich, którzy piszą w innym języku niż angielski. Każdy skaner najpierw sprawdza, czy tekst wygląda na angielski (udział angielskich słów funkcyjnych co najmniej 0,10). Gdy nie wygląda i nie dał trafień, skaner wypisuje {"non_english": true, ...}, na stderr informuje, że odmawia pracy, i kończy się kodem 0. Dla polskiego README zielony wynik znaczy tylko tyle, że skaner go nie przeczytał.
Poniższy krok napisałem na podstawie lektury kodu skanerów, bez uruchamiania ich u siebie. Przypnij konkretny commit i przeczytaj kod przed pierwszym użyciem.
name: prose-gates
on: pull_request
jobs:
  unslop-hard-only:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
        with:
          fetch-depth: 0
      - uses: actions/setup-python@v5
        with:
          python-version: "3.11"
      - name: Fetch unslop at a pinned commit
        run: |
          git clone https://github.com/theclaymethod/unslop /tmp/unslop
          git -C /tmp/unslop checkout 17ed39c9d0b522f44190ff0c6233867eadee192a
      - name: Block only hard findings, report the rest
        run: |
          fail=0
          for f in $(git diff --name-only --diff-filter=AM "origin/${{ github.base_ref }}" -- '*.md'); do
            set +e
            python3 /tmp/unslop/scripts/banned_phrase_scan.py "$f" > scan.json
            code=$?
            set -e
            if [ "$code" -eq 2 ]; then echo "::error file=$f::unreadable"; fail=1; continue; fi
            python3 - "$f" <<'PY' || fail=1
          import json, sys
          f = sys.argv[1]
          d = json.load(open("scan.json"))
          if d.get("non_english"):
              print(f"::warning file={f}::not checked (non-English)")
              sys.exit(0)
          hard = d.get("by_severity", {}).get("hard", 0)
          hard = len(hard) if isinstance(hard, list) else hard
          soft = d.get("by_severity", {}).get("soft", 0)
          soft = len(soft) if isinstance(soft, list) else soft
          print(f"{f}: hard={hard} soft={soft}")
          sys.exit(1 if hard else 0)
          PY
          done
          exit $fail
Uwagi miękkie trafiają do logu, twarde zatrzymują pull request. Ostrzeżenie not checked dla plików nieangielskich jest tu celowo widoczne, żeby nikt nie wziął go za zaliczenie. structure_scan.py przyjmuje --genre docs, który według README dopuszcza listy z pogrubionymi etykietami, typowe dla dokumentacji referencyjnej. Dla README i dokumentacji API ma to sens.
Dla plików polskich ten krok nic nie da. Tam deterministyczną warstwę tworzą własne skrypty z listą zakazanych fraz po polsku, takie jak opisane wyżej, a ocenę zdań robi miodkuj przed commitem.
Jak sprawdzić, czy przepisanie zachowało fakty
Unslop ma do tego osobny skrypt, validate_preservation.py. Porównuje oryginał z wersją przepisaną i zwraca passed, liczbę zachowanych i zgubionych ograniczeń oraz ostrzeżenia.
python3 /tmp/unslop/scripts/validate_preservation.py --strict original.md rewritten.mdFlaga --strict działa tylko jako pierwszy argument. Kod sprawdza dokładnie args[0] == "--strict", więc w każdym innym miejscu zostanie odczytana jako nazwa pliku. Z tą flagą ostrzeżenia o zmianie znaczenia (przeczenia, zakres, zdania warunkowe) też kończą się kodem 1. Kod 2 oznacza plik, którego nie da się odczytać. Opcjonalny trzeci argument to plik JSON z ograniczeniami, które muszą przetrwać.
Na tekście polskim tego nie sprawdzałem i nie wiem, jak skrypt radzi sobie z polską odmianą. U siebie zachowanie faktów sprawdzam inaczej: miodkuj ma w regułach zakaz zmiany liczb, dat, nazw, linków i cytatów, a ja czytam różnicę w git diff przed commitem.
Aktualizacja, . Przepisanie porównuje nowy tekst ze szkicem, więc błędną liczbę zachowa równie wiernie jak poprawną. Jeśli liczbę podał asystent AI, otwórz jego przypis i dojdź do badania, które ją zmierzyło. Trakkr, firma sprzedająca monitoring widoczności marek w wyszukiwarkach AI, opublikowała 28 października 2026 analizę Zombie stats. Zadała ChatGPT, Perplexity, Gemini, Claude i Google AI Overviews 200 pytań, na które odpowiedzią jest liczba, i prześledziła 1285 cytowanych statystyk do pięciu stron w głąb. 40% doprowadziło do badania, które mówi to samo, 8% do badania z inną liczbą albo innym kontekstem, 40% urwało się na źródle, którego nie dało się sprawdzić, a 11% nie prowadziło nigdzie. Każdy z pięciu asystentów powtarzał, że 44% handlowców rezygnuje po jednym ponownym kontakcie. Ta liczba pochodzi z przykładowego artykułu freelancera, który był w sieci już w 2017 roku i nie powołuje się na żadne badanie. Jeśli ślad kończy się na stronie, której nie da się sprawdzić, usuń liczbę albo napisz w tekście, że jej nie potwierdziłeś.
Jak udostępnić jeden skill Claude Code, Codex i Cursorowi
Instalacja humanizera według README: w Claude Code /plugin marketplace add blader/humanizer, potem /plugin install humanizer@humanizer, wywołanie /humanizer:humanizer. Wtyczka wymaga Claude Code 2.1.142 lub nowszego; na starszych wersjach npx skills add blader/humanizer --global --agent claude-code. Dla Codex npx skills add blader/humanizer --global --agent codex, dla innych agentów --agent '*'.
Gdy zespół trzyma własne skille w repozytorium, jeden katalog wystarczy dla kilku narzędzi. Dokumentacja Claude Code mówi, że wpis <nazwa-skilla> w lokalizacji osobistej (~/.claude/skills/) albo projektowej (.claude/skills/) może być dowiązaniem symbolicznym do katalogu w innym miejscu na dysku. Claude Code czyta wtedy SKILL.md z celu i ładuje skill raz, nawet gdy wskazuje na niego kilka lokalizacji (dokumentacja skilli). Skill osobisty działa we wszystkich projektach na tej maszynie, ale nie w sesjach w chmurze. Skill projektowy commitujesz, żeby miał go cały zespół.
W moim repozytorium katalog .cursor/skills/ trzyma sześć względnych dowiązań do ../../.claude/skills/<nazwa>. Kris Geusebroek z Xebii opisuje ten sam wzorzec dla wtyczek (Xebia, 3 kwietnia 2026): wspólny katalog skills na górze projektu i dowiązania ze ścieżką względną. Ścieżka bezwzględna działa tylko na dysku osoby, która ją utworzyła.
mkdir -p .cursor/skills
ln -s ../../.claude/skills/docs-style .cursor/skills/docs-style
git add .cursor/skills/docs-style
git ls-files --stage .cursor/skills/docs-style
# 120000 <hash> 0  .cursor/skills/docs-style
Tryb 120000 w wyniku git ls-files --stage oznacza, że git zapisał dowiązanie symboliczne. Na Windows tworzenie dowiązań wymaga włączonego trybu dewelopera albo uprawnień administratora; Xebia radzi zapisać to w README, a dokumentacja Claude Code podaje mklink /D z wiersza poleceń uruchomionego jako administrator.
Wtyczki rządzą się innymi regułami (dokumentacja marketplace). Dowiązanie wewnątrz katalogu wtyczki zostaje względne. Dowiązanie do innego miejsca w tym samym marketplace jest rozwijane, czyli treść trafia do pamięci podręcznej jako kopia. Dowiązanie poza marketplace zostaje pominięte ze względów bezpieczeństwa. Jeśli publikujesz skill jako wtyczkę, wspólny katalog musi leżeć w obrębie marketplace.
Na co uważać przy licencji unslop
SKILL.md unslop ma w nagłówku license: MIT, ale repozytorium nie ma pliku LICENSE. Endpoint licencji w API GitHuba zwraca 404, a pole license w danych repozytorium jest puste. Zanim włączysz unslop do firmowego CI albo skopiujesz jego skanery do własnego repozytorium, wyjaśnij to z działem prawnym albo poproś autora o dodanie pliku. Humanizer i miodkuj mają plik licencji MIT.
Prompty do skopiowania
Dla polskiej dokumentacji w Claude Code, po zainstalowaniu obu skilli jako katalogów osobistych:
Run /humanizer in file mode on docs/README.pl.md. Change prose only; keep code blocks,
commands, paths, YAML and link targets unchanged. Then run /miodkuj in file mode on the
same file. Minimum edit; do not add numbers, examples or claims that are not in the file.
Show me git diff when done.
Dla angielskich informacji o wydaniu, z unslop i kontrolą faktów:
Copy CHANGELOG.md to /tmp/original.md. Run /unslop cleanup on CHANGELOG.md and list the
suggestions without editing. After I approve a subset, apply only those, then run
python3 scripts/validate_preservation.py --strict /tmp/original.md CHANGELOG.md
and stop if it exits non-zero.
Dla przeglądu przed commitem, gdy nie chcesz przepisywania:
Audit docs/guide.pl.md with /miodkuj in audit mode. Quote each problem, mark it
red, yellow or green, and suggest a direction. Do not rewrite the file.
Prompty piszę po angielsku, bo tak są napisane same skille. Tekst, który przepisują, zostaje w swoim języku.
Od czego zacząć w swoim zespole
Zacznij od jednego typu tekstu, na przykład README albo informacji o wydaniu. Do tekstów polskich dodaj miodkuj jako obowiązkowy przebieg przed commitem, do angielskich krok CI z unslop, który blokuje tylko twarde błędy i ostrzega przy plikach nieangielskich. Po miesiącu policz, które uwagi wracają, i z nich zrób własną listę zakazanych fraz w swoim języku. Aktualne oceny narzędzi AI, których używam, prowadzę w radarze technologii.
Jeśli chcesz, żebym ustawił taki przepływ w twoim repozytorium (skille, dowiązania dla kilku agentów, krok w CI i własne skrypty dla polskiego), opisz swój przypadek na stronie wdrożeń AI. Odpowiem mailem z planem dla twojego zespołu.