Dziennik zmian dokumentacji Google Search Central z 1 października 2026 roku wymienia jedną zmianę: poradnik o używaniu treści generowanych przez AI został uzupełniony o informacje z wytycznych dla oceniających jakość (Search Quality Raters guidelines). Strona z zasadami antyspamowymi była ostatnio aktualizowana 28 sierpnia 2026 roku. W branży marketingowej natychmiast pojawiły się głosy o końcu publikacji wspieranych przez AI. Fakty i dostępne dane pokazują inny obraz. Zasada antyspamowa dotyczy wielu stron tworzonych głównie po to, by manipulować rankingiem, bez względu na to, jak powstały. Użycie modelu językowego nie jest tu wyzwalaczem.
Korekta, 20 listopada 2026. Wcześniejsza wersja tego artykułu błędnie datowała zmiany w Google i opisywała mechanizmy, których Google nigdy nie opublikował. Dziennik zmian dokumentacji z 1 października 2026 roku wymienia jedną zmianę w poradniku o treściach generowanych przez AI. Opis sposobu liczenia contentEffort oraz twierdzenia o klasyfikatorach obrazu zostały usunięte.
Prowadząc serwis firmowy na WordPressie, sklep internetowy na WooCommerce lub aplikację w architekturze headless, musisz zrozumieć matematyczne i inżynieryjne mechanizmy, którymi wyszukiwarka ocenia Twoje publikacje. W tym przewodniku rozkładamy na czynniki pierwsze wskaźnik contentEffort ujawniony w dokumentach algorytmicznych Google, zestawiamy deklaracje firmy z niezależnymi badaniami Ahrefs i Lily Ray, a także przedstawiamy gotowe procedury techniczne chroniące podstrony miast, definicje słownikowe oraz profile eksperckie przed bolesnymi spadkami widoczności.
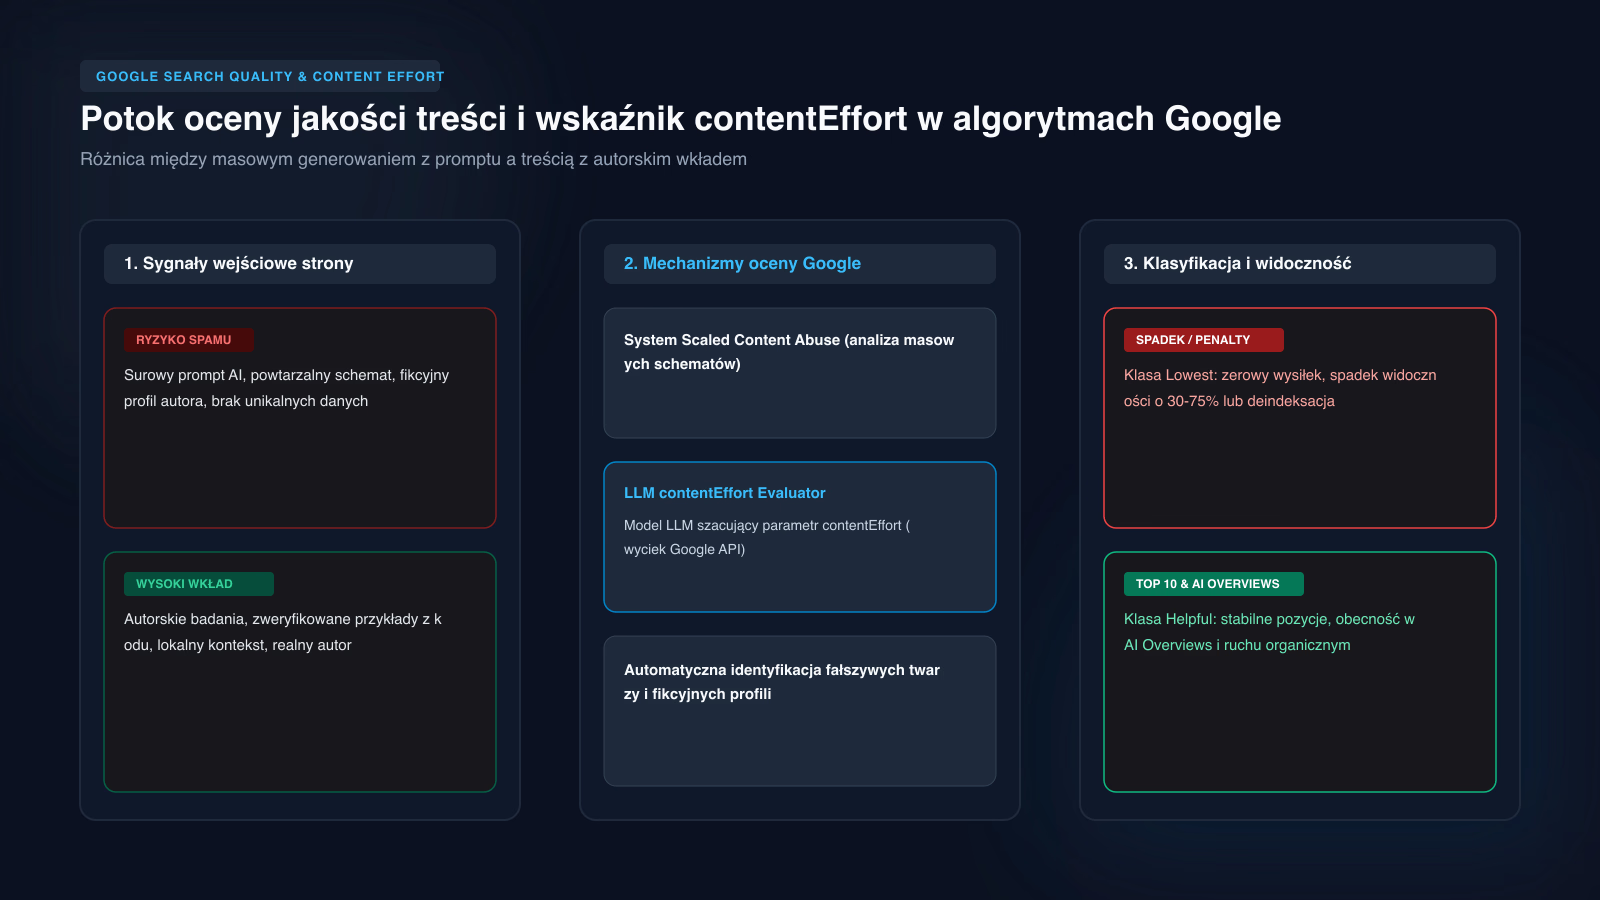
Potok oceny jakości treści przez algorytmy Google: od sygnałów wejściowych, przez wskaźnik contentEffort i klasyfikatory spamu, aż po decyzję o widoczności. Źródło: analiza własna wppoland.com na podstawie Google Search Essentials, stan na 1 listopada 2026 roku.
Czy teksty z ChatGPT dostaną bana w Google?
Najczęstsze pytanie zadawane przez właścicieli firm i menedżerów marketingu brzmi: czy publikowanie tekstów napisanych przez ChatGPT, Claude lub inne modele generatywne wiąże się z automatyczną karą od Google? Odpowiedź inżynieryjna brzmi: nie, o ile treść rozwiązuje problem użytkownika i reprezentuje realny wkład pracy.
W oficjalnych zasadach dotyczących spamu (Spam Policies for Google Web Search) firma od dawna nie zakazuje korzystania z automatyzacji. Kluczowa zmiana semantyczna zaszła w punkcie dotyczącym nadużyć treści tworzonych na dużą skalę (scaled content abuse). Google zdefiniowało ten proceder następująco:
Nadużycie treści tworzonych na dużą skalę polega na generowaniu wielu stron w celu manipulowania rankingami w wyszukiwarce, a nie pomagania użytkownikom. Ta nieuczciwa praktyka zazwyczaj polega na tworzeniu dużych ilości nieoryginalnych treści, które zapewniają użytkownikom niewielką wartość lub nie dają jej wcale, bez względu na to, jak zostały stworzone.
Google Search Central, Spam Policies, sekcja Scaled content abuse (tłumaczenie własne)
Zwróć uwagę na ostatnie sformułowanie: “bez względu na to, jak zostały stworzone”. Zasada nie rozróżnia copywritera, tłumacza posiłkującego się słownikiem i modelu językowego. Liczy się to, czy wiele stron powstało głównie po to, by manipulować rankingiem, zamiast pomagać użytkownikom. Jeśli Twoja strona serwuje gęsty blok tekstu będący jedynie powtórzeniem dziesięciu innych witryn z rankingu, podpada pod tę zasadę.
Po stronie oceniających Search Quality Rater Guidelines (z 11 września 2025 roku) wymieniają funkcje strony, takie jak kalkulatory i gry, jako treść główną (Main Content). To wskazówka dla ludzkich oceniających, a nie zmiana wprowadzona 1 października. Strona ze 300 słowami konkretnego wprowadzenia i działającym kalkulatorem leasingowym może lepiej służyć użytkownikowi niż 3000 słów ogólnego wywodu o historii pożyczek.
Jeżeli zarządzasz serwisem firmowym i chcesz sprawdzić, jak Twoje strony radzą sobie z wymogami nowych wytycznych, punktem wyjścia jest profesjonalny audyt techniczny i weryfikacja architektury treści. W WPPoland realizujemy takie analizy w ramach usługi sprawdzenie strony WordPress, badając zarówno jakość renderowania, jak i zgodność z normami wyszukiwarek.
Czym jest wskaźnik contentEffort w wycieku algorytmów Google?
W maju 2024 roku wyciekły tysiące stron wewnętrznej dokumentacji interfejsów programistycznych Google. Niezależni specjaliści, w tym SparkToro i iPullRank, przeanalizowali zawarte w niej nieudokumentowane wcześniej atrybuty.
Jednym z nich jest contentEffort. W wyciekłej dokumentacji (moduł QualityNsrPQData) opisano go jedynie jako “oparte na LLM oszacowanie wysiłku dla stron z artykułami” (tłumaczenie własne). To cały zweryfikowany opis. Google nie opublikował, jak ta wartość jest liczona, jakich danych używa ani jaką wagę ma w rankingu.
Traktuj ją jako wskazówkę kierunku, a nie wynik, który da się zmierzyć i optymalizować. Strony wnoszące oryginalne dowody (własne pomiary, zrzuty ekranu, kod, dane z wdrożeń) stoją lepiej niż strony powtarzające to, co jest już na pierwszej stronie wyników, niezależnie od tego, co to pole robi wewnątrz Google.
Wytyczne dla oceniających wskazują ten sam kierunek. Obowiązujące Search Quality Rater Guidelines (z 11 września 2025 roku) używają w sekcji 4.6.6 sformułowania “niewielki lub żaden wysiłek” (tłumaczenie własne) wobec treści głównej bez realnego wkładu pracy.
Ile stron z AI naprawdę znajduje się w top 10 Google?
Wokół skuteczności sztucznej inteligencji w pozycjonowaniu narosło wiele skrajnych mitów. Jedni twierdzą, że AI pozwala opanować każdą niszę w tydzień, inni ostrzegają przed natychmiastowym banem. Aby oprzeć strategię na faktach, warto sięgnąć po twarde pomiary rynkowe przeprowadzone przez czołowe platformy analityczne.
W głośnym badaniu opublikowanym przez firmę Ahrefs przeanalizowano tysiące zapytań o wysokim wolumenie wyszukiwań, badając nasycenie pierwszych dziesięciu wyników Google treściami wygenerowanymi przez sztuczną inteligencję. Wyniki przyniosły zaskakujące wnioski:
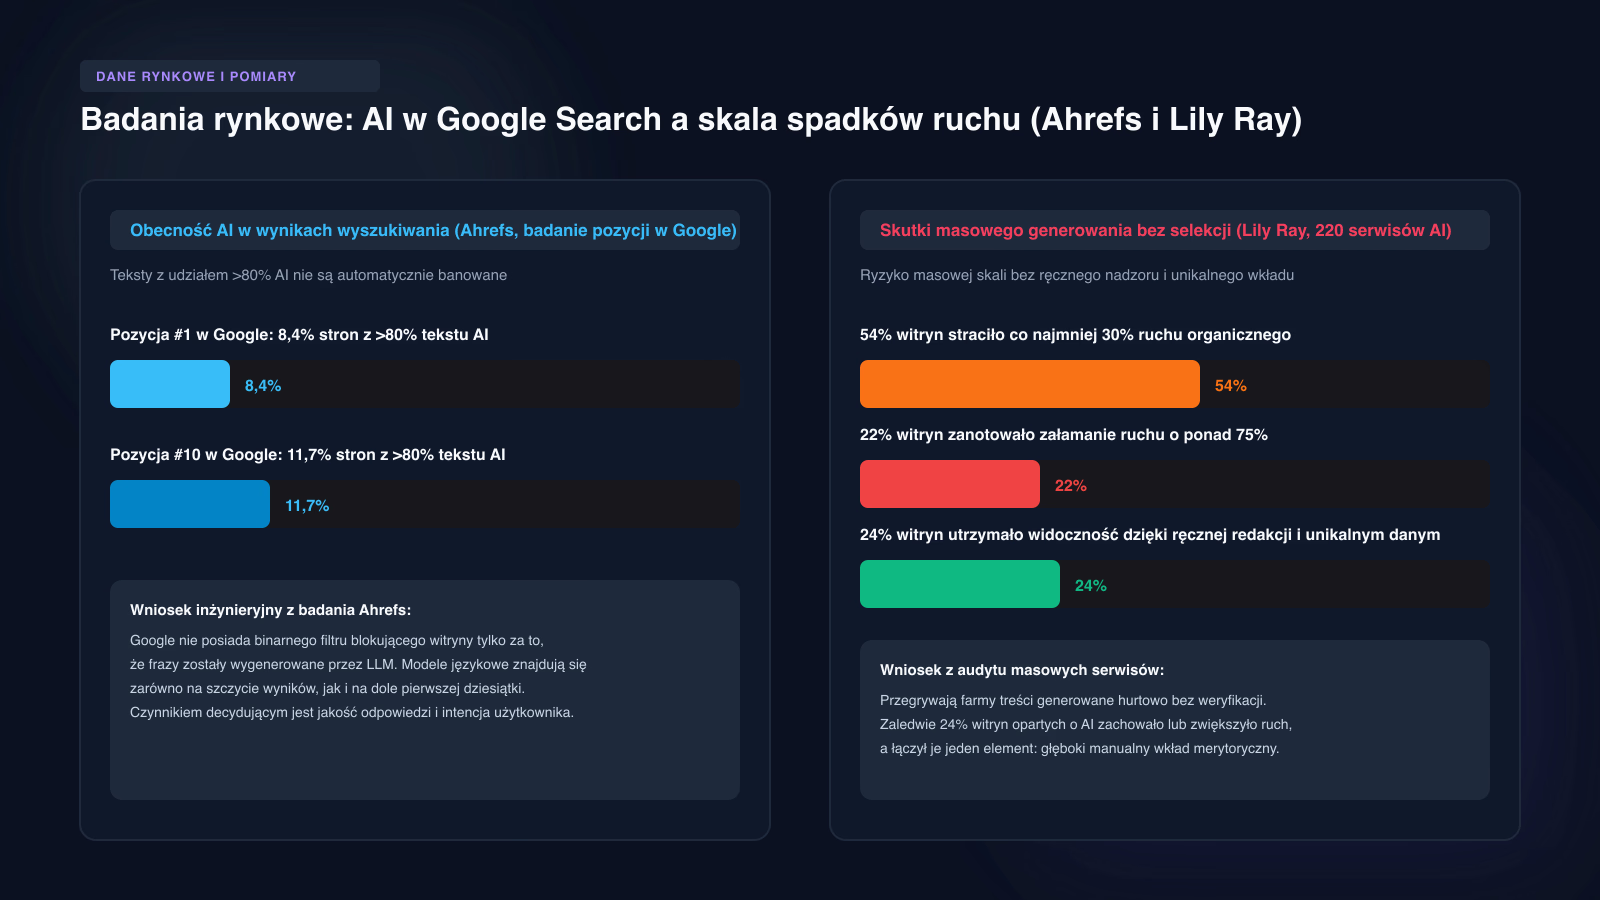
Odsetek stron z co najmniej 80% treści AI na pozycjach 1 i 10 według Ahrefs oraz skala spadków ruchu w serwisach ze strategią opartą na AI opisana przez Lily Ray. Źródła: badanie Ahrefs o treściach AI oraz Lily Ray w Search Engine Journal.
Na pierwszej pozycji w organicznych wynikach Google 8,4% badanych stron zawierało co najmniej 80% treści wygenerowanej przez AI. Na pozycji dziesiątej odsetek ten wynosił 11,7%.
Te liczby pokazują, że sam model językowy nie wyklucza strony z top 10. Nie pokazują, dlaczego te strony się tam znajdują: prawdopodobne czynniki to autorytet domeny, profil linków, doświadczenie użytkownika i dopasowanie do intencji zapytania, ale badanie ich nie rozdziela.
Inaczej wygląda sytuacja serwisów, które potraktowały generatory jako fabrykę hurtowych publikacji. Lily Ray opisała w Search Engine Journal 220 serwisów ze strategią opartą na treściach AI:
- 54% straciło co najmniej 30% ruchu organicznego.
- 22% straciło co najmniej 75% ruchu organicznego.
Ryzyko nie tkwi zatem w samej technologii, lecz w iluzji, że algorytm wyszukiwarki da się oszukać prostym skryptem z pętlą zapytań do API OpenAI. W WPPoland pomagamy firmom, które ucierpiały wskutek takich wdrożeń, realizując zaawansowaną usługę naprawa stron zrobionych przez AI, gdzie przekształcamy zdezaktualizowane farmy treści w pełnowartościowe zasoby biznesowe.
Jakie typy stron tracą najwięcej ruchu po aktualizacjach Google?
Analizując serwisy, które zanotowały głębokie spadki widoczności po ostatnich aktualizacjach, można wyodrębnić osiem powtarzających się formatów architektonicznych. Każdy z nich stanowi typowy cel dla systemów wykrywających nadużycia treści na dużą skalę.
Oto szczegółowy katalog ośmiu zagrożonych struktur:
Podstrony porównań produktowych par (np. Narzędzie A vs Narzędzie B). Twórcy witryn afiliacyjnych generują tysiące kombinacji produktów, wykorzystując prosty skrypt zestawiający dwa parametry. Ponieważ model generuje identyczny układ tabeli i ogólnikowe wnioski dla każdej pary, użytkownik nie otrzymuje żadnego realnego testu laboratoryjnego ani pomiaru wydajności.
Słowniczki pojęć i pojedyncze definicje leksykalne. Masowe tworzenie podstron wyjaśniających branżowe skróty (np. “co to jest CRM”, “co to jest ERP”) na 300 słów wyjętych z encyklopedii. Wyszukiwarka traktuje takie podstrony jako pasożytnicze, ponieważ użytkownik szukający definicji otrzymuje odpowiedź bezpośrednio w panelu AI Overviews lub wikipedii.
Rankingi stawiające twórcę bezkrytycznie na pierwszym miejscu. Artykuły typu “Top 10 agencji SEO” lub “Najlepsze oprogramowanie do faktur”, w których autor publikacji zawsze przyznaje sobie maksymalną ocenę, a konkurencji wybiórczo przypisuje wady. Brak obiektywnej metodologii testowej prowadzi do utraty wiarygodności w oczach raterów i algorytmów.
Podstrony typu “alternatywy dla [konkurencja]”. Masowo generowane landing page celujące we frazy brandowe rynkowych liderów (np. “alternatywa dla Shopify”, “alternatywa dla Asany”). Jeśli podstrona zawiera jedynie powierzchowne przepisanie cennika konkurenta, algorytmy szybko kwalifikują ją jako treść o niskim wkładzie.
Szablonowe podstrony miast i lokalizacji. Praktyka powszechna w lokalnym SEO, polegająca na stworzeniu jednego ogólnego tekstu o usługach hydraulicznych czy tworzeniu stron i powieleniu go dla 200 miast w Polsce poprzez prostą podmianę tokenu z nazwą miejscowości.
Farmy pytań i odpowiedzi pod Generative Engine Optimization (GEO/AEO). Tworzenie setek podstron z pytaniami z “People Also Ask” w nadziei na zdominowanie cytowań w modelach językowych Perplexity czy SearchGPT. Bez unikalnych danych źródłowych takie strony są natychmiast deindeksowane.
Treści niepowiązane tematycznie z profilem firmy (parasite SEO). Publikowanie artykułów o dietach, kredytach czy modzie na domenie sklepu ze sprzętem budowlanym w celu złapania jakiegokolwiek ruchu z długiego ogona. Google bezwzględnie weryfikuje tzw. topical authority (autorytet tematyczny domeny).
Masowe agregacje ofert bez własnej wartości dodanej. Sklepy i portale ogłoszeniowe, które pobierają opisy produktów z hurtowni przez feed XML i przepuszczają je przez generator synonimów AI. Brak unikalnych zdjęć, brak własnych recenzji i brak testów fizycznych oznacza zerowy wskaźnik contentEffort.
Wszystkie te formaty łączy jedna wada konstrukcyjna: powstały w celu oszukania algorytmu, a nie rozwiązania dylematu człowieka. W kolejnych sekcjach pokażemy, jak przebudować te struktury na przykładzie realnych wdrożeń WordPress i WooCommerce.
Jak zabezpieczyć strony miast przed filtrem za duplicate content?
Podstrony lokalne (np. /tworzenie-stron-warszawa/, /tworzenie-stron-krakow/, /tworzenie-stron-wroclaw/) to fundament pozyskiwania klientów dla firm usługowych i agencji. Niestety, większość wdrożeń na polskim rynku opiera się na karygodnym schemacie: ten sam artykuł na 1500 słów ma zmieniony nagłówek H1, podmienioną odmianę miasta w pierwszym akapicie i identyczną treść w pozostałych 90% kodu.
Gdy sieć adresów lokalnych różni się tylko nazwą miasta, pasuje to do przytoczonej wyżej definicji nadużycia treści na dużą skalę. Google nie opublikował mechanizmu kary dla całej domeny, więc bezpieczne założenie jest takie, że ucierpieć może cały serwis.
Aby skutecznie zabezpieczyć podstrony miast, musisz wdrożyć architekturę zróżnicowania lokalnego opartą na faktach, których model językowy nie jest w stanie wygenerować z automatu bez dostępu do Twojej bazy danych:
Krok pierwszy: Wprowadź realne studia przypadków powiązane z daną lokalizacją. Zamiast pisać ogólnikowo “tworzymy sklepy WooCommerce w Poznaniu”, przedstaw konkretne wdrożenie: dla jakiej wielkopolskiej firmy zrealizowałeś projekt, jakie integracje z lokalnymi magazynami wdrożyłeś i jakie wyzwania infrastrukturalne rozwiązano.
Krok drugi: Odnieś się do specyfiki lokalnego rynku i instytucji. Jeżeli świadczysz usługi doradcze lub technologiczne, wskaż właściwe terenowo instytucje, z którymi przedsiębiorca z danego regionu wchodzi w interakcje. W polskim porządku prawnym mogą to być właściwe izby administracji skarbowej, lokalne sądy gospodarcze prowadzące rejestr KRS, czy delegatury Wojewódzkich Inspektoratów Inspekcji Handlowej (WIIH) w sprawach konsumenckich.
Krok trzeci: Wstrzyknij unikalne dane infrastrukturalne i logistyczne. W przypadku sklepów internetowych i firm usługowych opisz lokalne opcje dostawy: współpracę z lokalnymi hubami kurierskimi, specyfikę odbioru osobistego, czy integracje z regionalnymi punktami nadań.
Krok czwarty: Dodaj mikrodane strukturalne zgodne ze stanem faktycznym. Fizyczną lokalizację opisuj tylko wtedy, gdy firma naprawdę ją ma. Firma pracująca w pełni zdalnie nie powinna zmyślać adresu biura, numeru telefonu ani współrzędnych. Zamiast tego może użyć areaServed z jednoznacznym odwołaniem do Wikidata.
Oto przykład schematu JSON-LD dla lokalnej podstrony usługowej. Wszystkie wartości to przykładowe zamienniki (example.com), podstaw własne dane:
{
  "@context": "https://schema.org",
  "@type": "ProfessionalService",
  "name": "Przykładowa Agencja WWW",
  "url": "https://example.com/warszawa/",
  "areaServed": {
    "@type": "City",
    "name": "Warszawa",
    "sameAs": "https://www.wikidata.org/wiki/Q270"
  }
}
Rygorystyczne nasycenie podstrony miejskiej unikalnym kontekstem sprawia, że materiał przechodzi test zróżnicowania. Konkurencja korzystająca z prostego skryptu AI nie jest w stanie wygenerować takiego zasobu jednym promptem.
Jak uchronić słowniczek pojęć i definicje przed spadkiem widoczności?
Słowniczki branżowe (glosariusze) były przez lata ulubionym narzędziem specjalistów SEO do szybkiego budowania tysięcy zaindeksowanych podstron. Generator AI otrzymywał listę 500 haseł i w kilka godzin tworzył bazę definicji. Po aktualizacjach algorytmów z 2026 roku takie serwisy traciły ruch: w próbie 220 stron opisanej przez Lily Ray 54% straciło co najmniej 30% ruchu.
Dlaczego tak się stało? Z punktu widzenia Google definicja słownikowa będąca jedynie parafrazą ogólnodostępnej wiedzy ma zerowy wskaźnik contentEffort. Kiedy użytkownik wpisuje w wyszukiwarkę “co to jest webhook w WooCommerce”, Google woli wyświetlić bezpośrednią odpowiedź w module AI Overview wygenerowaną przez własny model Gemini na podstawie oficjalnej dokumentacji, niż odsyłać internautę do kolejnego powierzchownego bloga.
Aby uratować sekcję słownikową i zabezpieczyć ją na przyszłość, należy zastosować metodę wzbogacania definicji o rzeczywisty przypadek wdrożeniowy (production proof).
Każde hasło w Twoim glosariuszu musi składać się z trzech nierozerwalnych warstw:
- Zwięzła, maksymalnie precyzyjna definicja techniczna (jedno do dwóch zdań pod kątem mechanizmów speakable i definicji leksykalnej).
- Rzeczywisty fragment kodu, konfiguracji lub zrzut ekranu z panelu produkcyjnego. Jeśli definiujesz pojęcie “Action Scheduler w WordPressie”, nie poprzestawaj na teorii. Pokaż, w której tabeli bazy danych (
wp_actionscheduler_actions) są zapisywane zadania, jak sprawdzić zakleszczone procesy zapytaniem SQL i jak odblokować kolejkę za pomocą WP-CLI. - Analiza najczęstszego błędu biznesowego lub architektonicznego. Wyjaśnij, czym grozi nieprawidłowe użycie danego mechanizmu w działającym sklepie WooCommerce.
Oto wzorcowy schemat struktury hasła słownikowego, który gwarantuje wysoką ocenę algorytmiczną:
| Element hasła | Błędne wdrożenie (ryzyko filtru AI) | Poprawne wdrożenie techniczne (wysoki contentEffort) |
|---|---|---|
| Definicja bazowa | Ogólny tekst wygenerowany z ChatGPT na 3 akapity o tym, że webhooki są ważne w nowoczesnym handlu internetowym. | Jednozdaniowa definicja techniczna: asynchroniczne powiadomienie HTTP POST wyzwalane przez zdarzenie w silniku sklepu. |
| Warstwa dowodowa | Brak kodu lub teoretyczny przykład pobrany z ogólnego tutoriala online. | Rzeczywisty kod filtra woocommerce_webhook_payload dostosowujący strukturę JSON do polskiego systemu ERP. |
| Diagnostyka błędów | Zdanie “czasami webhooki mogą nie działać prawidłowo”. | Szczegółowa tabela kodów błędów HTTP (401, 500, 504) wraz z instrukcją konfiguracji timeoutu w środowisku Cloudflare. |
| Prawo i zgodność | Brak odniesienia do regulacji. | Wskazanie wymogów RODO (art. 28 RODO) przy przekazywaniu danych osobowych klientów w ładunku webhooka do zewnętrznych procesorów. |
Gdy każda definicja w Twoim słowniczku zawiera unikalny kod, tabelę błędów i wskazówki architektoniczne, strona przestaje być podatna na deindeksację. Zyskuje status dokumentacji inżynierskiej, do której chętnie linkują inni deweloperzy.
Dlaczego wygenerowane zdjęcie autora i fałszywe bio to problem?
W ostatnich latach w sieci pojawiło się wiele serwisów, w których artykuły medyczne, prawne, finansowe czy techniczne podpisywano zmyślonymi nazwiskami z twarzami wygenerowanymi przez StyleGAN czy Midjourney. Twórcy takich witryn próbowali w ten sposób symulować spełnienie wytycznych E-E-A-T (Experience, Expertise, Authoritativeness, Trustworthiness).
Search Quality Rater Guidelines każą ludzkim oceniającym szukać obrazów wygenerowanych przez AI w fałszywych profilach autorów. Google nie opublikował, czy i jak wykrywa takie obrazy automatycznie. Opowieści o geometrii źrenic czy płatkach uszu to domysły, nie dokumentacja.
Problem jest praktyczny. Jeśli autor artykułu o optymalizacji baz danych czy prawie e-commerce nie ma żadnego weryfikowalnego śladu (brak profilu na LinkedIn, brak repozytorium GitHub, brak cytowań w branżowych publikacjach, brak wpisu w rejestrach gospodarczych), czytelnik i oceniający nie mają powodu wierzyć jego poradom.
W polskim porządku prawnym proceder ten rodzi również konsekwencje prawne. Ustawa o przeciwdziałaniu nieuczciwym praktykom rynkowym (Dz.U. 2023 poz. 506) w art. 5 i art. 6 wprost zakazuje wprowadzania konsumentów w błąd co do tożsamości przedsiębiorcy lub kwalifikacji osób świadczących usługi. Podpisywanie porady finansowej fikcyjnym tytułem “doradcy podatkowego” lub symulowanie opinii inżyniera oprogramowania przez zmyślony profil narusza zbiorowe interesy konsumentów i może być przedmiotem postępowań prowadzonych przez Urząd Ochrony Konkurencji i Konsumentów (UOKiK).
Jak prawidłowo wdrożyć profil autora na WordPressie?
- Podpisuj publikacje rzeczywistymi imionami i nazwiskami osób z Twojego zespołu, które posiadają realny wkład w dany projekt lub nadzorowały proces powstawania artykułu.
- Wstawiaj autentyczne fotografie w naturalnym otoczeniu biurowym lub technicznym, zoptymalizowane do formatu AVIF, bez upiększania filtrami generatywnymi.
- Wdróż mikrodane
Personw JSON-LD z właściwościamisameAslinkującymi do zweryfikowanych profili w serwisach branżowych (LinkedIn, GitHub, ORCID, Google Scholar, oficjalny rejestr samorządu zawodowego).
Oto minimalny blok schematu autora. Wszystkie wartości to przykładowe zamienniki (example.com), podstaw własne dane:
{
  "@context": "https://schema.org",
  "@type": "Person",
  "name": "Przykładowy Autor",
  "worksFor": {
    "@type": "Organization",
    "name": "Przykładowa Firma",
    "url": "https://example.com"
  },
  "url": "https://example.com/autor/przykladowy-autor/",
  "sameAs": [
    "https://github.com/przykladowy-autor",
    "https://www.linkedin.com/in/przykladowy-autor/"
  ]
}
Budowanie autentycznego profilu autora chroni zaufanie do domeny i stanowi mocny atut w konwersji biznesowej. Klienci korporacyjni podpisują umowy z ludźmi i doświadczonymi inżynierami, a nie z anonimowymi generatorami tekstu.
Czym jest test jednego promptu i jak go przeprowadzić na własnej stronie?
Jedną z najbardziej praktycznych heurystyk weryfikacji jakości treści pod kątem nowych algorytmów Google jest tzw. “test jednego promptu” (single prompt test). Został on sformułowany przez doświadczonych praktyków inżynierii odwrotnej wyszukiwarek jako odpowiedź na zalew wtórnych publikacji.
Zasada testu brzmi następująco: Jeżeli Twoja bezpośrednia konkurencja lub przypadkowy użytkownik jest w stanie otworzyć okno ChatGPT, wpisać jedno zapytanie (np. “Napisz artykuł o zaletach wdrożenia WooCommerce dla małej firmy”) i w rezultacie otrzymać materiał o strukturze, wnioskach i głębokości tożsamej z artykułem opublikowanym na Twojej stronie, to Twój artykuł ma zerową wartość defensywną dla algorytmów wyszukiwarki.
Taki tekst prędzej czy później zostanie zepchnięty na odległe pozycje, ponieważ w oczach modelu językowego Google nie posiada żadnego unikalnego wyróżnika entropijnego.
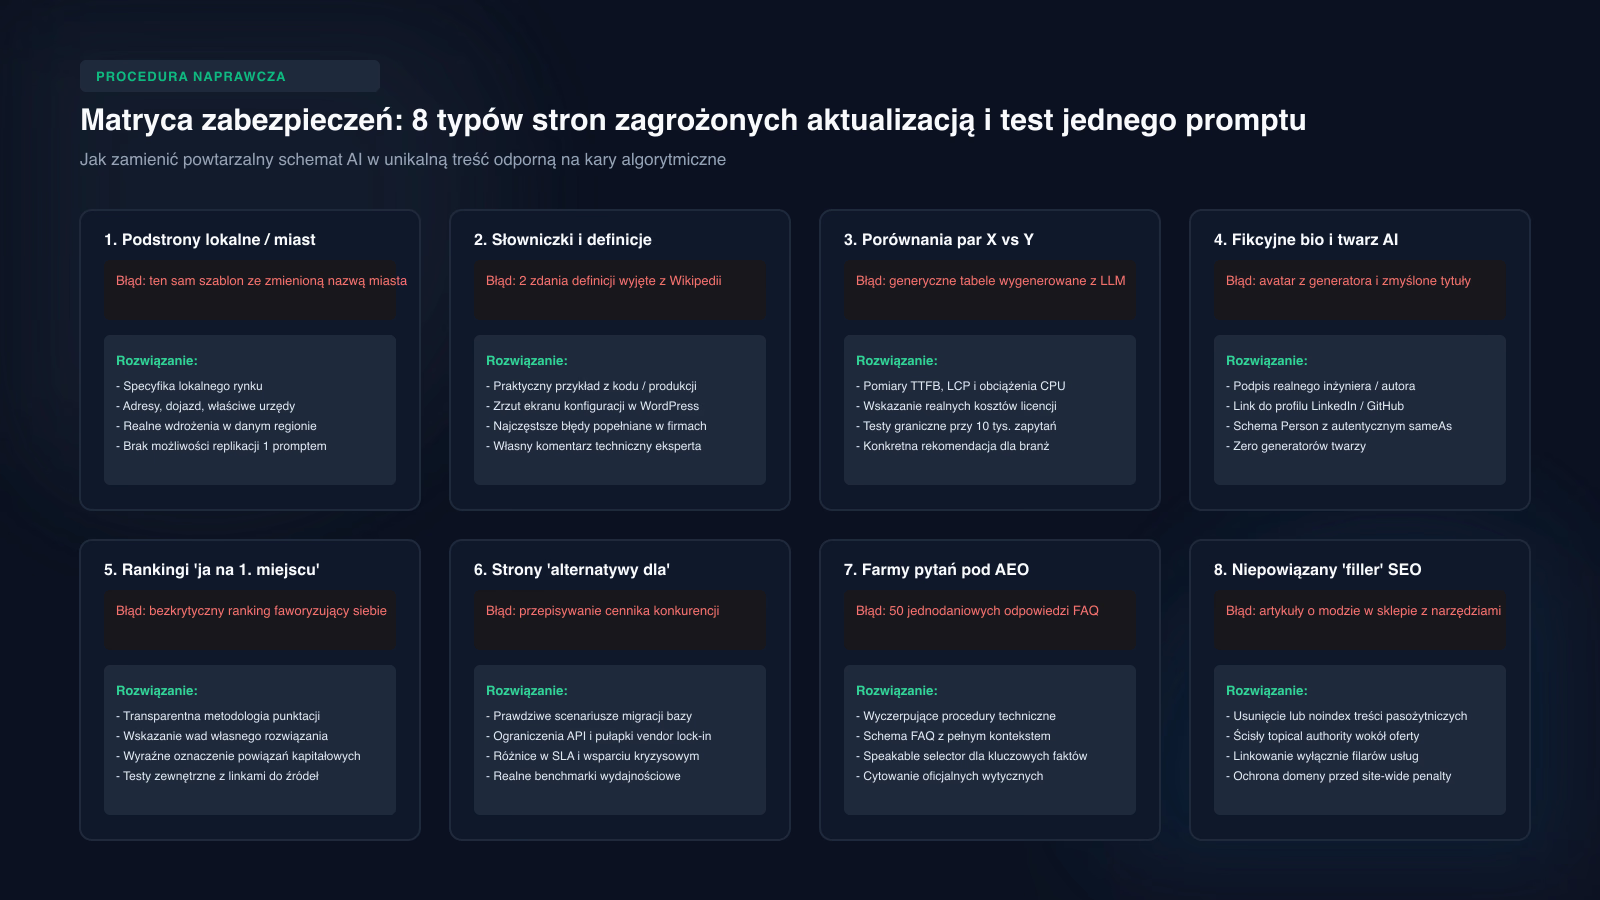
Matryca naprawcza dla 8 typów podstron podatnych na degradację algorytmiczną wraz z procedurami wzmacniania wkładu własnego. Źródło: metodyka inżynieryjna wppoland.com, stan na 2026 rok.
Jak przeprowadzić audyt testu jednego promptu na własnym blogu lub w sklepie internetowym?
Krok 1: Wybierz losowo 5 artykułów z sekcji bloga lub 5 opisów kategorii produktów w swoim sklepie WooCommerce. Krok 2: Otwórz model językowy (np. Claude 3.5 Sonnet lub ChatGPT-4o) i wpisz prompt odpowiadający tytułowi Twojego artykułu, bez podawania żadnych dodatkowych instrukcji. Krok 3: Porównaj wygenerowany tekst ze swoją publikacją, zadając sobie cztery bezkompromisowe pytania:
- Czy na Twojej stronie znajdują się jakiekolwiek liczby, daty, koszty lub parametry, których model nie podał w promptowym teście?
- Czy artykuł na Twojej stronie zawiera zrzut ekranu lub wykres pochodzący z Twoich własnych systemów produkcyjnych?
- Czy Twoja publikacja prezentuje jednoznaczne autorskie stanowisko techniczne (np. “odradzamy wtyczkę X z powodu wycieków pamięci w tabeli wp_options”), czy serwuje asekuracyjne ogólniki (“warto rozważyć zalety i wady obu rozwiązań”)?
- Czy w tekście znajduje się odniesienie do przepisów prawa, lokalnych uwarunkowań lub oficjalnych norm technicznych?
Jeśli na wszystkie cztery pytania odpowiesz “nie”, Twoja strona nie zdała testu jednego promptu. Każda kolejna aktualizacja Google Core Update będzie stanowiła dla niej bezpośrednie zagrożenie.
Aby zdać test jednego promptu, do każdej publikacji musisz dołożyć co najmniej jeden element, którego wygenerowanie z poziomu okna czatu jest fizycznie niemożliwe. Może to być:
- Raport z testu obciążeniowego serwera (np. pomiar narzędziem k6 dla 500 jednoczesnych koszyków w WooCommerce).
- Wynik analizy logów serwerowych nginx dotyczących wizyt Googlebota.
- Własne studium przypadku z konkretnymi liczbami (wzrost konwersji, spadek czasu ładowania LCP z 3,8 s do 0,9 s).
- Dedykowany fragment kodu w PHP lub TypeScript rozwiązujący nietypowy problem integracyjny.
Tak przygotowany materiał zyskuje odporność algorytmiczną. Nawet jeśli model AI przeczyta Twój artykuł i zindeksuje go w swojej bazie wektorowej, to Twoja domena pozostanie pierwotnym źródłem faktu (source of truth), co gwarantuje stałą obecność w cytowaniach AI Overviews oraz w czołówce tradycyjnych wyników SERP. W ramach projektów z zakresu optymalizacja GEO i LLMO wdrażamy w strukturach WordPressa precyzyjne mechanizmy semantyczne, które maksymalizują tę cytowalność.
Co zrobić, gdy sklep internetowy lub blog stracił 70% ruchu po aktualizacji?
Jeśli Twój serwis firmowy lub sklep WooCommerce zanotował gwałtowne załamanie ruchu po ostatnich aktualizacjach algorytmów Google, wpadanie w panikę i masowe kasowanie podstron jest najgorszym możliwym krokiem. Przywrócenie widoczności domeny wymaga chłodnej analizy inżynieryjnej i wdrożenia sekwencyjnego planu naprawczego.
Oto sprawdzona procedura ratunkowa w pięciu krokach:
Krok 1: Szczegółowa segmentacja w Google Search Console
Otwórz raport skuteczności w Google Search Console i porównaj dane z ostatnich 28 dni z analogicznym okresem sprzed aktualizacji. Podziel adresy URL na trzy odrębne koszyki:
- Podstrony, które straciły ponad 70% kliknięć i wyświetleń (główny cel audytu).
- Podstrony ze stabilnymi pozycjami (Twoje filary topical authority).
- Podstrony całkowicie wyindeksowane (potencjalne uderzenie filtru antyspamowego za scaled content).
Zidentyfikuj, które szablony ucierpiały najmocniej: czy były to podstrony miast, wpisy blogowe z generatora, czy może opisy kategorii produktowych w WooCommerce?
Krok 2: Bezwzględne usunięcie lub noindex treści pasożytniczych
Jeżeli w ramach wcześniejszych działań SEO na domenie opublikowano setki artykułów luźno powiązanych z Twoją ofertą (np. poradniki lifestylowe na stronie firmy sprzedającej oprogramowanie przemysłowe), musisz odciąć ten balast. Treści, które nie przynoszą konwersji i rozmywają profil tematyczny domeny, należy:
- Przekierować regułą 301 do najbardziej zbliżonego tematycznie artykułu głównego (jeśli podstrona posiada wartościowe linki zewnętrzne).
- Oznaczyć nagłówkiem HTTP
X-Robots-Tag: noindexlub tagiem meta robots, jeśli materiał musi pozostać dostępny dla dotychczasowych użytkowników. - Zwrócić kod odpowiedzi HTTP 410 Gone dla stron całkowicie bezwartościowych, zmuszając Googlebota do natychmiastowego usunięcia ich z indeksu.
Krok 3: Remediacja i nasycenie wartością kluczowych podstron generujących przychód
Wybierz 20% najważniejszych podstron z koszyka pierwszego, które w przeszłości generowały realne zapytania ofertowe lub sprzedaż w WooCommerce. Zastosuj do nich pełną procedurę ratunkową:
- Usuń ogólnikowe akapity generowane przez AI i zastąp je twardymi faktami technicznymi.
- Dodaj rzeczywiste zrzuty ekranu, schematy architektoniczne lub fotografie produktów.
- Zaimplementuj mikrodane Schema.org (Product, HowTo, FAQPage, TechnicalArticle) z autentycznymi powiązaniami encyjnymi Wikidata.
- Podpisz artykuły realnymi autorami z pełnym profilem eksperckim.
Krok 4: Optymalizacja techniczna i wyczyszczenie budżetu indeksowania (Crawl Budget)
Masowo generowane serwisy często cierpią na gigantyczny dług techniczny w warstwie wydajnościowej. Nadmierna liczba zapytań do bazy danych WordPress (wp_postmeta), wolne wykonywanie skryptów PHP oraz brak poprawnego buforowania powodują, że roboty sieciowe porzucają indeksowanie witryny z powodu przekroczenia limitów czasowych.
Wdróż twarde reguły wydajnościowe:
- Skonfiguruj buforowanie obiektowe w Redis lub Memcached dla zapytań WooCommerce.
- Wdróż agresywne buforowanie na krawędzi sieci (Edge Caching) za pośrednictwem Cloudflare Workers.
- Zweryfikuj plik robots.txt, blokując dostęp do dynamicznych parametrów filtrowania, które marnują budżet indeksowania.
Krok 5: Zgłoszenie witryny do ponownej weryfikacji i cierpliwość algorytmiczna
Po wdrożeniu zmian zaktualizuj mapę witryny XML i prześlij ją ponownie w Google Search Console. Pamiętaj, że w przypadku systemów oceny jakości działających na poziomie całej domeny (site-wide quality classifiers), odzyskiwanie pozycji nie następuje z dnia na dzień. Algorytmy Google muszą wielokrotnie odwiedzić zremediowane podstrony i potwierdzić trwałą zmianę parametrów jakościowych, co w praktyce zajmuje od 4 do 12 tygodni.
| Faza procedury | Działania operacyjne | Oczekiwany rezultat techniczny |
|---|---|---|
| Tydzień 1 - 2 | Audyt w GSC, kategoryzacja URL-i, wdrożenie noindex/410 dla farm spamowych. | Oczyszczenie indeksu, zatrzymanie spadków na stronach głównych. |
| Tydzień 3 - 6 | Manualna redakcja kluczowych podstron, dodanie unikalnych danych i Schema. | Strony niosą oryginalne dowody, powrót części fraz do top 50. |
| Tydzień 7 - 10 | Optymalizacja Core Web Vitals, Edge Caching, przebudowa profilu autorów. | Poprawa wskaźników zaufania E-E-A-T, stabilizacja indeksowania. |
| Tydzień 11 - 16 | Stopniowa reindeksacja, pierwsze wejścia do modułów AI Overviews. | Odbudowa ruchu organicznego na kluczowych frazach biznesowych. |
Świat wyszukiwarek internetowych nie znosi próżni. Zasady Google nie zamknęły drzwi przed sztuczną inteligencją, lecz podniosła poprzeczkę inżynieryjną. Wygrywają te organizacje, które traktują modele językowe jako narzędzie wspomagające pracę ekspertów, a nie jako darmowy substytut wiedzy, rzetelności i technicznego profesjonalizmu.