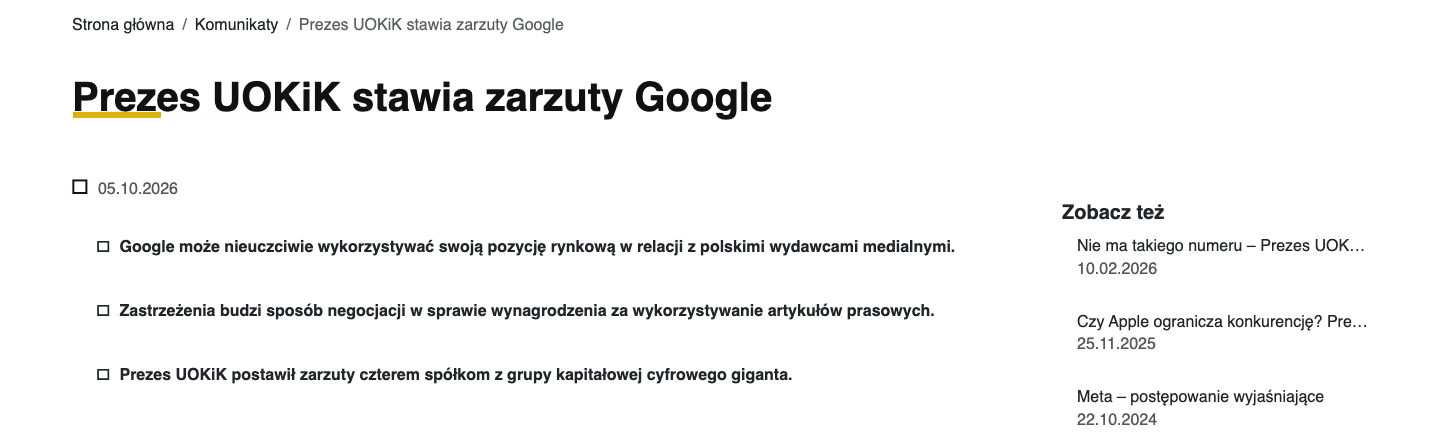
5 października 2026 Prezes UOKiK postawił zarzuty czterem spółkom z grupy Google w sprawie tego, jak koncern negocjował z wydawcami prasy wynagrodzenie za korzystanie z ich artykułów. Postępowanie obejmuje wyszukiwarkę Google, Google News i Google Discover. Dla wydawcy prowadzącego serwis na WordPressie dzisiaj nie zmienia się nic w ruchu ani w indeksowaniu. Zmienia się kontekst rozmów o wynagrodzeniu, a kilka ustawień, które wydawca kontroluje sam, warto przejrzeć właśnie teraz, zanim ktoś zacznie je zmieniać pod wpływem nagłówków.
Za co UOKiK postawił zarzuty Google
Zarzut dotyczy danych, których wydawcy nie dostali. Komunikat urzędu opisuje to tak:
“Z informacji posiadanych przez Urząd wynika, że Google proponując wynagrodzenie wydawcom nie przedstawił im wymaganych prawem danych pozwalających ocenić zaoferowane stawki.”
UOKiK, Prezes UOKiK stawia zarzuty Google, 5 października 2026
Urząd wymienia, czego konkretnie zabrakło: informacji o tym, w jaki sposób Google korzysta z publikacji prasowych i jakie osiąga z tego przychody, wyjaśnienia parametrów przyjętych w kalkulacji oraz dokumentów, które pozwoliłyby sprawdzić jej założenia. Skutek UOKiK nazywa asymetrią informacji: wydawca nie jest w stanie ocenić, czy oferta jest opłacalna, ani przedstawić własnej propozycji opartej na danych.
Zarzut prawny to podejrzenie nadużywania pozycji dominującej. Samo posiadanie takiej pozycji nie jest zakazane. Zakazane jest wykorzystywanie jej do narzucania warunków kontrahentom, którzy od platformy zależą. Komunikat podkreśla, że wydawcy są uzależnieni od Google jako kanału dotarcia do czytelników i nie mają pełnej wiedzy o wartości wykorzystywanych treści.
Zarzuty dotyczą czterech spółek:
| Spółka | Rola według komunikatu UOKiK |
|---|---|
| Alphabet Inc | spółka dominująca grupy Google |
| Google LLC | usługi reklamowe, wcześniej prowadziła wyszukiwarkę Google na terenie EOG |
| Google Ireland Limited | obecnie prowadzi i zarządza wyszukiwarką Google na terytorium EOG |
| Google Poland | sprzedaż miejsca na cele reklamowe w internecie |
Prezes UOKiK Tomasz Chróstny w wypowiedzi dołączonej do komunikatu ocenia skutek braku danych tak:
“Brak tych danych prowadził do sytuacji, w której negocjacje stawały się pozorne i zmierzały do narzucenia warunków przez rynkowego dominanta.”
Tomasz Chróstny, Prezes UOKiK, komunikat UOKiK, 5 października 2026
Na jakiej podstawie wydawcy mogą żądać wynagrodzenia od Google
Podstawą jest nowelizacja prawa autorskiego z 2024 roku, która wdrożyła dyrektywę (UE) 2019/790, nazywaną dyrektywą DSM. Prawo wydawców prasy wynika z jej art. 15. Według komunikatu UOKiK przepisy pozwalają serwisom internetowym korzystać z publikacji prasowych w zamian za wynagrodzenie, a platforma ma obowiązek przekazać wydawcy informacje niezbędne do ustalenia jego wysokości. Ten obowiązek informacyjny jest dokładnie tym, co według urzędu nie zostało spełnione.
Art. 15 dyrektywy ma kilka granic, które wydawca z serwisem na WordPressie powinien znać, bo od nich zależy, czy w ogóle jest stroną tej rozmowy:
- prawo nie obejmuje hiperłączy ani użycia pojedynczych słów lub bardzo krótkich fragmentów publikacji,
- nie obejmuje prywatnego lub niekomercyjnego użycia przez indywidualnych użytkowników,
- wygasa dwa lata po publikacji, liczone od 1 stycznia roku następującego po dniu publikacji,
- autorzy tekstów mają otrzymać odpowiedni udział w przychodach, które wydawca uzyska z tego tytułu.
Osobną kwestią jest definicja. Art. 2 pkt 4 dyrektywy uznaje za publikację prasową zbiór złożony głównie z utworów literackich o charakterze dziennikarskim, wydawany jako element periodyku lub regularnie aktualizowanej publikacji pod jednym tytułem, w celu informowania ogółu, z inicjatywy i pod redakcyjną odpowiedzialnością usługodawcy. Czasopisma naukowe są wyłączone wprost. W praktyce regularnie prowadzony serwis z lokalnymi wiadomościami i redakcją mieści się w tej definicji łatwiej niż blog firmowy, który publikuje artykuły sprzedażowe. Granice konkretnego przypadku ocenia prawnik, nie osoba konfigurująca WordPressa.
Jeśli rozmowy z platformą nie kończą się porozumieniem, przepisy przewidują arbitra. UOKiK zaznacza przy tym, że sam nim nie jest:
“Co istotne, Prezes UOKiK nie jest stroną w negocjacjach, czy też sporze pomiędzy Google a wydawcami prasy.”
UOKiK, Prezes UOKiK stawia zarzuty Google, 5 października 2026
Według tego samego komunikatu urząd nie ocenia, czy proponowana stawka jest odpowiednia. Gdy strony się nie porozumieją, wysokość wynagrodzenia może wyznaczyć Prezes Urzędu Komunikacji Elektronicznej. Postępowanie UOKiK dotyczy więc sposobu prowadzenia negocjacji, a nie kwoty.
Czy zarzuty UOKiK dotyczą AI Overviews
Nie dotyczą, i to rozstrzyga sam komunikat. Wstęp do niego opisuje zjawisko szerzej: czytelnicy zatrzymują się na fragmentach w wynikach wyszukiwania albo na syntezie artykułów przygotowanej przez sztuczną inteligencję i nie klikają w link. Ale zakres postępowania urząd wyznacza wąsko. Usługi Google oparte na sztucznej inteligencji bada Komisja Europejska, która w grudniu 2025 roku wszczęła formalne postępowanie w sprawie tego, czy Google wykorzystuje treści wydawców w takich usługach bez odpowiedniego wynagrodzenia i bez możliwości sprzeciwu. UOKiK pisze:
“Przedmiot postępowania KE jest przy tym różny od wszczętego przez Prezesa UOKiK postępowania antymonopolowego.”
UOKiK, Prezes UOKiK stawia zarzuty Google, 5 października 2026
Postępowanie polskiego urzędu obejmuje wykorzystanie treści wydawców w wynikach wyszukiwania Google oraz w serwisach Google News i Discover. Oba postępowania są niezależne, co według komunikatu uzgodniono z Komisją jeszcze przed wszczęciem postępowania właściwego.
Co zarzuty zmieniają dla wydawcy na WordPressie dziś
Na poziomie technicznym nic. Zarzuty to etap postępowania antymonopolowego, a nie decyzja. Kara do 10 proc. obrotu to górna granica przewidziana w ustawie, a komunikat zaznacza, że odpowiedzialność poszczególnych spółek będzie analizowana dopiero w trakcie postępowania. Ranking, indeksowanie, Discover i ruch z wyszukiwarki działają jutro tak samo jak wczoraj.
Zmienia się kontekst rozmów o pieniądzach. Komunikat mówi, że Google nie podpisał umów z większością polskich wydawców prasy i że zastrzeżenia budzi sposób, w jaki prowadził negocjacje z organizacjami skupiającymi wydawców. Wydawca, który należy do takiej organizacji, ma od teraz publiczne stanowisko urzędu, że żądanie danych o wykorzystaniu publikacji i o przychodach jest żądaniem wynikającym z ustawy. Wydawca, który nie należy do żadnej organizacji, powinien przynajmniej wiedzieć, kto w jego imieniu negocjuje albo czy ktokolwiek to robi.
Drugą zmianą jest ryzyko pochopnych decyzji. Po głośnej sprawie z udziałem Google łatwo o pomysł, żeby “odciąć Google” w robots.txt albo masowo dodać noindex. Wydawca traci wtedy ruch i nie zyskuje żadnego argumentu w negocjacjach. Wynagrodzenie z art. 15 przysługuje za korzystanie z publikacji w wyszukiwarce, News i Discover. Strona usunięta z wyszukiwarki przestaje być przedmiotem tej rozmowy.
Co wydawca kontroluje sam: Content-Signal, Google-Extended i Search Console
Wydawca ma dziś trzy osobne mechanizmy wpływu na to, co Google robi z jego treścią, i czwarty, który działa jak wyłącznik całości.
| Mechanizm | Gdzie się go ustawia | Na co wpływa | Na co nie wpływa |
|---|---|---|---|
| Kontrola Search generative AI | Search Console, Ustawienia | AI Overviews, AI Mode, funkcje generatywne w Discover | ranking, trenowanie modeli |
| Google-Extended | robots.txt | trenowanie i ugruntowanie modeli Gemini poza wyszukiwarką | obecność w Google Search, ranking |
| Content-Signal | robots.txt | deklaracja zgody na search, ai-input, ai-train | niczego nie blokuje technicznie |
| noindex | meta robots albo nagłówek HTTP | usuwa adres z Google Search w całości | nic nie zostaje w wyszukiwarce |
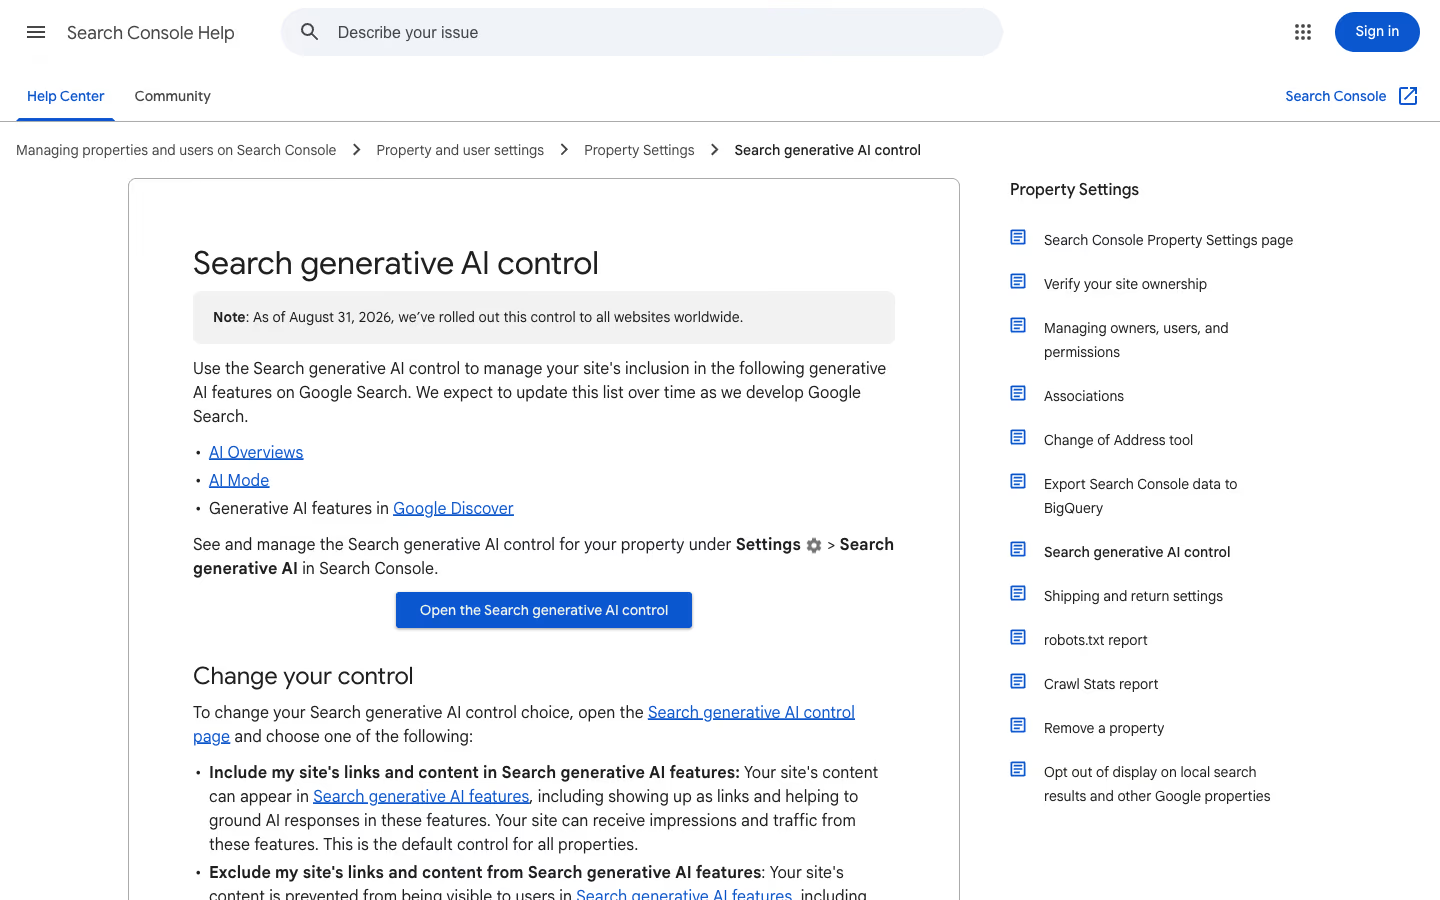
Kontrola Search generative AI w Search Console
To najnowsze z tych ustawień. Google opisuje je w pomocy Search Console i podaje datę udostępnienia:
“As of August 31, 2026, we’ve rolled out this control to all websites worldwide.”
Google, Search generative AI control, pomoc Search Console
Czyli: od 31 sierpnia 2026 roku kontrola jest dostępna dla wszystkich witryn na świecie. Obejmuje AI Overviews, AI Mode i funkcje generatywne w Google Discover. Domyślnie witryna jest włączona. Po wyłączeniu treść nie pojawia się w tych funkcjach ani jako link, ani jako źródło ugruntowania odpowiedzi, a Google zastrzega, że zmiana działa zwykle po kilku dniach, w części przypadków dłużej z powodu cache. Ustawienie jest dziedziczone: usługa z prefiksem URL, na przykład osobna sekcja serwisu, przejmuje je od usługi nadrzędnej, chyba że właściciel ustawi je dla niej oddzielnie.
Najważniejsze ograniczenie stoi w tej samej dokumentacji:
“This control doesn’t affect AI training; to limit training of the models used to generate responses in Search generative AI features, use Google-Extended.”
Google, Search generative AI control, pomoc Search Console
Po polsku: ta kontrola nie wpływa na trenowanie AI, a do ograniczenia trenowania modeli używanych w tych funkcjach Google odsyła do Google-Extended. Przed zmianą ustawienia sprawdź raport skuteczności dla funkcji generatywnej AI w Search Console. Bez liczb sprzed zmiany nie ocenisz, ile ruchu decyzja kosztowała.
Google-Extended w robots.txt
Google-Extended to token w robots.txt, a nie osobny robot. Według dokumentacji crawlerów Google nie ma własnego ciągu User-Agent w żądaniach HTTP, więc nie zobaczysz go w logach serwera. Indeksowanie wykonują zwykłe roboty Google, a token działa jako ustawienie. Dotyczy trenowania przyszłych modeli Gemini i ugruntowania odpowiedzi w Gemini Apps oraz w Vertex AI. Google zapewnia, że nie wpływa na obecność witryny w Google Search i nie jest sygnałem rankingowym.
Na WordPressie robots.txt bywa plikiem fizycznym w katalogu głównym albo plikiem generowanym przez WordPress przez funkcję do_robots(). Plik fizyczny ma pierwszeństwo, więc zanim cokolwiek dopiszesz w panelu wtyczki SEO, sprawdź, który z nich serwer naprawdę zwraca. Dla pliku generowanego wystarczy filtr:
add_filter( 'robots_txt', function ( $output, $public ) {
    if ( $public ) {
        $output .= "\nUser-agent: Google-Extended\nDisallow: /\n";
    }
    return $output;
}, 10, 2 );Content-Signal i art. 4 dyrektywy
Nasz własny robots.txt używa linii Content-Signal: search=yes, ai-input=yes, ai-train=no, a komentarz nad nią wskazuje, że ograniczenia wyrażone tymi sygnałami są wyraźnym zastrzeżeniem praw w rozumieniu art. 4 dyrektywy 2019/790. Art. 4 to wyjątek eksploracji tekstów i danych, który właściciel treści może wyłączyć w sposób czytelny maszynowo. To inny przepis niż art. 15, na którym opiera się spór wydawców z Google. Pierwszy dotyczy tego, czy wolno kopiować treść do analizy i trenowania. Drugi dotyczy tego, czy i ile platforma płaci za korzystanie z publikacji w swoich usługach. Linia w robots.txt nie jest ani umową, ani wnioskiem o wynagrodzenie.
Content-Signal ma też ograniczenie techniczne, które opisaliśmy na własnym przykładzie: linia postawiona tylko w grupie gwiazdki nie dociera do crawlerów, które mają w pliku własne sekcje. W naszym pliku sygnał stoi dziś osobno w grupach poszczególnych crawlerów, w tym w grupie Google-Extended. Nie mierzyliśmy, którzy operatorzy go respektują, i nie twierdzimy tego.
noindex jako jedyne pełne wyjście z wyszukiwarki
Dokumentacja Google mówi wprost, że żeby całkowicie zablokować pojawianie się treści w Google Search, trzeba użyć noindex. W WordPressie od wersji 5.7 meta tag robots ustawia się filtrem wp_robots, a większość wtyczek SEO robi to per wpis lub per typ treści. noindex usuwa stronę z wyników, z News i z Discover, czyli z tych usług, za które wydawca może żądać wynagrodzenia, więc w negocjacjach nic nie daje. Ma sens dla archiwów tagów, stron wyszukiwania i treści technicznych, nie dla artykułów redakcyjnych.
Jak przejrzeć ustawienia serwisu po zarzutach UOKiK
Przegląd serwisu informacyjnego na WordPressie w pięciu krokach:
- Pobierz
robots.txtz produkcji poleceniemcurli sprawdź, czy serwer zwraca plik fizyczny, czy generowany. Wtyczki cache i CDN potrafią serwować starą wersję. - Wypisz grupy User-agent i sprawdź, czy deklaracje, na których ci zależy, stoją w każdej grupie, która ma ich dotyczyć.
- Zapisz stan raportu skuteczności funkcji generatywnej AI w Search Console. Bez punktu odniesienia nie ocenisz skutku zmiany.
- Zdecyduj o kontroli Search generative AI osobno dla usługi domenowej i dla sekcji założonych jako osobne usługi.
- Przejrzyj, gdzie stoi noindex. Szablon, który przez pomyłkę dodaje noindex do kategorii z newsami, kosztuje więcej niż jakakolwiek decyzja w sprawie AI.
Jeśli publikujesz również pod kątem odpowiedzi generatywnych, kontekst tych decyzji opisaliśmy w przewodniku po GEO. Wyłączenie witryny z funkcji generatywnych i jednoczesna optymalizacja pod cytowania w tych samych funkcjach to dwa sprzeczne cele, więc wybierz jeden świadomie.
Co dalej z postępowaniem UOKiK wobec Google
Postępowanie toczy się dalej i komunikat nie podaje terminu decyzji. Do obserwowania są trzy wątki. Pierwszy to samo postępowanie UOKiK i ewentualna decyzja z karą. Drugi to rozmowy wydawców z Google i możliwa rola Prezesa UKE, jeśli porozumienia nie będzie. Trzeci to postępowanie Komisji Europejskiej w sprawie usług AI, które może dotknąć AI Overviews bezpośrednio, czego sprawa polska nie robi.
Komunikat umieszcza sprawę w szerszym ciągu: UOKiK kończy postępowanie antymonopolowe przeciwko Apple, a wobec Meta prowadzi postępowanie wyjaśniające dotyczące zmiany sposobu prezentacji odnośników do publikacji prasowych. Ustawienia techniczne serwisu wydawca zmienia sam, w ciągu godziny, i może zmierzyć ich skutek w Search Console. Prawo do wynagrodzenia wynika z ustawy i rozstrzyga się w negocjacjach, przed Prezesem UKE albo pośrednio w postępowaniu UOKiK.