Um salão de beleza, uma clínica ou uma empresa de remodelações recebe um pedido pelo formulário do site numa sexta-feira às 21h00. O dono lê-o na segunda-feira, e desde sábado o cliente já está a falar com outra pessoa. Daí a ideia de entregar os pedidos a uma automação: resposta num minuto, encaminhamento para a pessoa certa, nada se perde na caixa de correio.
A maioria dos guias começa por um modelo de linguagem que responde ao cliente. Eu começo pelo outro lado, porque no meu próprio formulário em wppoland.com são as camadas antes e depois do modelo que fazem a maior parte do trabalho. Seguem-se cinco camadas pela ordem em que o pedido passa por elas, com o que funciona comigo e onde a IA é realmente útil.
Como filtrar o spam do formulário WordPress antes de a IA o ver
Uma automação que responde ao spam faz dois estragos ao mesmo tempo: paga cada chamada ao modelo e envia respostas para endereços que só estão à espera disso. Por isso, o filtro tem de estar antes do modelo. O meu tem três camadas.
A primeira é um campo armadilha invisível. Uma pessoa não o vê, mas um bot simples preenche todos os campos. Campo preenchido significa bot.
A segunda é o Cloudflare Turnstile verificado no servidor. O token do navegador chega à minha função, e só ela pergunta à Cloudflare se é válido. Nunca a partir do navegador: o segredo ficaria público e o resultado seria fácil de falsificar. Rejeito pedidos sem token ou com token inválido. Quando a própria verificação da Cloudflare não responde, o pedido passa, porque a falha de um serviço alheio não pode engolir clientes verdadeiros.
A terceira são assinaturas de conteúdo que não existem em nenhum pedido verdadeiro: um link HTML escrito à mão na descrição do projeto, etiquetas BBCode, um link do Telegram no campo do site. Acrescentei ainda à lista o nome de uma ferramenta para enviar spam a formulários, porque a 29 de julho de 2026 uma série de pedidos de casinos chegou de um endereço que continha o nome dessa ferramenta.
O Turnstile sozinho nem sempre chega. O autor do blogue elszczepano descreveu em agosto de 2026 que a Cloudflare marcava como bot provável cerca de metade do tráfego do seu site WordPress e, mesmo assim, centenas de comentários de spam continuavam a entrar (When SIMPLER means BETTER?). O que resolveu foi um campo armadilha próprio, ligado no functions.php: o envio só passa quando esse campo existe e está vazio. Segundo o autor, desde novembro de 2025 nenhum comentário foi parar ao spam. A conclusão dele também serve para formulários: os bots de spam são genéricos, por isso até um mecanismo simples que não esperam elimina a maioria deles.
Ao spam respondo tal como a um pedido verdadeiro: mensagem de receção e número. Um remetente que descobre que foi rejeitado muda de endereço e continua a tentar.
Que campos do formulário poupam trabalho ao modelo de IA
Parte dos pedidos pode ser encaminhada sem modelo nenhum. O meu formulário tem três campos de escolha fechada: tipo de projeto (site novo, reparação, manutenção, migração, outro), prazo e escalão de orçamento. Cada um deles pode ser encaminhado com uma simples condição no código, por exemplo a reparação de uma loja online para a fila urgente e uma migração para a pessoa que trata de migrações.
Um pormenor custou-me algum tempo. O formulário envia o escalão de orçamento como código, por exemplo band-3, e os escalões não estão na mesma moeda em todas as línguas (a versão polaca em zlótis, as restantes em euros). Um email só com o código era ilegível, por isso a função acrescenta ao código uma etiqueta com o valor na língua do formulário. A mesma lista de etiquetas existe em dois sítios, e por isso um teste verifica em cada compilação se ambas são idênticas.
Só a descrição do projeto em texto livre exige mais do que uma condição.
Como encaminhar um pedido do formulário com um modelo de decisão
Para encaminhar não é preciso um modelo que escreva textos longos. Basta um modelo de decisão: recebe um texto e uma lista de opções e devolve uma delas. Por exemplo: “a que equipa passar este pedido: loja online, site empresarial, integração, outro” ou “este pedido é urgente: sim, não”.
Há pelo menos dois modelos deste tipo no mercado. O Jev, que uso no controlo de qualidade dos textos neste repositório, e o Clef, que a Cloudflare publicou no início de outubro de 2026 no Workers AI e no Hugging Face, com licença Apache 2.0 e compatível com a API do Jev. Segundo as medições da própria Cloudflare, a latência mediana é de 209,3 ms para o Clef, 38,8 ms para o Clef-flash, mais pequeno, e 524,1 ms para o Jev (Cloudflare). São valores do fabricante, por isso comparações independentes podem dar resultados diferentes.
Para uma empresa polaca há uma terceira opção, o basal de Remek Kinas: funciona em polaco e inglês, tem pesos abertos sob Apache 2.0 e corre localmente, incluindo em Macs com Apple Silicon ou através do Ollama, pelo que o conteúdo dos pedidos não sai da empresa. Responde aos mesmos tipos de pergunta que o Jev, através de um endpoint com o mesmo nome. Desde a versão 2.2 inclui o basal-calibrate, que ajusta a confiança do modelo a algumas centenas de exemplos rotulados do seu próprio processo, e as perguntas com erro máximo definido marcam os casos incertos como adiados, ou seja, para decisão de uma pessoa. O autor mede a qualidade com o seu próprio benchmark Werdykt, por isso teste o modelo com os seus pedidos antes de confiar nele. O português não é suportado.
O custo com os meus números: avaliar 300 parágrafos com o Jev custou um cêntimo, e passar por ele todo o corpus, cerca de 134 000 parágrafos, custaria 3,32 USD e demoraria 100 minutos. Com algumas dezenas de pedidos por mês, o custo de um modelo de decisão é insignificante. Mais caro é o tempo para o configurar e para verificar se o encaminhamento está certo.
Quando deve o modelo de decisão passar o pedido a uma pessoa
As camadas acima formam uma hierarquia que Parth Parikh compara à memória de um computador no ensaio To Make, or to Buy: The Economics of Decision Models, de outubro de 2026: as regras tratam do que conseguem, um modelo de decisão fica com a parte seguinte, um modelo de linguagem com os casos mais difíceis e uma pessoa com o resto. Cada nível responde apenas onde tem certeza e passa o resto ao nível seguinte. No meu formulário, as regras são os campos de escolha fixa, o modelo de decisão encaminha a descrição livre do projeto, o modelo de linguagem escreve o rascunho da resposta e uma pessoa aprova-o.
Falta saber que certeza o modelo de decisão precisa de ter. Parikh recorre à regra de Chow (que ele data de 1970): um nível responde quando a probabilidade de erro, ou seja, 1 menos a probabilidade mais alta, é menor do que o custo de passar adiante. Esse custo, medido em unidades de uma resposta errada, é a taxa de erro do nível seguinte mais o seu preço dividido pelo custo de um erro.
Um exemplo hipotético em unidades de custo abstratas. Um pedido entregue à pessoa errada custa 50 unidades (atraso, um dia perdido). Uma pessoa que o lê e encaminha custa 5 unidades e engana-se em 2% dos casos. O limiar fica em 0,02 + 5/50 = 0,12, por isso o modelo só encaminha sozinho quando a sua melhor opção tem probabilidade acima de 0,88. A verificação em 100 pedidos em que o modelo tem 70% de certeza: se encaminhar todos, 30 vão parar ao sítio errado, ou seja, 30 × 50 = 1500 unidades. Se for uma pessoa a encaminhar todos: 100 × 5 + 2 × 50 = 600 unidades. A pessoa sai mais barata. Com 95% de certeza, o modelo sai mais barato: 5 × 50 = 250 unidades contra as mesmas 600.
Se um pedido mal encaminhado custar 500 unidades, por exemplo uma reclamação com prazo, o limiar desce para 0,02 + 5/500 = 0,03 e o modelo precisa de mais de 97% de certeza. Nesse caso, o preço do trabalho da pessoa quase não muda o resultado, e decide a frequência com que a própria pessoa se engana. Se o seu modelo permitir definir um erro máximo, como o basal, este cálculo dá-lhe o valor a introduzir em vez de um palpite.
Parikh acrescenta duas ressalvas. Um modelo pode errar com muita certeza, por isso envie mesmo assim uma pequena amostra aleatória, por exemplo 1% das decisões seguras, ao nível seguinte; assim fica também a conhecer a taxa de erro real. E nem todos os erros custam o mesmo: um assunto jurídico entregue à equipa errada custa mais do que uma troca entre duas filas técnicas, por isso o custo do erro deve depender da categoria.
Quais são as limitações e os erros dos classificadores como o Jev na prática
Atualização de . Ensaios independentes e medições de engenharia aplicadas a modelos de classificação (detalhados na análise JEV sem hype: classificadores de IA contra LLMs clássicos) colocam em perspetiva as promessas de ausência de alucinações ou de funcionamento enquanto Sistema 1 intuitivo. Na prática, a arquitetura de modelos como o Jev assenta na inferência zero-shot NLI (Natural Language Inference) sobre modelos de codificação (estruturas semelhantes ao BERT). Em vez de gerar texto palavra a palavra, o modelo calcula a probabilidade das etiquetas candidatas numa única passagem. Isso garante uma rapidez 20 a 200 vezes superior à dos modelos de conversação, mas acarreta quatro limites rigorosos:
- Erro forçado quando nenhuma opção se aplica: O classificador não inventa termos fora da lista, mas quando o pedido não encaixa em nenhuma das categorias definidas, o Jev raramente escolhe a ausência de correspondência. Em testes independentes, a identificação correta de falta de opção ocorreu em apenas 7% das tentativas; nos restantes 93%, o modelo atribuiu o contacto a uma etiqueta incorreta.
- Sensibilidade à ordem das opções: A simples inversão da ordem das categorias na lista reduz a precisão de 91% para 76,5%. Para estabilizar o encaminhamento em produção, é necessário permutar a ordem das opções e calcular a média das probabilidades (ensemble averaging), ou fixar uma ordenação alfabética com margem mínima de confiança.
- Incapacidade de raciocínio numérico e orçamental: Quando o cliente indica um orçamento no texto livre (por exemplo, 15 000 €), o classificador NLI erra em mais de 90% das tentativas e não consegue associar o valor ao intervalo correspondente. Valores numéricos, prazos e dados estruturados devem ser sempre extraídos com expressões regulares determinísticas ou validações de esquema (como o Zod) antes da chamada ao modelo.
- Vulnerabilidade a injeções de instruções (prompt injection): Uma vez que o texto do formulário entra diretamente no contexto de atenção do codificador, frases maliciosas inseridas pelo utilizador podem distorcer os pesos internos e manipular as prioridades de atendimento.
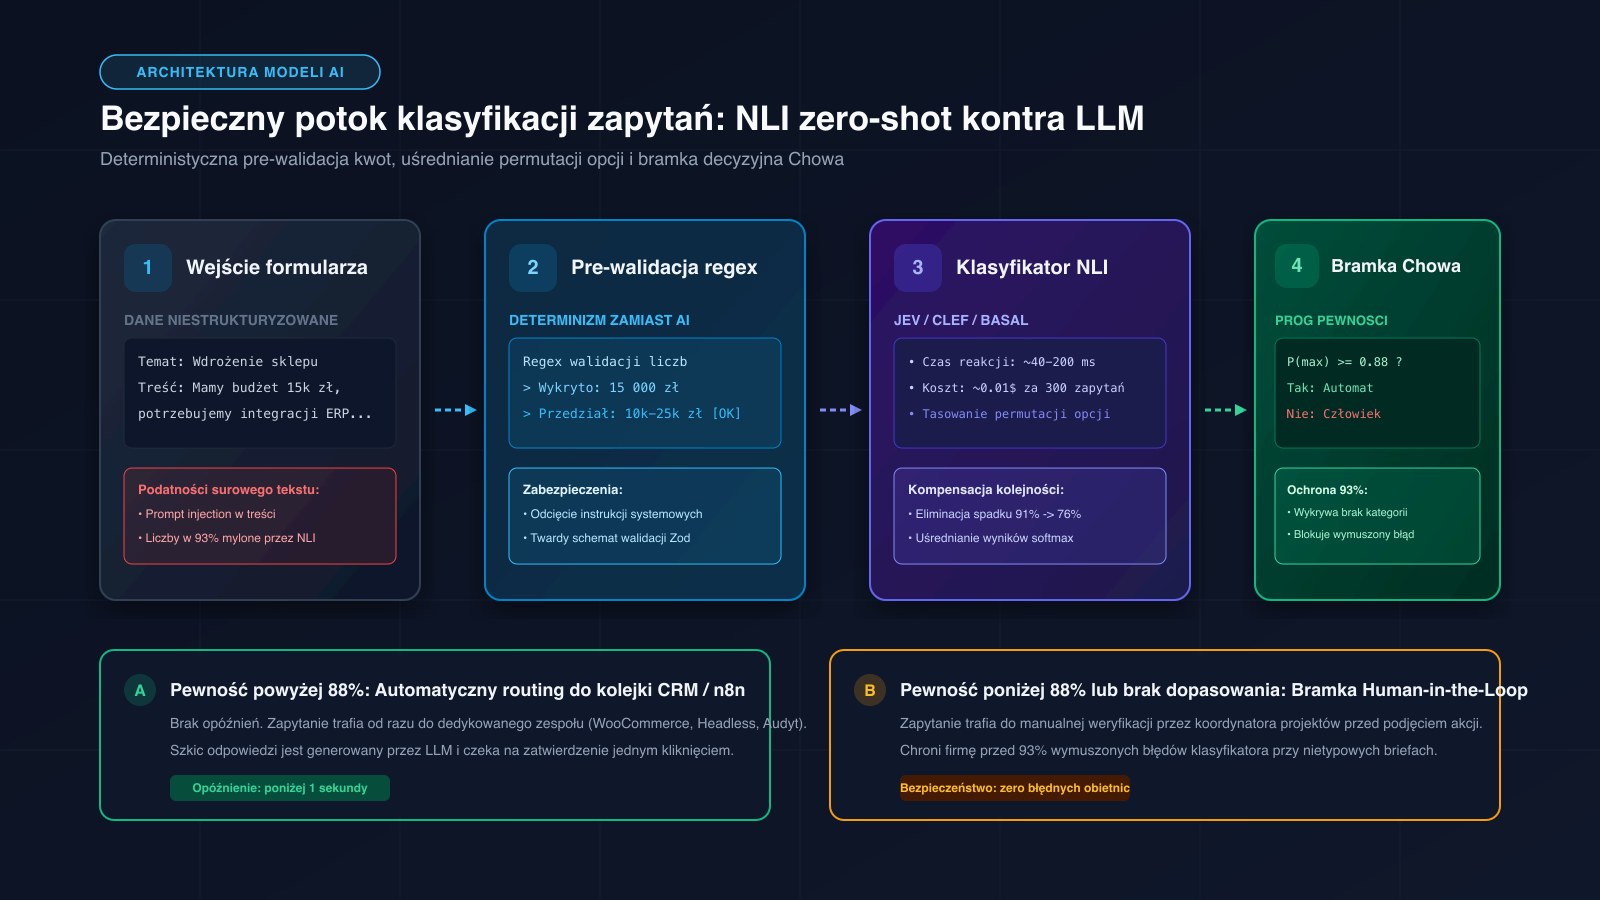 Esquema de fluxo de decisão seguro: extração determinística de valores com regex, mitigação da ordem das opções e validação do limiar de Chow antes da intervenção humana.
A IA pode responder sozinha aos clientes do formulário
Tecnicamente, sim. Na prática, a primeira resposta a um pedido indica normalmente um prazo, um âmbito ou um preço, ou seja, uma promessa em nome da empresa. Um modelo que escreve ao cliente “fazemos isso numa semana” num projeto de dois meses custa mais do que poupa.
A Anthropic descreve o mesmo princípio no seu guia sobre agentes para comércio: nenhuma chamada de ferramenta feita pelo modelo movimenta dinheiro ou altera o negócio, e o pior que o modelo pode fazer é propor uma alteração que uma pessoa ou uma regra aprova (A guide to the anatomy of effective commerce agents). Encomendas, pagamentos, reembolsos e alterações de preço passam aí pela mesma aprovação que a empresa já usa para essas alterações sem IA. Uma resposta com orçamento para o cliente é o mesmo tipo de alteração.
Uma configuração mais segura: o modelo prepara o rascunho e quem envia é uma pessoa. O rascunho recebe o contexto dos campos do formulário e a descrição do serviço a que o pedido diz respeito. A aprovação demora um minuto, e o cliente recebe resposta no próprio dia em vez de na segunda-feira. Sem intervenção humana só deve sair a confirmação de receção com o número de referência. No meu caso, o cliente vê esse número, num formato com a data e um sufixo aleatório, logo após enviar o formulário.
Como ligar um formulário WordPress ao n8n e ao Claude
Há dois caminhos. O primeiro é o n8n: o formulário envia os dados para um nó Webhook, que inicia o fluxo. O nó tem um endereço de teste e um de produção separados, por isso é possível testar o fluxo sem mexer no formulário em funcionamento (documentação do n8n). Mais à frente no mesmo fluxo, o n8n tem um nó Anthropic pronto para o rascunho da resposta no Claude e nós para email, Slack ou um CRM.
O segundo caminho é código próprio. O meu formulário é tratado por uma função no Cloudflare Pages: validação dos campos, filtro de spam, Turnstile, envio e telemetria num só ficheiro. Menos peças para manter e controlo total sobre o que vai parar aos registos, mas cada alteração exige um programador.
A escolha depende de quem vai alterar as regras. Se o dono quiser acrescentar sozinho uma nova categoria de pedidos, ganha o n8n. Se as regras mudarem uma vez por trimestre, o código próprio é mais simples de manter.
O que fazer quando o envio do email do formulário falha
Uma automação que aceitou um pedido e não o entregou é pior do que não ter automação, porque o cliente pensa que a mensagem chegou. No meu caso, o pedido segue primeiro pelo Resend e, quando este falha, pelo Web3Forms. Com o segundo fornecedor surgiu um pormenor fácil de deixar escapar: o Web3Forms responde com o código 200 mesmo quando rejeita a mensagem, e a informação da rejeição está no corpo da resposta. Verificar só o código HTTP daria esse envio como bem-sucedido.
A segunda lição tem a ver com os erros. Cada caminho de falha devolve o seu próprio código, não apenas uma mensagem. Dois deles têm o mesmo estado HTTP 422 e significados completamente diferentes: um formulário mal preenchido e um token antispam expirado. Enquanto o navegador juntava todos os erros sob o mesmo nome, o erro do token expirado era invisível na telemetria.
Quanto custa o tratamento automático de pedidos e quando compensa
Com pouco volume, o custo dos modelos é insignificante; o que conta é o tempo de implementação e manutenção. Compensa quando os pedidos chegam fora do horário de trabalho, quando seguem para várias pessoas ou quando parte deles se perde hoje na caixa de correio. Com poucos pedidos por mês, será mais rápido configurar uma notificação no telemóvel.
Pode calcular os seus próprios números na calculadora de rentabilidade da automação. Implemento este tipo de fluxo em sites WordPress no âmbito da automação de processos de negócio e da integração de IA com WordPress: primeiro o filtro e os campos, depois o encaminhamento, por fim o rascunho da resposta, cada passo testado com pedidos reais antes de avançar para o seguinte.