Não, o Cloudflare não bloqueia o Googlebot por predefinição. Desde 15 de setembro de 2026, porém, uma opção nas definições de bots de IA faz algo que muita gente não espera: “Block” bloqueia o Googlebot à entrada, juntamente com a pesquisa, e não apenas com o treino de IA. Se o seu WordPress está atrás do Cloudflare e alguém “desligou a IA” nas últimas semanas, vale a pena verificar hoje.
A 7 de outubro de 2026, no resumo diário do Search Engine Roundtable, apareceu uma frase retirada de uma publicação no X: “O Cloudflare passou a bloquear o Google por predefinição a 15/9” (Search Engine Roundtable, 7 de outubro de 2026, tradução própria). A publicação no X não abria sem iniciar sessão, por isso o que se segue baseia-se exclusivamente em fontes do Cloudflare. Todas as citações foram verificadas a 8 de outubro de 2026.
O que o Cloudflare mudou a 15 de setembro de 2026
Até agora havia um único interruptor, “Block AI bots”. Passam a existir três categorias, cada uma com a sua própria definição. O Cloudflare define-as assim:
- Search: “rastreio para construir um índice de pesquisa.”
- Training: “rastreio para treinar ou afinar um modelo.”
- Agent: “agentes dirigidos pelo utilizador que visitam uma página em nome de uma pessoa, como bots de obtenção de chats e agentes de utilização do navegador.”
Fonte das definições: Cloudflare Blog, 15 de setembro de 2026, tradução própria.
Há quatro opções à escolha: Allow, Disallow AI Training, Block on pages with ads e Block. Disallow AI Training só existe na categoria Training. O Cloudflare indica que as novas definições estão disponíveis “a todos os clientes, em todos os planos” (tradução própria), ou seja, também no plano gratuito.
Porque é que a opção Block bloqueia o Googlebot
Porque o Googlebot é um rastreador misto. O Cloudflare chama assim a um bot que, com um único user agent, serve tanto a pesquisa como o treino:
“Um rastreador de uso misto é um único rastreador que faz tanto Search como Training.”
Cloudflare Blog, 15 de setembro de 2026, tradução própria
O Cloudflare nomeia três rastreadores deste tipo: o Applebot, o Bingbot e o Googlebot. Como não é possível bloquear “a parte do Googlebot que treina”, o bloqueio atinge o bot inteiro. O Cloudflare escreve-o sem rodeios:
“Vai impedir o Applebot, o Bingbot e o Googlebot de chegarem ao seu site […] incluindo a pesquisa.”
Cloudflare Blog, 15 de setembro de 2026, tradução própria
O mesmo vale para a opção Block on pages with ads, mas num âmbito mais restrito: segundo o Cloudflare, os rastreadores, incluindo os mistos, são então bloqueados nas páginas onde foi detetado um anúncio. Para um blogue em WordPress com AdSense, isto pode significar que o Google deixa de ver precisamente os artigos que geram receita.
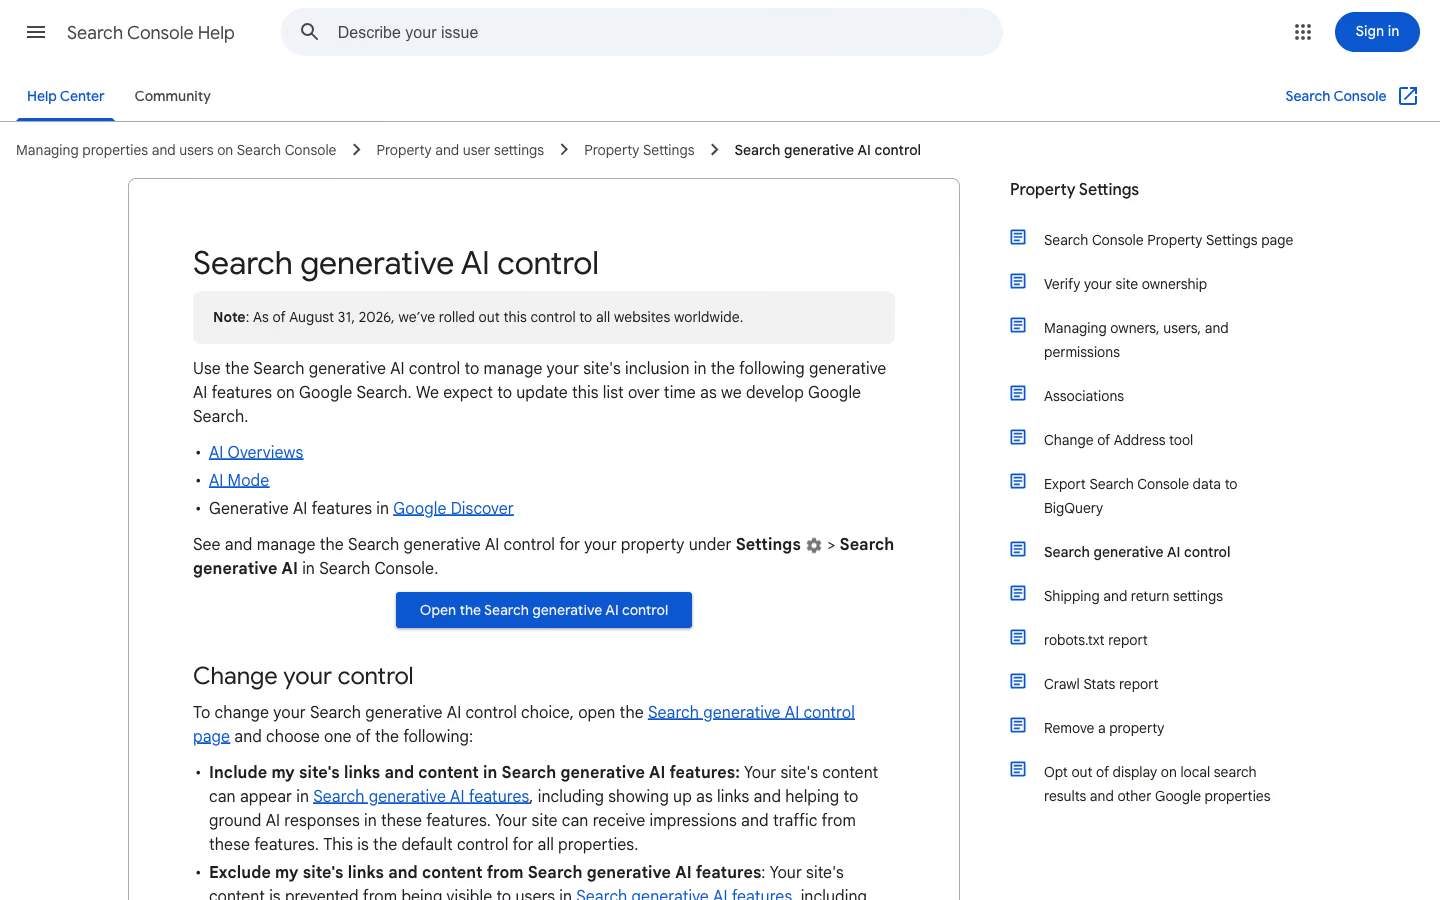
A opção segura para a pesquisa é Disallow AI Training. Apenas publica uma preferência no robots.txt, e o Cloudflare sublinha que o Googlebot “pode continuar a rastrear o seu site para a pesquisa” (tradução própria). A recusa do treino de modelos do Google é tratada por um token separado, o Google-Extended, que descrevi no artigo sobre os três interruptores de IA do Google.
O que aconteceu ao antigo interruptor Block AI bots
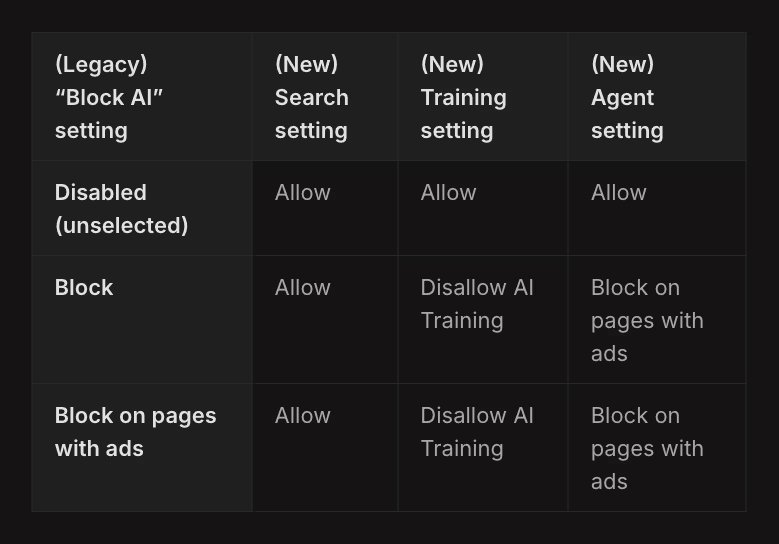
O Cloudflare está a descontinuá-lo e a migrar as zonas existentes para as novas definições. A tabela de migração do artigo no blogue é esta:
| Antigo “Block AI” | Search | Training | Agent |
|---|---|---|---|
| Desativado | Allow | Allow | Allow |
| Block | Allow | Disallow AI Training | Block on pages with ads |
| Block on pages with ads | Allow | Disallow AI Training | Block on pages with ads |
Segundo esta tabela, ninguém que tivesse o antigo interruptor ficou automaticamente com o Googlebot bloqueado. Search passa sempre para Allow e Training para Disallow AI Training, ou seja, a variante baseada no robots.txt.
Os domínios novos, adicionados a partir de 15 de setembro, recebem ao adicionar o domínio um de dois conjuntos. Site sem anúncios: tudo em Allow. Site com anúncios: Search Allow, Training Disallow AI Training, Agent Block on pages with ads. Nos dois conjuntos está ativo o Preference Sync, que segundo o Cloudflare “publica no robots.txt a preferência aplicável de não treino” (tradução própria) e substitui o anterior Managed Robots.txt.
Bloquear o treino de IA no Cloudflare bloqueia o Googlebot
Dizem. A página da documentação sobre o bloqueio de bots de IA contém uma frase que não bate com a tabela:
“Os rastreadores de finalidade mista que combinam Search e Training também serão bloqueados por todas as configurações que bloqueiam o treino de IA”
Cloudflare Docs, Block AI bots, tradução própria
Lida à letra, qualquer configuração que bloqueie o treino, incluindo o antigo interruptor, bloqueia também o Googlebot. A tabela de migração diz o contrário. Qual das versões descreve o que o servidor do Cloudflare faz realmente com o seu tráfego, só a sua própria zona e os seus próprios registos o podem decidir, não nenhum destes dois textos.
A documentação indica ainda que o antigo interruptor está “a descontinuar a 15 de setembro de 2026” (tradução própria) e que, para domínios novos, “Search continuará permitido” (tradução própria). Nem o artigo nem a documentação mencionam o Cloudflare Pages.
Porque é que o Cloudflare pode bloquear o GPTBot sem afetar a pesquisa, mas não o Googlebot
O mesmo artigo explica porque é que a Google, a Apple e a Microsoft recebem um tratamento diferente das outras empresas de IA. O Cloudflare criou a designação “Accountable” para operadores de crawlers. Para a obter, um operador tem de cumprir, ou comprometer-se a cumprir, quatro requisitos: uma forma de recusar o treino de IA (através do robots.txt ou de uma norma semelhante), uma forma de recusar os resumos de IA, visibilidade ao nível do URL sobre que páginas foram disponibilizadas para treino e a garantia de que recusar o treino não afeta os resultados de pesquisa tradicionais (Cloudflare Blog, 15 de setembro de 2026).
O Cloudflare classifica o Applebot, o Googlebot e o Bingbot como crawlers mistos com a designação Accountable. Os crawlers de treino da Amazon, da Anthropic, da Meta e da OpenAI têm outra classificação: estas empresas usam crawlers separados para pesquisa e para treino, por isso o Cloudflare consegue bloquear o bot de treino e deixar passar o bot de pesquisa. É exatamente por isso que o Disallow AI Training funciona como funciona. Os crawlers que só treinam são bloqueados, e os crawlers mistos com a designação Accountable continuam autorizados para a pesquisa e recebem a preferência contra o treino através do robots.txt.
A preferência só tem efeito se o operador a ler. A Google respeita um Disallow para o token Google-Extended e a Apple respeita-o para o Applebot-Extended. A Microsoft é diferente: segundo o mesmo artigo, o Bing ainda está a desenvolver o suporte para uma preferência contra o treino no robots.txt ao nível do domínio, com previsão para o início de 2027, e até lá o Disallow AI Training não transmite essa preferência ao Bing de forma automática. Entretanto, o Cloudflare aponta para a meta tag NOARCHIVE e para a ferramenta Block URLs do Bing.
Como verificar se o Googlebot acede ao seu WordPress
Três passos, cerca de três minutos, se tiver acesso ao Search Console e à conta do Cloudflare.
- Inspeção de URL no Search Console. Cole o endereço da página inicial e execute o teste em direto. Procure uma obtenção da página bem-sucedida e uma data de último rastreio posterior a 15 de setembro. Repita para um artigo com anúncio, se os mostrar, porque é aí que atua a variante Block on pages with ads.
- Estatísticas de rastreio. Nas definições do Search Console, abra as estatísticas de rastreio e a divisão por resposta. Um aumento súbito de respostas 403 a partir de meados de setembro é sinal de que algo na periferia da rede está a bloquear o Googlebot.
- Definições da zona no Cloudflare. O Cloudflare escreve que os novos controlos “podem ser configurados nas Security Settings do domínio (zona)” (tradução própria). Verifique o que está definido em Search, Training e Agent. Se vir Block em Training ou em Search e quiser continuar no Google, mude para Disallow AI Training ou Allow.
Aproveite para abrir o robots.txt. Se o Preference Sync estiver ativo, o Cloudflare acrescenta lá a sua preferência. No WordPress, o robots.txt é muitas vezes gerado também por um plugin de SEO, por isso verifique o ficheiro final no endereço /robots.txt e não as definições do plugin. A nossa própria linha Content-Signal mostra como o robots.txt facilmente se desalinha daquilo que assumimos.
O Google-Extended no robots.txt retira o site da pesquisa Google
Não. A documentação da Google sobre os crawlers comuns diz que o Google-Extended não tem uma string de user agent própria nos pedidos HTTP. O rastreio é feito pelos user agents da Google que já existem, e o token funciona apenas como controlo no robots.txt. A Google afirma que não afeta a inclusão de um site na pesquisa Google nem é usado como sinal de classificação. Controla apenas se o conteúdo rastreado pode ser usado para treinar futuros modelos Gemini e para grounding nas apps Gemini e no Vertex AI (Google Search Central, crawlers comuns da Google).
A mesma página explica um pormenor que conta nos testes. O teste em direto do Search Console e o Teste de resultados avançados obtêm a página como Google-InspectionTool, um crawler das ferramentas de teste que não tem efeito na pesquisa Google. Um teste em direto bem-sucedido diz-lhe, portanto, que a zona deixa passar um crawler da Google neste momento. A forma como o próprio Googlebot foi tratado nas últimas semanas vê-se nas estatísticas de rastreio, e é por isso que a verificação acima usa as duas coisas.
O que acontece às páginas indexadas quando o Googlebot recebe um 403
Um bloqueio no Cloudflare responde ao Googlebot com uma página de erro em vez do seu conteúdo, e é por isso que a verificação acima procura respostas 403. A Google descreve como os seus crawlers reagem. Todos os códigos 4xx exceto o 429 são tratados da mesma forma, não afetam a velocidade de rastreio e, na pesquisa Google, o processo de indexação remove o URL do índice se este já estava indexado (Google Search Central, códigos de estado HTTP e erros de rede).
Um bloqueio não se limita a pausar o rastreio novo. Páginas que já têm posições podem sair do índice enquanto ele durar. A mesma página desaconselha o uso de 401 e 403 para limitar a velocidade de rastreio. Se o objetivo real é aliviar um servidor WordPress, os códigos que a Google interpreta como sinal para abrandar são o 429 e os 5xx: os crawlers da Google passam temporariamente a rastrear mais devagar, em vez de removerem URLs.
Como verificar se um pedido nos registos vem mesmo do Googlebot
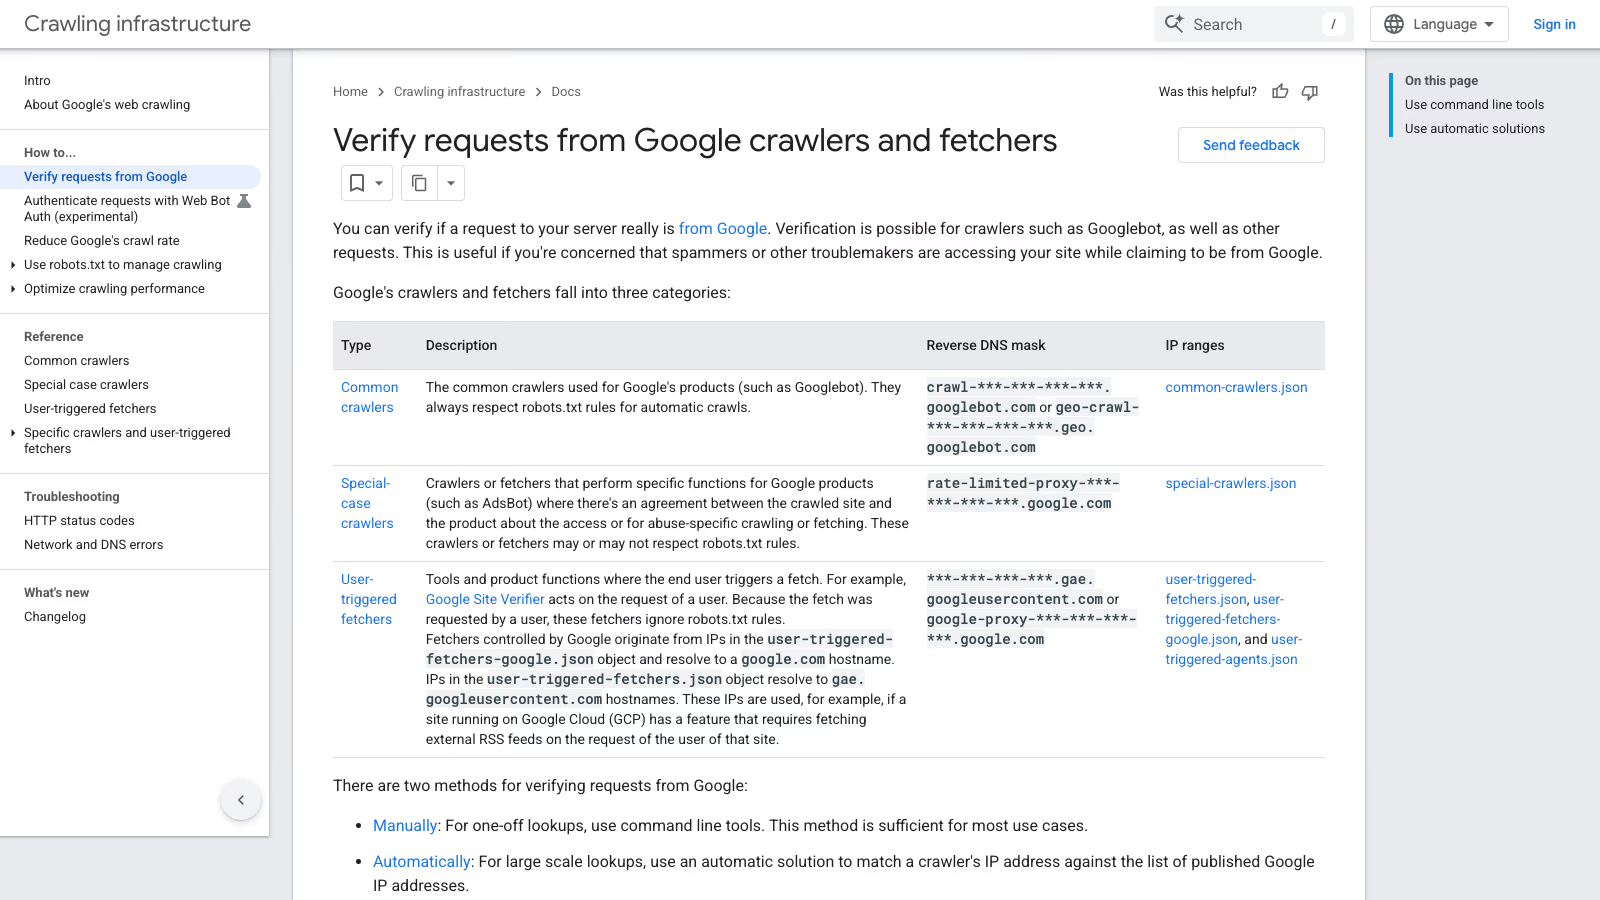
Qualquer pessoa pode enviar um pedido com “Googlebot” no user agent, por isso uma linha de registo sozinha não prova nada. O método da Google é uma verificação de DNS nos dois sentidos: faça uma pesquisa de DNS inversa ao endereço IP do registo com o comando host, confirme que o nome do anfitrião termina em googlebot.com, google.com ou googleusercontent.com, e depois faça uma pesquisa direta a esse nome e confirme que devolve o mesmo IP. A Google publica também os intervalos de IP dos seus crawlers em ficheiros JSON, separados em crawlers comuns, crawlers de casos especiais, fetchers acionados pelo utilizador e agentes acionados pelo utilizador (Google Search Central, verificar o Googlebot).
O nome do anfitrião também indica que tipo de crawler tem à frente. O Googlebot e os outros crawlers comuns resolvem para crawl-***-***-***-***.googlebot.com (ou uma variante em geo.googlebot.com) e respeitam sempre o robots.txt nos rastreios automáticos. Os fetchers acionados pelo utilizador resolvem em gae.googleusercontent.com ou google-proxy-***.google.com e ignoram o robots.txt, porque foi uma pessoa a pedir a obtenção.
O Cloudflare faz uma verificação semelhante do seu lado. Os seus bots verificados são bots cuja identidade o Cloudflare confirmou através de uma assinatura criptográfica Web Bot Auth, de uma lista de IP publicada com um user agent estável ou de DNS inverso, e segundo a documentação têm sido excluídos das configurações de bots predefinidas em todos os planos (Cloudflare Docs, Verified bots). Numa regra WAF, o campo cf.client.bot indica se o pedido veio de um bot ou crawler conhecido e legítimo (Cloudflare Docs, cf.client.bot). Uma armadilha no plano gratuito: o Bot Fight Mode corre num processo separado, e o Cloudflare escreve que não pode ser contornado nem ignorado com regras WAF ou Page Rules (Cloudflare Docs, Bot Fight Mode). Uma regra de exceção escrita “para proteger o Googlebot” não muda o que o Bot Fight Mode faz.
Que definição escolher para um site empresarial em WordPress
Para um site que vive das pesquisas no Google, uma configuração sensata é esta:
| Categoria | Definição | Porquê |
|---|---|---|
| Search | Allow | É o tráfego da pesquisa que pretende |
| Training | Allow ou Disallow AI Training | Disallow AI Training exprime a recusa através do robots.txt, sem bloquear o Googlebot |
| Agent | Allow | Os agentes de IA visitam o site em nome de uma pessoa concreta, muitas vezes um potencial cliente |
Reserve Block para situações em que quer mesmo desaparecer dos motores de pesquisa, por exemplo num ambiente de testes ou num painel que não deve ser indexado. Para isso, de qualquer forma, funcionam melhor o noindex e a proteção por palavra-passe.
Se preferir que os seus conteúdos não apareçam nas respostas de IA, essa é uma decisão separada. Tem ferramentas próprias no Google e trato-a no âmbito da otimização GEO e LLMO. O bloqueio na periferia do Cloudflare não serve para isso, porque elimina a pesquisa juntamente com a IA.
Antes de bloquear um crawler, conte quantos pedidos ele faz por cada visitante que lhe envia. Nick Gray descreveu a 7 de agosto de 2026 o seu site PatronView, com 1,5 milhões de páginas: num só dia recebeu 3,6 milhões de pedidos de bots chineses, o Google fez 46 rastreios por cada visitante enviado e o Bingbot fez 158 610 pedidos para 680 visitantes. A regra de skip para bots verificados, (cf.client.bot), está colocada depois das regras de bloqueio e antes das regras de desafio, por isso um bot bloqueado continua bloqueado, mas o Googlebot nunca recebe um desafio. Só 0,24% dos seus desafios são resolvidos, o que o autor interpreta como sinal de que atingem quase só bots.
O lado jurídico continua em aberto. Em junho de 2025, Brian Williamson, da Communications Chambers, publicou o relatório AI, Copyright and the Public Good, que segundo a sua própria nota é independente e financiado pela Google. O relatório propõe tratar o treino de IA com obras protegidas por direitos de autor como utilização legítima (fair use), considera dispendiosos os mecanismos de opt-out e as obrigações de transparência e quer centrar o direito de autor na questão de saber se os resultados da IA infringem direitos. É uma proposta política, não lei em vigor. Por agora, o controlo que está de facto nas suas mãos são as definições de bots na periferia da rede, por isso configure-as de forma a não bloquear o Googlebot juntamente com os crawlers de IA.
Exemplo das definições de bots de IA do Cloudflare num site real
O wppoland.com está no Cloudflare, por isso testei-o no próprio site a 8 de outubro de 2026. A API do Cloudflare devolve para a nossa zona ai_training, ai_search e ai_user com o valor disabled, e o antigo interruptor ai_bots_protection também está em disabled. Nenhum bloqueio de bots de IA está ativo.
O Search Console confirma-o do outro lado: a inspeção de URL para /pl/ mostra o último rastreio a 8 de outubro de 2026 às 12:12, a obtenção da página bem-sucedida e o robots.txt a permitir o acesso. Trata-se de uma zona com uma definição, e todo o problema está precisamente em as definições variarem de zona para zona.
Lista de verificação das definições de bots de IA no Cloudflare
- Execute o teste em direto no Search Console para a página inicial e para um artigo com anúncio.
- Reveja as estatísticas de rastreio à procura de respostas 403 desde 15 de setembro de 2026.
- Abra as Security Settings da zona no Cloudflare e verifique Search, Training e Agent.
- Não use Block se quiser continuar no Google. Para recusar o treino existe Disallow AI Training.
- Verifique o ficheiro final
/robots.txt, porque tanto o Cloudflare como o plugin de SEO escrevem nele. - Se o seu domínio foi adicionado ao Cloudflare depois de 15 de setembro, verifique que conjunto predefinido foi escolhido ao adicionar o domínio.