O registo de alterações da documentação Google Search Central de 1 de outubro de 2026 indica uma única alteração: o guia sobre a utilização de conteúdo gerado por IA foi atualizado com informação das Search Quality Raters guidelines. A página das políticas de spam foi atualizada pela última vez a 28 de agosto de 2026. Em vários círculos de marketing digital, isto foi descrito como o fim dos artigos apoiados por IA. Os factos e os dados disponíveis mostram uma realidade distinta. A política antispam visa muitas páginas criadas sobretudo para manipular o posicionamento, seja qual for a forma como foram geradas. Usar um modelo linguístico não é o fator desencadeante.
Correção, 20 de novembro de 2026. Uma versão anterior deste artigo datou mal as alterações da Google e descreveu mecanismos que a Google nunca publicou. O registo de alterações de 1 de outubro de 2026 indica uma única alteração no guia sobre conteúdo gerado por IA. Foram removidas a descrição de como o contentEffort é calculado e as afirmações sobre classificadores de imagem.
Caso administre um portal corporativo em WordPress, uma plataforma de comércio eletrónico em WooCommerce ou uma arquitetura moderna em Astro, é essencial dominar os critérios de engenharia utilizados pelos motores de busca. Neste guia técnico, analisamos o parâmetro contentEffort descoberto na fuga de documentação interna da Google, confrontamos as declarações oficiais com investigações de mercado da Ahrefs e Lily Ray e detalhamos procedimentos reproduzíveis para proteger páginas locais de cidades, glossários técnicos e páginas de autores contra quedas de visibilidade orgânica.
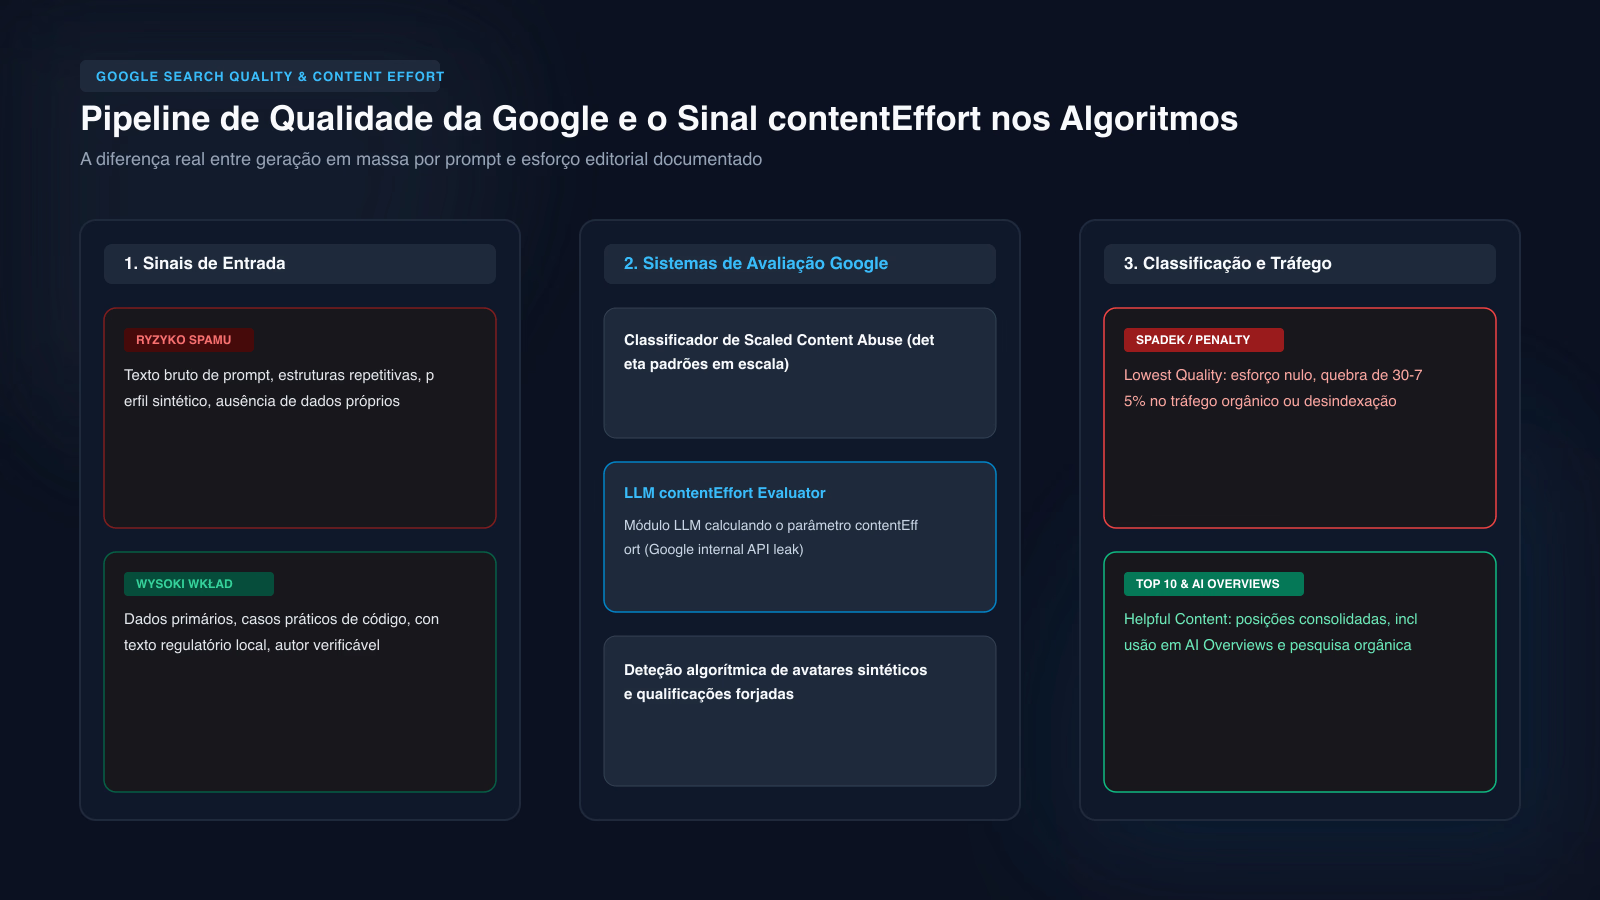
Fluxo de avaliação da qualidade da Google: Dos sinais de entrada ao módulo de pontuação contentEffort e filtros de spam até à decisão final de posicionamento. Fonte: Análise técnica da equipa wppoland.com baseada nas Google Search Essentials, revista a 1 de novembro de 2026.
O conteúdo gerado por IA é banido pelo Google?
A dúvida mais recorrente entre responsáveis técnicos e gestores de comércio eletrónico é se a publicação de artigos redigidos através de ChatGPT, Claude ou integrações diretas de API acarreta penalizações automáticas. A resposta prática e objetiva é não, desde que a publicação resolva efetivamente o problema de quem pesquisa e demonstre um investimento substancial de trabalho.
Nas políticas oficiais relativas a spam na Web (Spam Policies for Google Web Search), a Google não impede a utilização de sistemas automatizados. A formulação determinante foca-se no abuso de conteúdos em escala (scaled content abuse):
O abuso de conteúdos em escala ocorre quando muitas páginas são geradas com o propósito primário de manipular classificações nos motores de busca e não para ajudar os utilizadores. Esta prática abusiva foca-se habitualmente na criação de grandes volumes de conteúdos não originais que acrescentam pouco ou nenhum valor, independentemente de como foram criados.
Google Search Central, Spam Policies, secção Scaled content abuse (tradução própria)
Repare na expressão fulcral: “independentemente de como foram criados”. A política não estabelece uma divisão entre fábricas de cópia baratas, agregadores automáticos de feeds RSS e modelos de linguagem. O que conta é se muitas páginas existem sobretudo para manipular o posicionamento em vez de ajudar os utilizadores. Se o seu website publicar parágrafos longos que apenas reorganizam os dez primeiros resultados sem fornecer medições nem análise própria, fica exposto a esta política.
Do lado dos avaliadores, as Search Quality Rater Guidelines (de 11 de setembro de 2025) referem funcionalidades de página como calculadoras e jogos como conteúdo principal (Main Content). É orientação para avaliadores humanos, não uma alteração de 1 de outubro. Uma página com 300 palavras de contextualização rigorosa e um simulador a funcionar sem falhas pode servir melhor quem pesquisa do que um texto de 3000 palavras sobre conceitos genéricos.
Se pretende avaliar o estado atual da sua plataforma perante as novas exigências técnicas, é recomendável efetuar um diagnóstico profundo. Na WPPoland executamos avaliações globais de infraestrutura através do serviço de verificação de site WordPress, inspecionando o desempenho de renderização e a arquitetura de indexação.
O que é o contentEffort na fuga de documentos da Google?
Em maio de 2024, milhares de páginas de documentação de APIs internas da Google tornaram-se públicas. Analistas independentes, entre eles a SparkToro e a iPullRank, examinaram os atributos até então não documentados.
Um deles chama-se contentEffort. Na documentação divulgada (módulo QualityNsrPQData) é descrito apenas como “estimativa de esforço baseada em LLM para páginas de artigos” (tradução própria). Esta é toda a descrição verificada. A Google não publicou como o valor é calculado, que dados usa nem que peso tem no posicionamento.
Trate-o como uma indicação de direção, não como uma pontuação que se possa medir e otimizar. As páginas que acrescentam provas próprias (medições, capturas de ecrã, código, dados de projetos) estão melhor posicionadas do que as que repetem o que já aparece na primeira página de resultados, faça o campo o que fizer internamente.
As orientações para avaliadores apontam no mesmo sentido. As Search Quality Rater Guidelines em vigor (de 11 de setembro de 2025) usam na secção 4.6.6 a expressão “pouco ou nenhum esforço” (tradução própria) para conteúdo principal sem esforço real.
Quantas páginas com IA estão realmente no top 10 da Google?
Para definir um plano operacional sólido, é fundamental analisar dados objetivos resultantes de estudos de mercado a larga escala.
Uma investigação aprofundada desenvolvida pela Ahrefs avaliou milhares de pesquisas com forte volume de procura para medir a percentagem de páginas posicionadas na primeira página que resultavam de inteligência artificial:
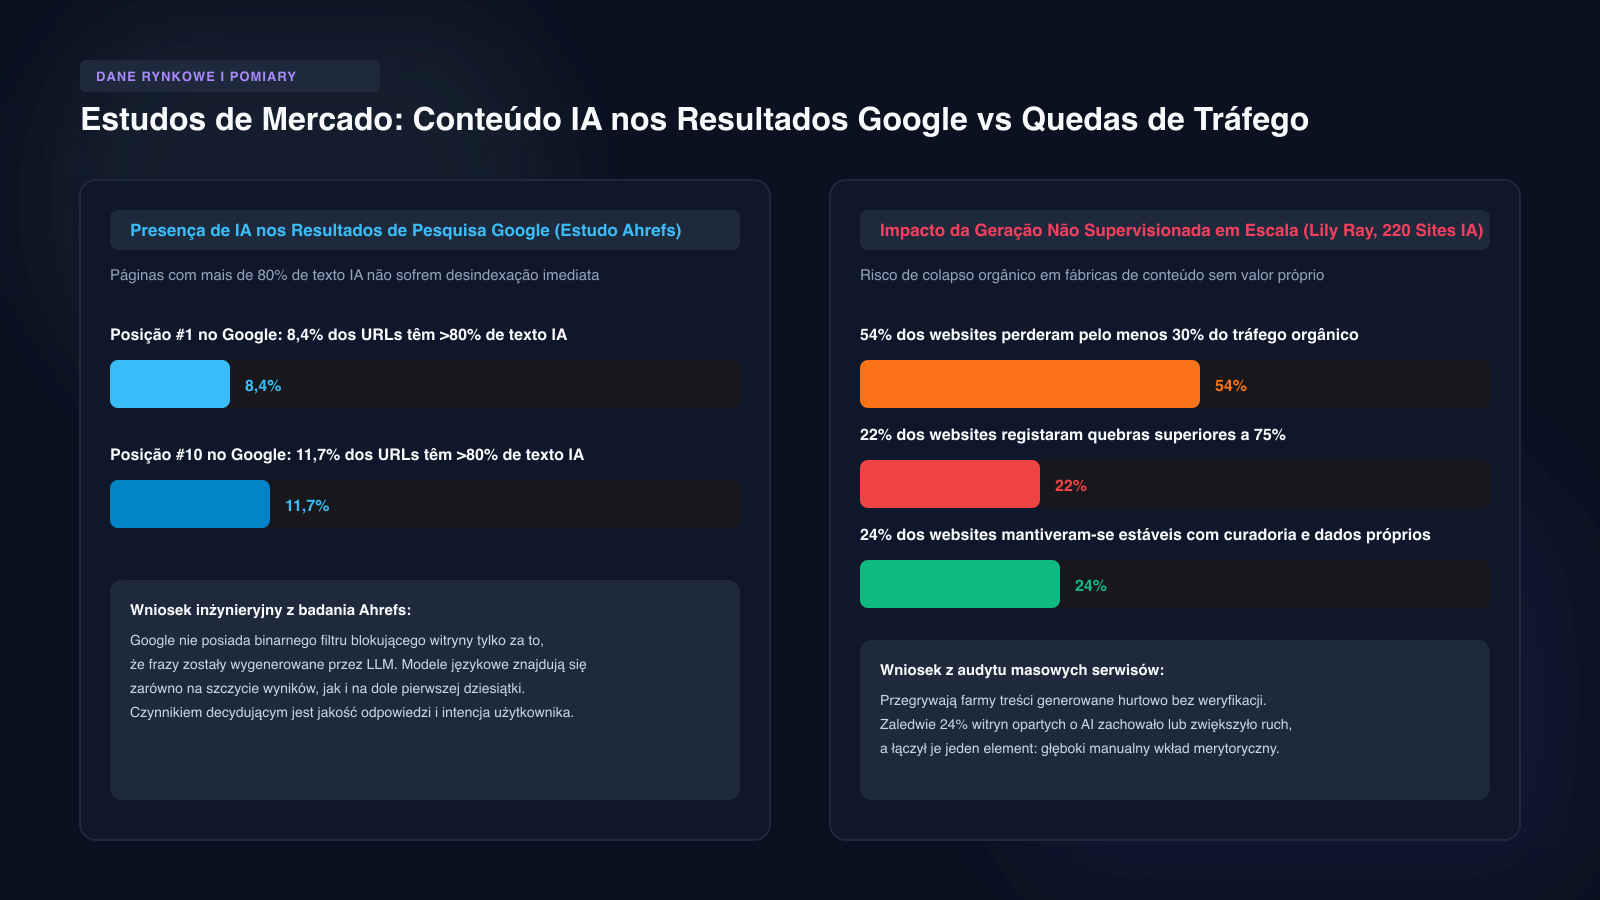
Presença de conteúdos criados por IA no top 10 da Google segundo a Ahrefs e quebras de tráfego em sites com estratégias de conteúdo com IA relatadas por Lily Ray. Fontes: estudo da Ahrefs sobre conteúdo com IA e Lily Ray no Search Engine Journal.
Na primeira posição dos resultados orgânicos da Google, 8,4% das páginas analisadas tinham pelo menos 80% de conteúdo gerado por IA. Na décima posição, o valor era de 11,7%.
Estes números mostram que um modelo linguístico, por si só, não deixa uma página fora do top 10. Não mostram porque é que essas páginas lá estão: a autoridade do domínio, as hiperligações, a experiência de página e a adequação à intenção de pesquisa são fatores plausíveis que o estudo não separa.
A situação é diferente nas plataformas que usaram a IA como linha de montagem industrial sem validação técnica. Lily Ray relatou no Search Engine Journal 220 sites com estratégias de conteúdo com IA:
- 54% perderam pelo menos 30% do tráfego orgânico.
- 22% perderam pelo menos 75% do tráfego orgânico.
O risco não provém do recurso à ferramenta, mas da suposição de que é possível contornar os algoritmos sem contribuir com valor autêntico. Na WPPoland apoiamos empresas afetadas através do serviço de recuperação de sites feitos por IA, transformando compilações frágeis em recursos técnicos de confiança.
Que páginas perdem mais tráfego após uma atualização?
A inspeção aos websites que sofreram perdas drásticas de visibilidade evidencia oito modelos de organização interna particularmente vulneráveis às verificações de conteúdo em escala:
Páginas de comparação de pares de produtos (Ferramenta A vs. Ferramenta B). Plataformas de afiliação geram frequentemente milhares de cruzamentos através de rotinas de código. Dado que o sistema gera matrizes idênticas e deduções vagas para cada combinação, o leitor não encontra avaliações reais de desempenho nem medições em contexto de produção.
Entradas de glossário desprovidas de aplicação prática. A criação contínua de páginas breves de 300 palavras para termos comuns (como “o que é uma API” ou “o que significa headless CMS”). Estes conteúdos perdem visibilidade porque a Google responde diretamente no motor através de AI Overviews ou remete para a Wikipédia.
Listagens comparativas que elegem a própria empresa em primeiro lugar sem fundamentação. Artigos com títulos como “As 10 melhores agências web”, nos quais o proprietário do portal se autoatribui a classificação máxima e aponta defeitos vagos aos rivais. A carência de testes comprováveis leva à rotulagem do conteúdo como pouco confiável.
Modelos de “alternativas a [concorrente]”. Páginas de captura preparadas para recolher pesquisas por marcas estabelecidas. Quando estes artigos se limitam a reescrever preços públicos sem analisar limites de API, procedimentos de migração ou níveis de serviço de suporte, são desvalorizados como conteúdo de baixa substância.
Páginas locais repetitivas para otimização regional. Uma prática ainda muito comum em que uma descrição de serviços com 1500 palavras é multiplicada por dezenas de concelhos em Portugal, alterando somente o nome da localidade no título H1 e nos parágrafos iniciais.
Coleções de perguntas e respostas para GEO e AEO. A proliferação de pequenas páginas com perguntas frequentes na tentativa de obter menções no Perplexity ou SearchGPT. Sem documentação original de suporte, estes URLs enfrentam desindexação rápida.
Artigos laterais não relacionados com a atividade da empresa (parasite SEO). A publicação de conselhos sobre finanças pessoais ou dietas num domínio dedicado à comercialização de materiais de construção, com o único objetivo de captar impressões genéricas. A Google afere com rigor a autoridade temática central (Topical Authority).
Catálogos importados sem testes práticos de produto. Plataformas de dropshipping que recebem feeds de fornecedores e submetem as descrições a ferramentas automáticas de reescrita. Sem registos fotográficos originais, verificações dimensionais ou ensaios de funcionamento, o contentEffort é nulo.
Estes oito formatos partilham o mesmo defeito de conceção: foram planeados para manipular robôs de pesquisa e não para esclarecer dúvidas de utilizadores reais.
Como proteger páginas de cidades de conteúdo duplicado?
As páginas locais de serviços (por exemplo, /criacao-sites-lisboa/, /criacao-sites-porto/ ou /criacao-sites-coimbra/) representam canais fundamentais de angariação comercial. No entanto, replicar quase a mesma estrutura por dezenas de localizações gera uma vulnerabilidade crítica para o domínio.
Sempre que a Google reconhece que uma rede de páginas locais partilha texto idêntico trocando somente os identificadores municipais, enquadra-se na definição de abuso de conteúdo em escala citada acima. A Google não publicou um mecanismo de penalização de todo o domínio, pelo que o mais prudente é assumir que o site inteiro pode ser afetado.
Para blindar as páginas de cidades em Portugal, deve estruturar uma arquitetura de diferenciação com elementos que um modelo de IA não consegue fabricar sem dados reais:
Primeiro: Documente projetos reais executados no distrito ou concelho visado. Em vez de menções abstratas, descreva trabalhos concretos: identifique o cliente da região, pormenorize as ligações estabelecidas a sistemas de inventário e aponte os desafios de alojamento superados.
Segundo: Enquadre a atividade nas obrigações regulamentares nacionais. No contexto do mercado português, cumpra com rigor o Decreto-Lei n.º 24/2014, de 14 de fevereiro, relativo aos contratos celebrados à distância, e o Código da Publicidade (Decreto-Lei n.º 330/90, alterado pelo Decreto-Lei n.º 57/2008), que proíbe práticas comerciais desleais e enganosas. Como entidades de referência na fiscalização, mencione a Autoridade de Segurança Alimentar e Económica (ASAE) e a Direção-Geral do Consumidor (DGC), além da Comissão Nacional de Proteção de Dados (CNPD) na gestão de registos. No caso de relações comerciais internacionais com clientes europeus, aplique o Regulamento Roma I (Regulamento (CE) n.º 593/2008 Art. 6.º). Não mencione normas de outros países que não se apliquem a Portugal.
Terceiro: Apresente dados logísticos e operacionais detalhados. Se disponibiliza soluções de comércio eletrónico, especifique procedimentos de envio nacionais, tempos de trânsito locais e pontos de recolha presenciais.
Quarto: Use dados estruturados que correspondam à realidade. Descreva uma localização física apenas se a empresa tiver uma. Uma empresa que trabalha totalmente em remoto não deve inventar morada de escritório, telefone nem coordenadas, e pode usar areaServed com uma referência inequívoca à Wikidata.
Segue-se um exemplo de JSON-LD para uma página local de serviços. Todos os valores são marcadores de posição (example.com), substitua-os pelos seus próprios dados:
{
  "@context": "https://schema.org",
  "@type": "ProfessionalService",
  "name": "Agência Web de Exemplo",
  "url": "https://example.com/lisboa/",
  "areaServed": {
    "@type": "City",
    "name": "Lisboa",
    "sameAs": "https://www.wikidata.org/wiki/Q597"
  }
}
Ao enriquecer as páginas com dados geográficos e institucionais reais, o conteúdo resiste a auditorias algorítmicas de semelhança.
Como evitar que glossários percam posições?
A publicação de glossários técnicos foi, durante anos, um dos métodos mais utilizados para acumular rapidamente centenas de páginas indexadas. Com as mais recentes revisões algorítmicas, os websites que assentavam nesta estratégia perderam, em muitos casos, mais de metade dos utilizadores.
Uma definição padronizada de manual tem uma classificação residual de contentEffort. Quando um profissional pesquisa por “o que é uma chamada REST”, a Google disponibiliza a explicação de imediato nos seus próprios módulos informativos em vez de encaminhar o tráfego para páginas repetitivas.
Para sustentar um glossário de engenharia, cada conceito deve conter um comprovativo de implementação técnica (production proof):
- Definição concisa: Uma a duas frases com formulação técnica rigorosa, afinadas para blocos speakable.
- Amostra de código real: Mostre a aplicação concreta. Ao clarificar o funcionamento da “Transients API no WordPress”, forneça a chamada verídica a
set_transient()acompanhada do prazo de expiração e das rotinas de salvaguarda. - Resolução de falhas e análise de limites: Explique os incidentes decorrentes de um uso incorreto (por exemplo, a saturação de memória na tabela
wp_options).
| Parâmetro | Implementação Vulnerável (Elevado Risco) | Documentação de Engenharia (Elevado contentEffort) |
|---|---|---|
| Definição Teórica | Três parágrafos genéricos de IA afirmando que a indexação de bases de dados é fundamental. | Uma frase técnica definindo o índice como uma estrutura B-Tree que encurta o tempo de pesquisa de registos. |
| Exemplo Prático | Ausência de código ou consulta SQL elementar retirada de um curso de introdução. | Análise SQL avançada com recurso a EXPLAIN ANALYZE sobre consultas frequentes em tabelas WooCommerce. |
| Diagnóstico | Alerta vago de que tabelas lentas afetam a experiência do visitante. | Avaliação documentada de bloqueios de escrita e sobrecarga de CPU acima de 90% em cenários de tráfego intenso. |
| Proteção de Dados | Nenhuma menção a privacidade ou conservação de dados. | Protocolo de expurgo de identificadores pessoais nos registos de erro em conformidade com o RGPD (Art. 5.º, n.º 1, alínea e). |
Com esta profundidade, o glossário afirma-se como manual de trabalho consultado por profissionais e preservado pelos motores de busca.
Fotos de autor geradas por IA prejudicam o SEO?
No intuito de forjar sinais de E-E-A-T, vários projetos criaram especialistas inventados com recurso a imagens geradas por redes neuronais.
As Search Quality Rater Guidelines indicam aos avaliadores humanos que procurem imagens geradas por IA em perfis de autor falsos. A Google não publicou se, nem como, deteta essas imagens de forma automática. Afirmações sobre a geometria das pupilas ou das orelhas são conjeturas, não documentação.
O problema é prático. Se um suposto especialista em sistemas de informação ou conformidade jurídica não deixa qualquer rasto verificável (sem registos corporativos, sem conta ativa em GitHub ou LinkedIn e sem menções em fontes externas), os leitores e os avaliadores não têm motivo para acreditar nos seus conselhos.
Em Portugal, esta prática viola o regime legal da publicidade e defesa do consumidor. De acordo com o Decreto-Lei n.º 57/2008, de 26 de março (que transpõe a Diretiva 2005/29/CE), consubstancia uma prática comercial enganosa prestar informações inverídicas sobre a identidade, as qualificações ou os direitos do profissional, sujeitando a empresa a sanções contraordenacionais aplicadas pela ASAE.
Procedimentos recomendados para configurar perfis de autor no WordPress:
- Associe os artigos aos consultores e engenheiros reais que elaboraram ou verificaram tecnicamente a informação.
- Apresente imagens genuínas captadas no contexto de trabalho, codificadas em formato AVIF sem filtros de distorção.
- Configure o esquema
Personem JSON-LD com o preenchimento desameAsa apontar para plataformas externas. Todos os valores do exemplo são marcadores de posição (example.com), substitua-os pelos seus próprios dados:
{
  "@context": "https://schema.org",
  "@type": "Person",
  "name": "Autor de Exemplo",
  "worksFor": {
    "@type": "Organization",
    "name": "Empresa de Exemplo",
    "url": "https://example.com"
  },
  "url": "https://example.com/autor/autor-de-exemplo/",
  "sameAs": [
    "https://github.com/autor-de-exemplo",
    "https://www.linkedin.com/in/autor-de-exemplo/"
  ]
}
A transparência autoral assegura a blindagem algorítmica do domínio e reforça a credibilidade perante clientes empresariais.
O que é o teste do prompt único?
O teste do prompt único (single prompt test) traduz-se numa regra prática formulada por engenheiros de pesquisa para calcular a resiliência de um conteúdo face a desvalorizações automatizadas.
O fundamento é direto: Se um concorrente puder colar o título do seu artigo no ChatGPT ou Claude como um comando isolado e obter uma resposta que se equipare ao seu texto em tópicos, deduções e profundidade, a sua publicação não possui qualquer valor defensivo perante os motores de busca.
Essas páginas serão inevitavelmente empurradas para posições secundárias:
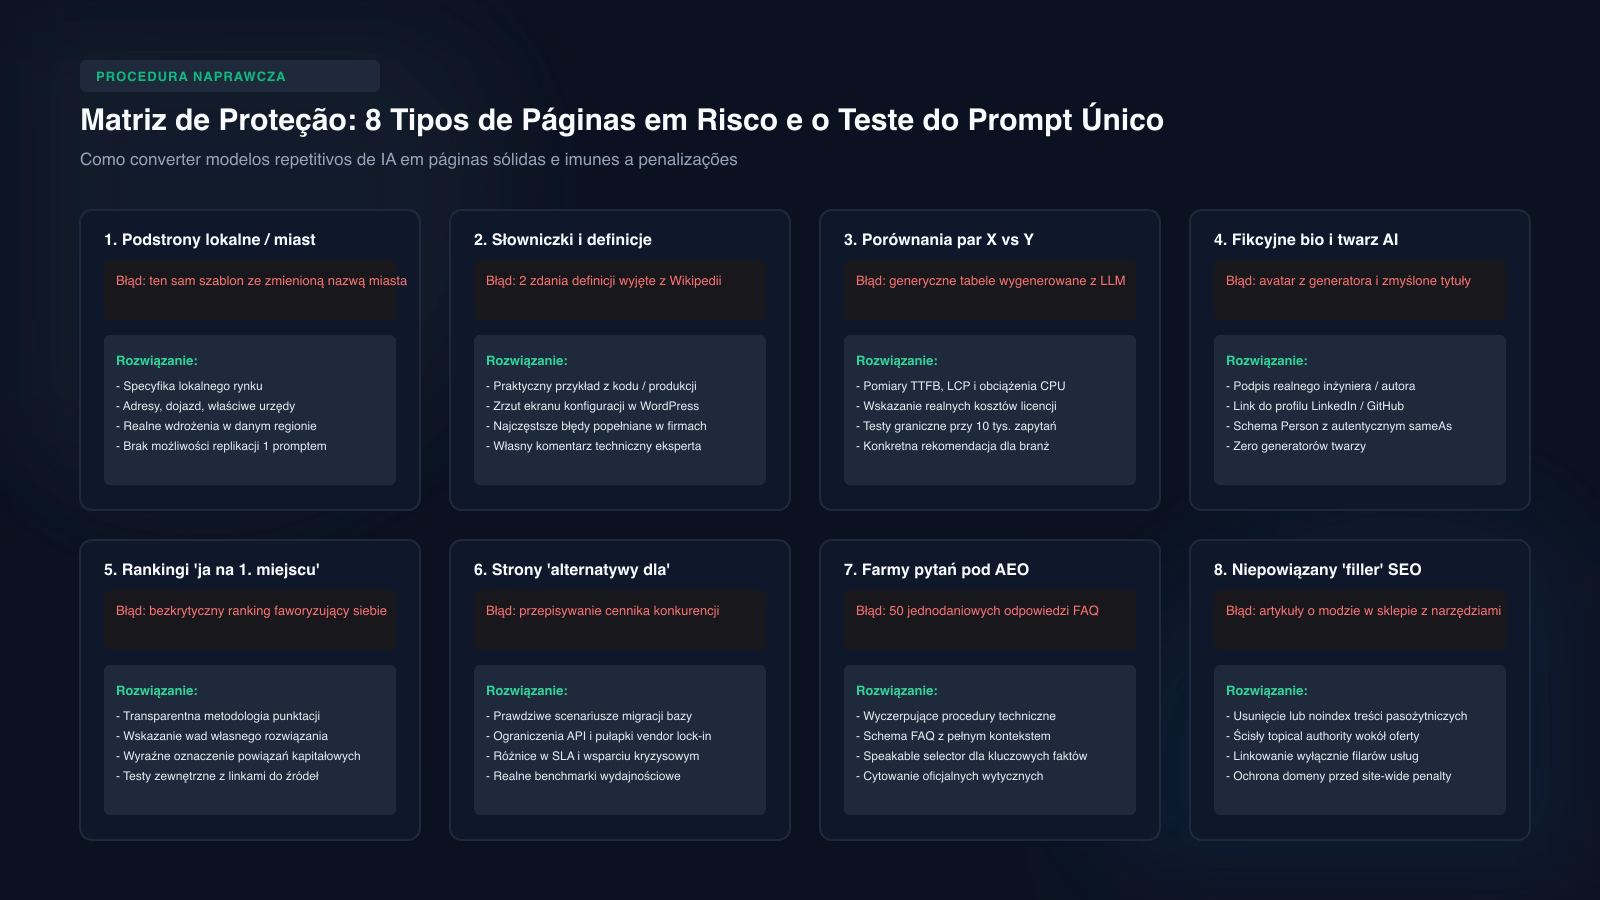
Matriz de correção para oito formatos de páginas vulneráveis evidenciando as ações técnicas exigidas para superar o teste do prompt único. Fonte: Metodologia WPPoland, 2026.
Como aplicar o teste de verificação no seu projeto:
Passo 1: Extraia uma amostra de cinco artigos técnicos ou categorias de produtos do seu gestor de conteúdos. Passo 2: Submeta os títulos literais a um modelo avançado sem incluir instruções adicionais. Passo 3: Confronte a versão de IA com o seu artigo em quatro questões objetivas:
- O seu texto original contém valores, calendários, despesas ou especificações de hardware ausentes da resposta do modelo?
- O seu artigo integra capturas de ecrã ou desenhos de arquitetura de plataformas sob a sua gestão?
- O texto expressa um posicionamento técnico definitivo decorrente da experiência diária (como a recusa justificada de um plugin problemático)?
- A sua publicação apoia-se em diplomas legais, normas técnicas oficiais ou orientações de fornecedores reconhecidos?
Caso a resposta seja negativa, a publicação não passa no teste e corre sérios riscos em atualizações futuras.
Para superar a fasquia, cada artigo deve incorporar elementos impossíveis de gerar com base num comando isolado:
- Relatórios de ensaios de stress reais (como testes de carga com k6 a simular 500 encomendas simultâneas em WooCommerce).
- Análises aprofundadas a ficheiros de registo de servidores com o comportamento do robô de rastreio.
- Casos documentados com evoluções mensuráveis de tempo de carregamento (LCP).
- Módulos de código originais para transpor limitações em integrações de software.
Este cuidado garante que a sua plataforma se mantenha como fonte de verdade primária (source of truth). No âmbito dos nossos projetos de otimização GEO e LLMO, integramos esquemas semânticos que projetam a relevância dos dados tanto para sistemas convencionais como para motores de IA.
O que fazer quando o site perde tráfego após uma atualização?
Quando uma plataforma institucional ou loja virtual sofre um retrocesso expressivo de tráfego orgânico, eliminar conteúdos de forma desordenada só agrava o problema. A reversão sustentável exige a execução de um protocolo metódico em cinco etapas:
Etapa 1: segmentar os dados na Search Console
Examine o histórico da Google Search Console confrontando as últimas quatro semanas com o intervalo precedente à alteração algorítmica. Distribua os endereços por três grupos:
- Páginas com contrações superiores a 70% em visualizações e acessos.
- Páginas resilientes que mantiveram estabilidade e sustentam a autoridade do domínio.
- Endereços desindexados na totalidade, o que sinaliza a aplicação de filtros contra conteúdo em escala.
Descubra os modelos mais penalizados: foram páginas de cidades sem diferenciação, artigos de blogue sem revisão ou catálogos gerados mecanicamente?
Etapa 2: tratar artigos desatualizados
Se o domínio acumulou centenas de publicações que não têm qualquer correlação com o objeto central da sua atividade, liberte-se desse passivo:
- Configure reencaminhamentos 301 para as páginas principais correspondentes sempre que os URLs tiverem referências externas de valor.
- Aplique o cabeçalho HTTP
X-Robots-Tag: noindexse os ficheiros precisarem de continuar acessíveis aos clientes habituais mas devam ser retirados da pesquisa. - Devolva o código de resposta HTTP 410 Gone para documentos sem utilidade, forçando os motores a expurgá-los de imediato da fila de rastreio.
Etapa 3: rever as páginas que geram faturação
Selecione os 20% de URLs mais relevantes entre os que foram atingidos e que historicamente geravam pedidos de contacto ou vendas:
- Elimine introduções banais criadas por IA e introduza parâmetros técnicos concretos.
- Integre ilustrações próprias, esquemas de infraestrutura e registos visuais genuínos.
- Implemente esquemas Schema.org com ligações a conceitos registados na Wikidata.
- Associe cada texto a autores verificáveis com historial de atividade demonstrável.
Etapa 4: corrigir problemas de rastreio
As plataformas com produção volumosa acumulam frequentemente debilidades no processamento. Pedidos excessivos à base de dados no WordPress, ausência de cache persistente e scripts pesados esgotam o orçamento de rastreio antes da reavaliação das páginas importantes.
Intervenções na camada de alojamento:
- Instale cache de objetos com Redis para aliviar consultas no WooCommerce.
- Configure o serviço de cache na borda (Edge Caching) através de Cloudflare Workers para respostas em milissegundos.
- Limpe o ficheiro
robots.txtpara impedir a navegação inútil por filtros dinâmicos de pesquisa.
Etapa 5: voltar a submeter e acompanhar
Volte a introduzir os ficheiros de sitemap XML na Google Search Console. A recuperação da avaliação de confiança de um domínio não se dá de forma imediata. Os rastreadores precisam de revisitar as alterações diversas vezes para comprovar a evolução dos sinais de qualidade, um ciclo que se estende normalmente entre 4 a 12 semanas.
| Fase | Ações Operacionais | Meta Técnica |
|---|---|---|
| Semanas 1-2 | Diagnóstico na Search Console, aplicação de noindex e 410 em publicações degradadas. | Alívio da capacidade de rastreio e travagem de quedas adicionais. |
| Semanas 3-6 | Remodelação das páginas essenciais com dados originais e esquemas ricos. | As páginas passam a ter provas próprias e recuperam em termos secundários. |
| Semanas 7-10 | Aperfeiçoamento de Core Web Vitals, ativação de Edge Caching e validação de autores. | Reforço de critérios E-E-A-T e intensificação do rastreio. |
| Semanas 11-16 | Conclusão do reprocessamento e recuperação de menções em AI Overviews e pesquisas. | Consolidação dos termos estratégicos de negócio. |
A evolução dos motores de busca não impede a utilização inteligente da tecnologia, antes exige maior rigor aos profissionais. Ganham as organizações que encaram os modelos de linguagem como auxiliares de engenheiros experientes e não como alternativa à qualidade e à verdade técnica.