Três definições confundem-se quando o dono de um site diz “quero ficar fora da IA”. Uma está no Search Console, outra no robots.txt sob o token Google-Extended, outra no robots.txt como linha Content-Signal. Respondem a perguntas diferentes e nenhuma é um interruptor geral de IA.
As páginas do Google traçam os limites com clareza suficiente. O problema é que estão espalhados por quatro páginas. Este artigo põe-nos lado a lado, cita cada página onde importa e termina com uma tabela para escolher. Todas as citações foram lidas a 6 de outubro de 2026.
O wppoland.com serve de caso de teste porque é incómodo: seis subpastas de idioma, cada uma verificada como propriedade de prefixo de URL própria sob uma propriedade de domínio, e um robots.txt que já tem uma linha Content-Signal. Não medimos qualquer efeito destes interruptores no tráfego e nada do que se segue afirma um.
Uma nota sobre a grafia das citações. A página de ajuda do Google, pedida com hl=pt-PT a 6 de outubro de 2026, é servida em português do Brasil. O controlo chama-se “Controle de uso na IA generativa da Pesquisa”, o caminho é “Configurações > IA generativa na Pesquisa” e as funcionalidades aparecem como “Visões gerais criadas por IA” e “Modo IA”. Estes são os rótulos que a página do Google mostra, e não sabemos o que a interface real do Search Console apresenta além disso. Em português europeu escrever-se-ia “controlo” e “definições”, por isso o leitor encontrará nas citações uma grafia diferente da do texto à volta. As citações mantêm-se tal como o Google as publica.
Que interruptor do Google retira o meu site das Visões gerais criadas por IA e do Modo IA
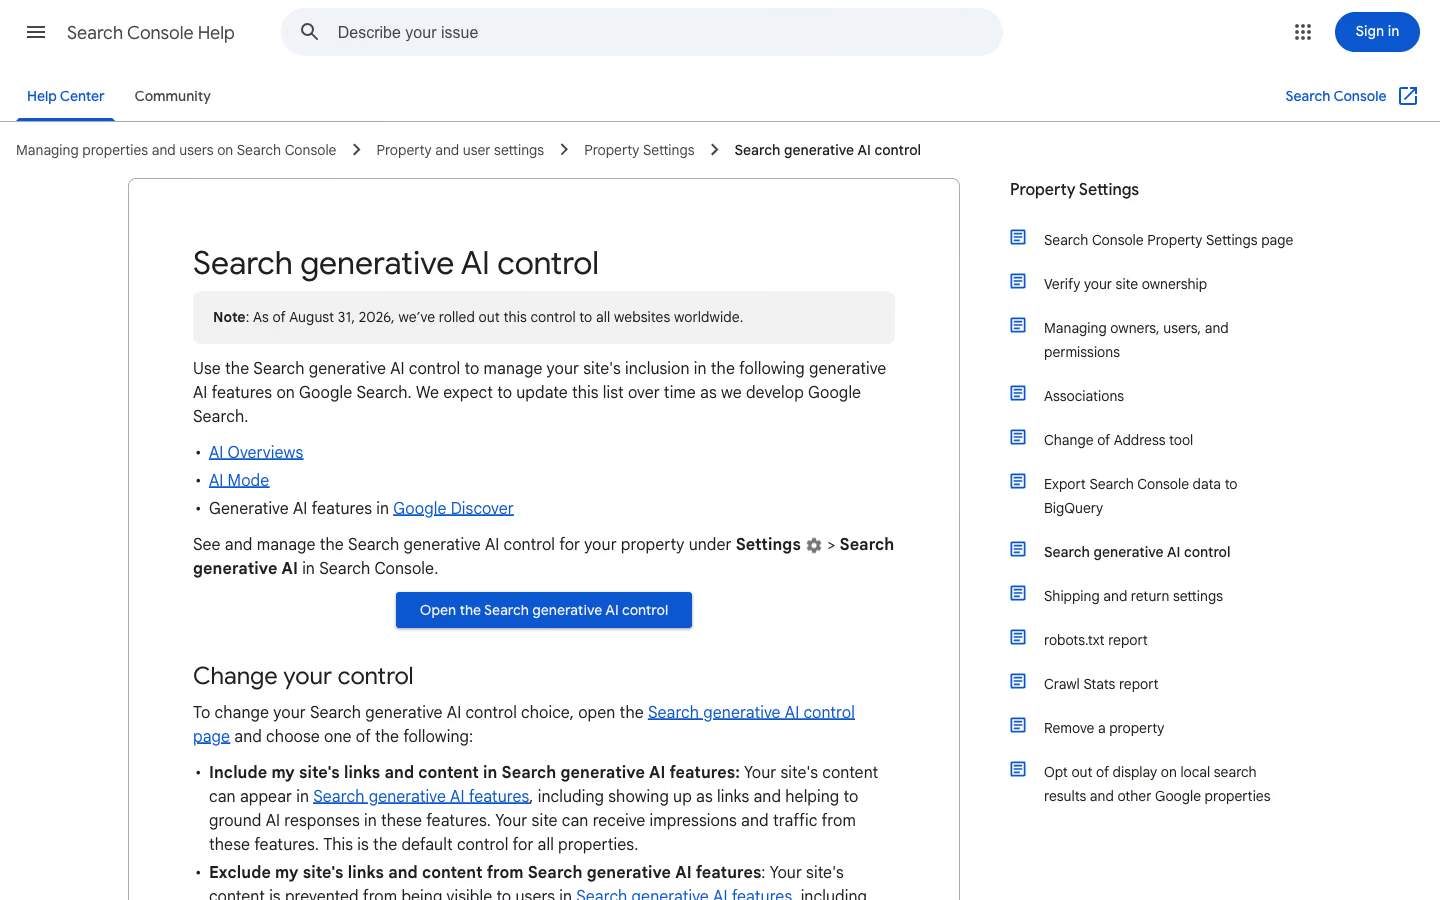
O controlo de IA generativa na Pesquisa, no Search Console. Segundo a página do Google, fica em “Configurações > IA generativa na Pesquisa”. A página de ajuda enumera o que o controlo gere: as Visões gerais criadas por IA, o Modo IA e as funcionalidades de IA generativa no Google Discover, e diz que a lista será atualizada com o tempo. Sobre a disponibilização:
“em 31 de agosto de 2026, lançamos esse controle para todos os sites do mundo.”
Ajuda do Search Console, Controle de uso na IA generativa da Pesquisa
A escolha é entre incluir, excluir e herdar da propriedade mãe. Incluir é o controlo predefinido para todas as propriedades, e herdar é o predefinido para uma propriedade que tem mãe. O que faz excluir:
“Se você excluir seu site, os links para ele e o conteúdo dele não vão aparecer nos recursos de IA generativa na Pesquisa. O conteúdo de outros sites ainda estará disponível nesses recursos e poderá parecer semelhante ao seu. O conteúdo rastreado do seu site não poderá ser usado como entrada para gerar uma resposta ou prévia de IA nos recursos de IA generativa na Pesquisa.”
Ajuda do Search Console, Controle de uso na IA generativa da Pesquisa
Dois pormenores contam. Saem também as ligações, não só o texto, pelo que isto não é uma forma de ser mencionado sem receber cliques. E a entrada de fundamentação está coberta, ou seja, o conteúdo excluído não serve para construir uma resposta nestas funcionalidades.
O Google explicita também o que o controlo não é:
“Esse controle afeta apenas a exibição do seu conteúdo em determinados recursos de IA generativa na Pesquisa. Ele não é usado como indicador de classificação ou inclusão para outras partes da Pesquisa.”
Ajuda do Search Console, Controle de uso na IA generativa da Pesquisa
“Esse controle não afeta o treinamento de IA. Para limitar o treinamento dos modelos usados para gerar respostas nos recursos de IA generativa na Pesquisa, use Google-Extended. Para impedir que seu conteúdo apareça na Pesquisa Google, use noindex.”
Ajuda do Search Console, Controle de uso na IA generativa da Pesquisa
Quanto ao prazo, a página diz que uma alteração demora geralmente alguns dias: o conteúdo é excluído 1 a 2 dias depois de o controlo entrar em vigor e parte dele mais tarde, por causa da cache e da propagação.
Desde 21 de outubro de 2026, o controlo aparece também na página do Google sobre o que partilha com a Pesquisa Google, como opção para todo o site com que gere a inclusão do seu site nas Visões gerais criadas por IA e no Modo IA. O registo de alterações da documentação do Search Central data essa edição de 21 de outubro e descreve-a como o acrescento de opções que já existiam, pelo que o controlo em si não mudou.
O Google-Extended retira o meu site das Visões gerais criadas por IA
Não. O Google-Extended está documentado na página de visão geral dos rastreadores, e as áreas de produto que nomeia são o Gemini e o Vertex AI, não a Pesquisa:
“O Google-Extended é um token de produto independente que os publishers da Web podem usar para gerenciar se o conteúdo rastreado pelo Google nos sites deles pode ser usado para treinar futuras gerações de modelos Gemini que alimentam apps do Gemini e a API Vertex AI para Gemini e para embasamento (fornecer conteúdo do índice da Pesquisa Google ao modelo no momento do comando para melhorar a veracidade e a relevância) em apps do Gemini e Embasamento com a Pesquisa Google na Vertex AI.”
“O Google-Extended não afeta a inclusão de um site na Pesquisa Google nem é usado como um indicador de classificação na Pesquisa Google.”
Lidas em conjunto com a secção anterior, as duas páginas repartem o trabalho. O controlo da Pesquisa gere a fundamentação e a apresentação dentro das funcionalidades da Pesquisa. O Google-Extended gere o treino e a fundamentação feita pelas apps Gemini e pelo Vertex AI. Nenhuma das páginas diz cobrir a área da outra, e a página do controlo da Pesquisa remete para o Google-Extended no que toca ao treino.
Há uma consequência prática que decorre do funcionamento do token:
“O Google-Extended não tem uma string do user agent de solicitação HTTP separada. O rastreamento é feito com strings dos user agent atuais do Google. O token do user agent do robots.txt é usado em uma capacidade de controle.”
A nossa leitura: não existe nos registos de acesso uma linha Google-Extended para procurar, pelo que o grupo do robots.txt é o único sítio onde a escolha existe.
O que faz o Content-Signal no robots.txt para o Google
O Content-Signal é outra espécie de coisa. É uma diretiva de robots.txt publicada pela Cloudflare, com três sinais. O site define o ai-input assim:
“Introdução de conteúdo num ou mais modelos de IA (por exemplo, geração aumentada por recuperação, fundamentação ou outra recolha em tempo real de conteúdo para respostas de pesquisa com IA generativa).”
E o ai-train numa linha:
“Treino ou ajuste fino de modelos de IA.”
O terceiro sinal, search, abrange a construção de um índice de pesquisa e a devolução de ligações e pequenos excertos, e o site anota que “não inclui o fornecimento de resumos de pesquisa gerados por IA”. O mesmo site é direto quanto aos limites:
“A diretiva Content-Signal funciona sinalizando a sua preferência de permitir (yes) ou não permitir (no) certas categorias de ações de IA. Nem todos os sistemas automatizados respeitam os ficheiros robots.txt, e alguns podem ignorar estas diretivas Content-Signal.”
“Os ficheiros robots.txt exprimem as suas preferências. Não impedem, no entanto, que os operadores de rastreadores tirem o seu conteúdo a nível técnico.”
Nem a página de ajuda do Search Console nem a documentação dos rastreadores do Google citadas aqui mencionam o Content-Signal. Pesquisámos o texto de ambas e não encontrámos nenhuma ocorrência. Isto é uma afirmação sobre essas duas páginas, não sobre o que qualquer sistema do Google faz. Para efeitos de planeamento, significa que uma linha Content-Signal é uma declaração dirigida a todos os rastreadores e não um controlo do Google. O comportamento da linha dentro dos grupos do robots.txt está tratado no nosso artigo sobre o erro de âmbito do Content-Signal.
Se o seu site está atrás do Cloudflare, existe um quarto interruptor, que atua na periferia da rede em vez de no robots.txt. Desde 15 de setembro de 2026 a opção Block também bloqueia o Googlebot, como descrevo em o Cloudflare bloqueia o Googlebot.
O noindex e o nosnippet bloqueiam as Visões gerais criadas por IA
Ambos funcionam, ambos são pouco subtis, e não da mesma maneira.
O noindex retira a página da Pesquisa Google, e a própria página do controlo da Pesquisa indica-o como o caminho para isso. O custo é o óbvio: a página perde também os resultados orgânicos.
O nosnippet é mais estreito, e a documentação de robots meta do Google diz que chega às funcionalidades de IA:
“Não exibir um snippet de texto ou uma visualização de vídeo nos resultados da pesquisa para esta página. Uma miniatura de imagem estática (se disponível) vai continuar visível se essa opção resultar em uma melhor experiência do usuário. Isso se aplica a todas as formas de resultados da pesquisa (no Google: pesquisa na Web, Imagens do Google, Discover, Visões gerais criadas por IA e Modo IA) e impede que o conteúdo seja usado como entrada direta para as Visões gerais criadas por IA e o Modo IA.”
A ressalva está na primeira frase. O nosnippet retira o snippet também dos resultados normais de ligações azuis e é definido por página, pelo que pode custar cliques que o controlo da Pesquisa não custaria. Esta segunda parte é inferência nossa a partir das duas páginas, não uma medição.
Há mais uma armadilha, que apanha os sites que combinam ferramentas. O Google escreve:
“Essas configurações só poderão ser lidas e seguidas se os rastreadores tiverem permissão para acessar as páginas que as incluem.”
Um Disallow no robots.txt numa página que leva noindex ou nosnippet anula a etiqueta. O nosso robots.txt tem um comentário precisamente sobre isto para os arquivos de taxonomia, e é por isso que não os bloqueamos.
Que definição de IA do Google usar para cada objetivo
| Objetivo | Interruptor | O que bloqueia | O que não bloqueia |
|---|---|---|---|
| Fora das Visões gerais criadas por IA, do Modo IA e das funcionalidades generativas do Discover, mas dentro da Pesquisa | Controlo de IA generativa na Pesquisa definido como excluir | Ligações e conteúdo nessas funcionalidades, entrada de fundamentação para elas, tráfego e impressões vindos delas | Treino de IA, o resto da Pesquisa, a classificação, a participação no Merchant Center e no Google Ads |
| Fora do treino e da fundamentação do Gemini, mas dentro da Pesquisa e das Visões gerais criadas por IA | Google-Extended com um Disallow no robots.txt | Uso do conteúdo rastreado para treinar futuros modelos Gemini e para fundamentação nas apps Gemini e no Vertex AI | Inclusão na Pesquisa Google, classificação e o que o controlo da Pesquisa gere |
| Comunicar a todos os rastreadores a sua política num só sítio | Linha Content-Signal em cada grupo do robots.txt | Nada, tecnicamente | Coisa nenhuma. É uma declaração, e as páginas do Google não a mencionam |
| Sem texto de IA de páginas concretas, com a página ainda listada | nosnippet | Snippet de texto e pré-visualização de vídeo em todo o lado, incluindo as Visões gerais criadas por IA e o Modo IA como entrada direta | A listagem da página em si, possivelmente uma miniatura estática; também reduz os snippets normais |
| Fora da Pesquisa Google por completo | noindex | A página nos resultados da Pesquisa Google | Não se aplica, a página sai dos resultados; o rastreador tem de poder obter a página para ver a etiqueta |
Os dois objetivos do início do artigo ficam assim. Fora das Visões gerais criadas por IA mas dentro da Pesquisa: o controlo da Pesquisa, ou nosnippet em páginas isoladas. Fora do treino mas dentro das respostas de IA: Google-Extended para o Google, uma linha Content-Signal para os restantes, e o controlo da Pesquisa deixado em incluir.
O que acontece quando uma subpasta de idioma substitui a propriedade de domínio
É na herança que um site com várias propriedades tem surpresas. A regra do Google:
“Por padrão, uma propriedade herda esse controle da propriedade mãe mais próxima que tenha alterado a própria configuração para interromper heranças.”
Ajuda do Search Console, Controle de uso na IA generativa da Pesquisa
No wppoland.com isto significa que a propriedade de domínio está no topo e cada uma de /pl/, /en/, /de/, /nb/, /pt-pt/ e /es/ é filha. Definida a propriedade de domínio uma vez, as seis seguem-na. Como cada pasta é uma propriedade própria, um idioma pode também ser excluído enquanto os outros cinco ficam incluídos. Para as propriedades filhas, o Google diz o seguinte:
“Os donos de uma propriedade filha podem seguir o controle de uso na IA generativa da Pesquisa definido para a propriedade mãe ou mudar a configuração dessa filha específica e das subpáginas dela.”
Ajuda do Search Console, Controle de uso na IA generativa da Pesquisa
A novidade é a notificação. Barry Schwartz noticiou a 6 de outubro de 2026 que o Google tinha acrescentado uma linha à página de ajuda, e a linha diz:
“Os donos da propriedade de domínio de nível superior verão uma notificação na página do controlo de IA generativa na Pesquisa quando uma das suas propriedades filhas substituir a definição da mãe.”
Ajuda do Search Console (tradução nossa do original em inglês), noticiado no Search Engine Roundtable
Isto é útil aqui, porque é assim que quem é dono da propriedade de domínio ficaria a saber que alguém alterou a definição de uma pasta, sem abrir seis páginas. Não vimos a notificação disparar. Schwartz escreve que também não tem uma captura de ecrã dela, pelo que deve tratar-se como documentada, não como observada.
Exemplo de robots.txt com Content-Signal e Google-Extended
O grupo da estrela e o grupo Google-Extended em public/robots.txt dizem, exatamente:
User-agent: *
Content-Signal: search=yes, ai-input=yes, ai-train=no
Allow: /
Disallow: /cdn-cgi/
# Google-Extended - Gemini grounding + training corpus
User-agent: Google-Extended
Content-Signal: search=yes, ai-input=yes, ai-train=no
Allow: /Duas leituras. Primeiro, o conjunto corresponde ao que queremos: na pesquisa, nas respostas de IA, fora do treino. Significa também que o controlo da Pesquisa e o ficheiro têm de andar a par. Um robots.txt que diz ai-input=yes e uma definição de excluir no Search Console contradir-se-iam.
Segundo, o grupo Google-Extended é a metade mais fraca. O Google documenta esse token através de linhas allow e disallow, e o próprio exemplo usa as duas. O nosso grupo diz Allow: /. Lido à letra contra a página do Google, o token está aberto ao treino e à fundamentação do Gemini no nosso site, e o ai-train=no ao lado é uma declaração que nenhuma das duas páginas do Google aqui citadas menciona. Portanto, para o Google em particular, a nossa preferência quanto ao treino está declarada mas não é suportada por um mecanismo que o Google documente.
Resolver isso é outra decisão. Um Disallow: / nesse grupo abdicaria também do uso para fundamentação nas apps Gemini, porque o token cobre ambos. O comentário no topo do ficheiro chama ainda a qualquer restrição expressa por sinais de conteúdo uma reserva expressa de direitos ao abrigo do artigo 4.º da diretiva europeia de direito de autor 2019/790. Saber se isso se sustenta é pergunta para um jurista, não para quem edita o robots.txt.
Como medir o efeito antes de alterar uma definição
Não temos resultado para apresentar, e a ordem importa. O Google aponta um relatório para isto:
“Para medir a performance do seu conteúdo nos recursos de IA generativa na Pesquisa, use o Relatório de performance da IA generativa. Ele pode ajudar você a ter uma ideia de como a mudança no controle afetaria o tráfego do site.”
Ajuda do Search Console, Controle de uso na IA generativa da Pesquisa
O plano é curto. Registar primeiro o relatório da propriedade de domínio. Alterar uma propriedade e mais nada. Esperar os dias que o Google indica. Comparar com a base. Mudar o controlo da Pesquisa, o Google-Extended e uma implementação de nosnippet na mesma semana deixaria um número que ninguém consegue atribuir. A mesma disciplina vale para o padrão de zero cliques tratado no nosso artigo sobre as Visões gerais criadas por IA alargadas.
Atualização, . Os primeiros dados públicos de uma exclusão que vi contrariam o receio habitual. Cyrus Shepard publicou no LinkedIn aquilo a que chama um estudo de caso reconhecidamente pequeno: um único site retirado das funcionalidades de IA do Google. A publicação não diz que mecanismo usou; a Barry Schwartz descreveu-o como os controlos de exclusão da IA generativa na Pesquisa (Search Engine Roundtable). As impressões em IA caíram para zero. Estima que essas impressões tinham uma taxa de cliques de cerca de 0,9%, calculada a partir da taxa de cliques e das impressões totais do site, descontadas as impressões de IA conhecidas no período do teste, e disse a Schwartz que representavam cerca de 8% de todas as impressões. A surpresa: os cliques orgânicos normais também desceram enquanto as funcionalidades de IA estiveram desligadas. Shepard interpreta isto como um efeito de halo, em que estar visível em mais pontos da página de resultados torna o clique mais provável, e acrescenta que os resultados não são garantidos e que cada um deve testar os próprios dados. As limitações são dele e acompanham os números: um site, sem datas nem duração do teste na publicação, e as Visões gerais criadas por IA continuaram a aparecer nessas pesquisas durante todo o tempo, apenas sem o site dele.
O que isto significa para um site em WordPress: um site não prova um efeito de halo, mas desfaz a ideia de que excluir as funcionalidades de IA só pode proteger cliques. Num site multilingue, as regras de herança descritas acima permitem um teste aproximado: excluir uma propriedade de idioma, deixar as restantes em incluir e comparar cada uma com a sua própria base. Aproximado, porque cada idioma serve um mercado diferente, e as pesquisas em Portugal não se comportam como as do Brasil ou da Alemanha. Um site num só idioma não tem esta divisão, pelo que a decisão vale logo para todo o site.
O Bing tem controlos próprios para o treino de IA e para as respostas de IA
Atualização, . Tem, desde hoje. Krishna Madhavan, da Microsoft Bing, anunciou preferências que separam o treino de IA da fundamentação (grounding), ou seja, do uso de uma página para construir uma resposta gerada (blogue do Bing, Your content, your choice). Segundo a Microsoft, nenhuma das preferências altera a elegibilidade para os resultados normais da pesquisa do Bing.
O treino de IA define-se no robots.txt, para todo o site ou para um caminho, através de um token de user-agent próprio. A predefinição é permitir, por isso quem quer continuar incluído não precisa de mudar nada. Para sair:
User-Agent: __usage_ai-training
Disallow: /
Por página, uma meta tag ou um cabeçalho HTTP prevalece sobre o robots.txt nessa página:
<meta name="Bingbot" content="ai-training:disallow">
X-Robots-Tag: Bingbot: ai-training:disallow
A fundamentação só existe por página, sem forma no robots.txt. Tem três valores: permitir (predefinição), ai-grounding:disallow, que deixa a página fora das respostas geradas, e ai-grounding:disallowextended, que limita a fundamentação a serviços operados pela própria Microsoft, entre eles o Copilot e o Microsoft 365, e exclui os serviços de fundamentação que a Microsoft fornece a terceiros, como o Web IQ e a fundamentação da Foundry API. Ambos vão na mesma meta tag Bingbot ou no cabeçalho X-Robots-Tag.
As datas pesam mais do que a sintaxe. As novas preferências substituem as diretivas antigas NoArchive e NoCache. A partir de 15 de dezembro de 2026, o Bing Webmaster Tools disponibiliza preferências temporárias de fundamentação aos sites que usem NoArchive ou NoCache nessa data. A partir de 1 de fevereiro de 2027, o Bing passa a respeitar as novas preferências à medida que rastreia. 1 de março de 2027 é o prazo para publicar preferências de fundamentação nas páginas ou registar as temporárias; as páginas sem nenhuma delas ficam com permissão de fundamentação até serem rastreadas de novo, e o NoArchive e o NoCache deixam de contar para treino ou fundamentação. As preferências temporárias expiram a 30 de setembro de 2027, ou antes, se um novo rastreio encontrar a nova tag.
| Objetivo | Bing | |
|---|---|---|
| Fora do treino de IA, todo o site | Google-Extended com Disallow no robots.txt, que também retira a fundamentação nas Gemini Apps e no Vertex AI | __usage_ai-training com Disallow no robots.txt, só treino |
| Fora das respostas de IA na pesquisa | Controlo de IA generativa na Pesquisa por propriedade do Search Console, ou nosnippet por página | ai-grounding:disallow por página, meta tag ou cabeçalho |
| Fora apenas da fundamentação para terceiros | Sem equivalente | ai-grounding:disallowextended por página |
| Resultado normal na pesquisa | Não afetado pelo controlo da Pesquisa nem pelo Google-Extended | Não afetado por nenhuma das preferências |
A diferença útil: o Google junta treino e fundamentação do Gemini num só token, o Bing separa-os. A combinação que o nosso robots.txt declara (nas respostas, fora do treino) exprime-se ao Bing com um único grupo; no Google custa também a fundamentação do Gemini. Em contrapartida, o interruptor de fundamentação do Bing funciona por página e o principal interruptor do Google por propriedade.
O que o proprietário de um site em WordPress deve decidir agora:
- Verificar se as páginas enviam
noarchiveounocache. Alguns plugins de SEO, como o Rank Math, oferecem o noarchive como opção avançada de meta robots. Se o usou para limitar o uso de IA pelo Bing, deixa de funcionar a 1 de março de 2027, a menos que o substitua. - Treino: acrescentar o grupo
__usage_ai-trainingao robots.txt. O WordPress serve um robots.txt virtual; edita-se no editor de robots.txt do plugin de SEO (o Yoast e o Rank Math têm um) ou com o filtrorobots_txt. Um ficheiro robots.txt físico na raiz substitui por completo o virtual. - Fundamentação: o Bing lê
<meta name="Bingbot">, nãoname="robots", pelo que o filtrowp_robotsdo núcleo não o imprime. Pode ser emitido a partir de um hookwp_headnum pequeno plugin, ou o cabeçalho pode ser enviado pelo servidor. Quem quer ser citado no Copilot não faz nada: permitir é a predefinição. - Com os números de Shepard, decidir o bloqueio da fundamentação secção a secção, por exemplo apenas para conteúdo pago.
No robots.txt do wppoland.com já acrescentei o grupo de treino do Bing, em linha com o sinal ai-train=no. Definir estas preferências por modelo num site em WordPress faz parte do meu trabalho de otimização GEO e LLMO.
Lista de verificação
- Decidir primeiro o objetivo: fora das funcionalidades da Pesquisa, fora do treino, ou ambos.
- Escolher o interruptor na tabela. Um objetivo, um interruptor.
- Definir o controlo da Pesquisa na propriedade de domínio e depois verificar cada propriedade de idioma quanto a substituições.
- Manter o robots.txt e o Search Console coerentes:
ai-input=yese uma propriedade excluída contradizem-se. - Não combinar um
Disallowno robots.txt comnoindexounosnippetna mesma página. - Usar o Google-Extended apenas se aceitar que também cobre a fundamentação do Gemini.
- Registar a base do relatório de desempenho da IA generativa antes da alteração e mudar uma coisa de cada vez.
- Se o site limita o Bing com
noarchiveounocache, substituí-los pelas novas preferências do Bing antes de 1 de março de 2027.