A Google Search Console é a ferramenta gratuita mais poderosa que a Google dá aos donos de sites, e mesmo assim a maioria trata-a como um painel só de leitura. Uma olhadela às impressões, talvez algumas pesquisas, e fecha o separador. Em 2026, essa postura deixa muito tráfego orgânico por aproveitar.
Em 2012, para adicionar um site ao Google, preenchia um formulário add-url.html. Hoje o verdadeiro poder da GSC está mais fundo: a inspeção de URLs, o relatório de indexação de páginas e as APIs que permitem submeter sitemaps, inspecionar URLs e extrair dados de desempenho em código. Na wppoland.com, todo o processo de publicação informa a Search Console e o IndexNow depois de cada deploy. Este guia percorre cada camada desse stack, da configuração à automatização em CI/CD, e mostra onde a documentação da Google traça o limite daquilo para que serve a Indexing API.
O que a Google Search Console e a sua API fazem
A maioria dos donos de sites abre a Search Console uma vez por semana, olha para o gráfico de desempenho e sai. É como comprar um canivete suíço e usar apenas o abre-garrafas.
A GSC dá sinais diretos da Google sobre a forma como o seu site é visto. A ferramenta de inspeção de URLs mostra o que o Googlebot vê ao renderizar a página, incluindo se o JavaScript bloqueia conteúdo importante. O relatório de indexação de páginas (antes Cobertura) mostra quantas páginas a Google indexou e, sobretudo, o motivo de cada URL que não indexou. A secção Core Web Vitals mostra dados de desempenho de utilizadores reais.
A API da Search Console vai mais longe: extrai dados de desempenho em código, alimenta painéis próprios e automatiza a monitorização. Juntando a submissão de sitemaps por API e, para ofertas de emprego e transmissões em direto, a Indexing API, deixa de esperar que a Google encontre o seu conteúdo e passa a dizer-lhe o que mudou. Para agências com dezenas de sites WordPress, é essa monitorização que apanha um template partido ou um noindex perdido antes de custar semanas de tráfego.
Como configurar a Google Search Console para WordPress
Antes de mexer em ferramentas avançadas, configure a propriedade como a Google espera. Há dois tipos de propriedade: Domínio e Prefixo do URL.
As propriedades de domínio cobrem todos os subdomínios e protocolos (http, https, www, sem www) debaixo do mesmo chapéu. É a opção recomendada para a maioria dos sites. Exige verificação por DNS, ou seja, um registo TXT na configuração DNS do domínio. Em sites WordPress com alojamento gerido, isto costuma levar menos de cinco minutos no painel do alojamento.
As propriedades de prefixo do URL são úteis quando quer acompanhar um subdiretório específico (como example.com/blog/) ou não tem acesso ao DNS. A verificação faz-se com ficheiro HTML, meta tag, Google Analytics ou Google Tag Manager.
Depois da verificação, siga estes passos:
- Associe o GA4: nas definições, associe a sua propriedade do Google Analytics 4. Assim vê dados da GSC dentro dos relatórios do GA4 e melhora a atribuição.
- Defina permissões: adicione a equipa com o nível certo. Utilizadores “Total” veem todos os dados e podem agir, utilizadores “Restrito” só podem ver. Em agências, delegue “Proprietário” com cuidado, porque permite remover outros utilizadores.
- Submeta o sitemap principal: em Sitemaps, introduza o URL do seu sitemap XML. Em WordPress com Yoast ou RankMath costuma ser
https://seudominio.pt/sitemap_index.xml. - Verifique a segmentação internacional: num site multilingue, verifique o
hreflangcom um crawler e confirme amostras na inspeção de URLs. A Google retirou o relatório de segmentação internacional em 2022, por isso a Search Console já não lista erros de hreflang.
Se alguém na equipa está a começar na Search Console, a Google Search Central publicou a 6 de outubro de 2026 duas playlists no YouTube, apresentadas por Daniel Waisberg. Search fundamentals for beginners (fundamentos para principiantes) cobre rastreio, indexação, apresentação de resultados e o relatório de desempenho. Technical SEO fundamentals (SEO técnico) trata do robots.txt, do orçamento de rastreio, da ferramenta de inspeção de URLs e das exportações de dados em massa e APIs da Search Console, que é a base do resto deste guia.
Porque é que a Google Search Console exclui páginas
No relatório de indexação de páginas vê se a Google está mesmo a indexar as páginas que lhe interessam. O relatório divide cada URL que a Google conhece em Indexadas e Não indexadas, com um motivo para cada grupo não indexado. A página de ajuda da Google sublinha que “não indexada” não é necessariamente mau: redirecionamentos, páginas alternativas e páginas com noindex intencional pertencem ali.
Perceber os motivos de exclusão
Os motivos mais frequentes, primeiro a definição da Google e depois a nossa leitura:
Detetada - atualmente não indexada: a Google conhece o URL (normalmente por um sitemap ou link interno) mas ainda não o rastreou. Segundo a documentação da Google, o habitual é ter querido rastreá-lo mas prever uma sobrecarga do site, por isso reagendou o rastreio, e é por isso que a data do último rastreio aparece vazia. Em sites com milhares de URLs finos ou quase duplicados este estado acumula-se, por isso reforce os links internos para as páginas importantes e remova os URLs que nunca deviam ter existido: páginas 90% iguais a outra ou “páginas órfãs” sem um único link.
Rastreada - atualmente não indexada: a Google descarregou a página mas não a acrescentou ao índice. A Google diz que “pode ou não ser indexada no futuro” e que não é preciso voltar a submetê-la (tradução própria). Como a Google viu de facto o conteúdo, a nossa primeira verificação é a originalidade e a profundidade: páginas finas e duplicados de outras páginas do mesmo site são o padrão que mais encontramos.
Soft 404: a página devolve o código 200 mas a Google acha que se comporta como um 404. Acontece com categorias vazias, páginas de pesquisa sem resultados ou páginas com muito pouco conteúdo próprio. Acrescente conteúdo útil, devolva um 404 verdadeiro ou use noindex.
Bloqueada pelo robots.txt: o seu robots.txt impede o Googlebot de rastrear o URL. Confirme se é intencional. Em WordPress, os culpados habituais são bloquear /wp-admin/admin-ajax.php (o que parte o conteúdo carregado por AJAX) ou regras Disallow demasiado largas.
Página alternativa com etiqueta canónica adequada: a página aponta a canónica para outro URL. A ajuda da Google diz que a canónica está indexada e não há nada a fazer. Aparece em URLs com parâmetros e em alternativas móveis ou AMP.
Como usar a ferramenta de inspeção de URLs
Para qualquer URL, a ferramenta de inspeção de URLs mostra a versão indexada: a canónica escolhida pela Google, o sitemap que a refere e a data do último rastreio. Não é um teste em direto, é a versão que a Google guardou da última vez. Com “Testar URL publicado” vê o que a Google renderiza agora, e é assim que se depuram temas WordPress pesados em JavaScript. A mesma página de ajuda aponta dois limites: o teste em direto não consegue prever que canónica a Google vai escolher, e “O URL está no Google” quer dizer que pode aparecer, não que vá aparecer.
“Pedir indexação” na mesma ferramenta é a via oficial para meia dúzia de páginas normais. O guia da Google para pedir novo rastreio diz que precisa de ser proprietário ou utilizador com permissão total, que há uma quota para URLs individuais e que pedir várias vezes o rastreio do mesmo URL não o acelera. Diz também que o rastreio pode demorar “desde alguns dias até algumas semanas” (tradução própria).
Como usar o relatório de desempenho da Search Console
O relatório de desempenho tem quatro métricas base: impressões, cliques, CTR médio e posição média. O valor está em filtrar e cruzar estas dimensões.
Encontrar palavras-chave nas posições 5 a 20
Filtre as pesquisas por uma posição média entre 5 e 20. São termos em que já é visível mas ainda não capta muitos cliques. Ordene por impressões para encontrar as oportunidades com mais volume. Para cada uma:
- Veja que página a Google associa à pesquisa (filtro Páginas).
- Avalie se o título e a meta descrição correspondem a essa pesquisa concreta.
- Verifique a profundidade do conteúdo. Uma posição entre 8 e 15 indica muitas vezes que a Google considera o conteúdo relevante, mas não suficientemente completo.
- Acrescente os subtemas em falta, atualize informação desatualizada e melhore os links internos a partir de páginas tematicamente próximas.
Análise por dispositivo e país
Filtre por Dispositivo para encontrar páginas que se posicionam bem no computador e mal no telemóvel, ou o contrário. Isso aponta muitas vezes para problemas de renderização ou de UX numa plataforma. Filtre por País para descobrir tráfego internacional inesperado que pode aproveitar com conteúdo dirigido ou com hreflang.
Desde outubro de 2026, o filtro País do relatório de desempenho aceita vários países em simultâneo. A Google anunciou a mudança no LinkedIn e Barry Schwartz noticiou-a a 6 de outubro:
«Se opera em vários países, pode agora ver o tráfego combinado desses países na Pesquisa Google.»
Google no LinkedIn, citado por Barry Schwartz na Search Engine Roundtable, 6 de outubro de 2026, tradução própria
Na prática: selecione Portugal e os outros mercados para onde vende, e cliques e impressões aparecem numa só linha, sem somar exportações numa folha de cálculo. Depois compare esse total com Portugal sozinho. Se os outros mercados mal mexem na linha, uma versão local própria ainda não compensa a manutenção.
Comparar períodos antes e depois de uma alteração
Use a função Comparar para medir o antes e o depois. Depois de uma migração, de uma atualização de conteúdo ou de uma correção técnica, compare as duas semanas anteriores com as duas seguintes para quantificar o efeito. Exporte estes dados pela API para relatórios que os responsáveis leiam de facto.
A Google Indexing API
A Indexing API permite avisar a Google de que uma página foi adicionada, atualizada ou removida. O seu âmbito é estreito. O guia de início da Google diz que “só pode ser usada para rastrear páginas com JobPosting ou com BroadcastEvent incorporado num VideoObject” (tradução própria), ou seja, ofertas de emprego e vídeos em direto. A mesma página indica que todas as submissões passam por uma deteção de spam rigorosa e que tentativas de abuso podem levar à revogação do acesso. Plugins que enviam cada artigo do blog por esta API trabalham fora dessa documentação, e em sites de clientes não o fazemos. Para páginas normais, use sitemaps e a ferramenta de inspeção de URLs.
Quota e limites
A página de quotas fixa valores por defeito por projeto do Google Cloud, não por propriedade da Search Console:
| Quota | Valor por defeito |
|---|---|
Pedidos de publicação por dia (URL_UPDATED e URL_DELETED em conjunto) | 200 |
Pedidos getMetadata por minuto | 180 |
| Pedidos por minuto em todos os endpoints | 380 |
URL_UPDATED avisa de um URL novo ou alterado, URL_DELETED de uma página removida. A Google descreve os 200 como valor por defeito para integração e testes: o uso em produção precisa de aprovação adicional através de um formulário, e a quota pode subir ou descer consoante a qualidade dos documentos. Pode agrupar pedidos e consultar o estado das notificações já enviadas.
Configurar a autenticação
- Crie um projeto no Google Cloud em console.cloud.google.com.
- Ative a Indexing API na biblioteca de APIs.
- Crie uma conta de serviço em IAM e administração e descarregue o ficheiro de chave JSON.
- Adicione o email da conta de serviço como proprietário delegado da sua propriedade na Search Console. Os pré-requisitos da Google descrevem o caminho: abra a propriedade, clique em “Adicionar proprietário” na lista de proprietários validados e cole o endereço do campo
client_emailda chave JSON (tem a forma[email protected]).
Implementação em WordPress com PHP
Não escreva o pedido cURL por conta própria. Use uma biblioteca como googleapis/google-api-php-client:
// Exemplo: notificar a Google de uma oferta de emprego atualizada
$client = new Google_Client();
$client->setAuthConfig('service_account.json');
$client->addScope(Google_Service_Indexing::INDEXING);

$service = new Google_Service_Indexing($client);
$postBody = new Google_Service_Indexing_UrlNotification();
$postBody->setUrl('https://seudominio.pt/emprego/programador-frontend/');
$postBody->setType('URL_UPDATED');

$service->urlNotifications->publish($postBody);Implementação em Node.js
Uma implementação mínima para avisar a Google do URL de uma oferta de emprego:
const { google } = require('googleapis');

const auth = new google.auth.GoogleAuth({
  credentials: JSON.parse(process.env.GOOGLE_INDEXING_CREDENTIALS),
  scopes: ['https://www.googleapis.com/auth/indexing'],
});

const indexing = google.indexing({ version: 'v3', auth });

async function submitUrl(url) {
  const res = await indexing.urlNotifications.publish({
    requestBody: { url, type: 'URL_UPDATED' },
  });
  console.log(`Submitted: ${url} - ${res.data.urlNotificationMetadata.latestUpdate.type}`);
}
Guarde as credenciais da conta de serviço numa variável de ambiente (GOOGLE_INDEXING_CREDENTIALS) com o conteúdo do ficheiro JSON. Nunca faça commit de credenciais no controlo de versões.
Envio em lote com limite de ritmo
Se enviar vários URLs, respeite a quota diária e faça pausas entre pedidos:
const DAILY_QUOTA = 200;
const DELAY_BETWEEN_REQUESTS_MS = 1000;

async function submitBatch(urls) {
  const batch = urls.slice(0, DAILY_QUOTA);
  for (const url of batch) {
    try {
      await submitUrl(url);
      await new Promise(resolve => setTimeout(resolve, DELAY_BETWEEN_REQUESTS_MS));
    } catch (error) {
      console.error(`Failed to submit ${url}: ${error.message}`);
    }
  }
  console.log(`Submitted ${batch.length} of ${urls.length} URLs`);
}IndexNow e Google Indexing API comparados
A Google Indexing API dirige-se apenas à Google. O IndexNow é um protocolo aberto que avisa vários motores de busca ao mesmo tempo. A lista de participantes publicada em indexnow.org inclui Bing, Yandex, Seznam, Naver, Yep, o Internet Archive e o Amazonbot. A Google não está nessa lista.
O IndexNow funciona com um simples pedido HTTP POST ou GET para o endpoint do IndexNow com a chave de API do seu site. A chave é um ficheiro de texto na raiz do domínio que prova a propriedade.
curl "https://api.indexnow.org/indexnow?url=https://wppoland.com/pt-pt/novo-artigo/&key=A_SUA_CHAVE_API"Para lotes, a documentação do IndexNow aceita até 10 000 URLs por POST. Uma resposta 200 só significa que o motor recebeu a lista, não que a vá rastrear:
const axios = require('axios');

async function submitIndexNow(urls, apiKey, host) {
  const response = await axios.post('https://api.indexnow.org/indexnow', {
    host,
    key: apiKey,
    keyLocation: `https://${host}/${apiKey}.txt`,
    urlList: urls,
  });
  console.log(`IndexNow response: ${response.status}`);
}
O IndexNow não se limita a ofertas de emprego, por isso é o canal de envio para conteúdo normal nos motores que o suportam. A Google continua a encontrar essas páginas pelo seu sitemap.
Submeter sitemaps com a API da Search Console
Além da Indexing API, a API da Search Console gere sitemaps em código. É útil em sites com vários ficheiros de sitemap ou com sitemaps gerados dinamicamente.
Submeter sitemaps em código
Os métodos de sitemaps precisam de um cliente autorizado com o scope https://www.googleapis.com/auth/webmasters, não o de indexação da secção anterior, e a conta de serviço tem de ter acesso à propriedade.
const { google } = require('googleapis');

const auth = new google.auth.GoogleAuth({
  credentials: JSON.parse(process.env.GOOGLE_SC_CREDENTIALS),
  scopes: ['https://www.googleapis.com/auth/webmasters'],
});
const searchconsole = google.searchconsole({ version: 'v1', auth });

async function submitSitemap(siteUrl, sitemapUrl) {
  await searchconsole.sitemaps.submit({
    siteUrl,
    feedpath: sitemapUrl,
  });
  console.log(`Sitemap submitted: ${sitemapUrl}`);
}Monitorizar o estado dos sitemaps
Consulte o endpoint de lista para ver erros, avisos, o número de URLs submetidos e quando a Google descarregou cada ficheiro pela última vez. A documentação do recurso sitemaps marca contents[].indexed como obsoleto e a não usar, por isso tire os números de páginas indexadas do relatório de indexação de páginas:
async function checkSitemaps(siteUrl) {
  const res = await searchconsole.sitemaps.list({ siteUrl });
  for (const sitemap of res.data.sitemap || []) {
    const submitted = (sitemap.contents || []).reduce((n, c) => n + Number(c.submitted || 0), 0);
    console.log(`${sitemap.path}: ${submitted} submitted, last downloaded ${sitemap.lastDownloaded}`);
    if (Number(sitemap.errors) > 0 || Number(sitemap.warnings) > 0) {
      console.warn(`  Errors: ${sitemap.errors}, warnings: ${sitemap.warnings}`);
    }
  }
}
lastDownloaded é o campo que vale a pena vigiar com um alerta: foi assim que apanhámos a descarga atrasada descrita mais abaixo.
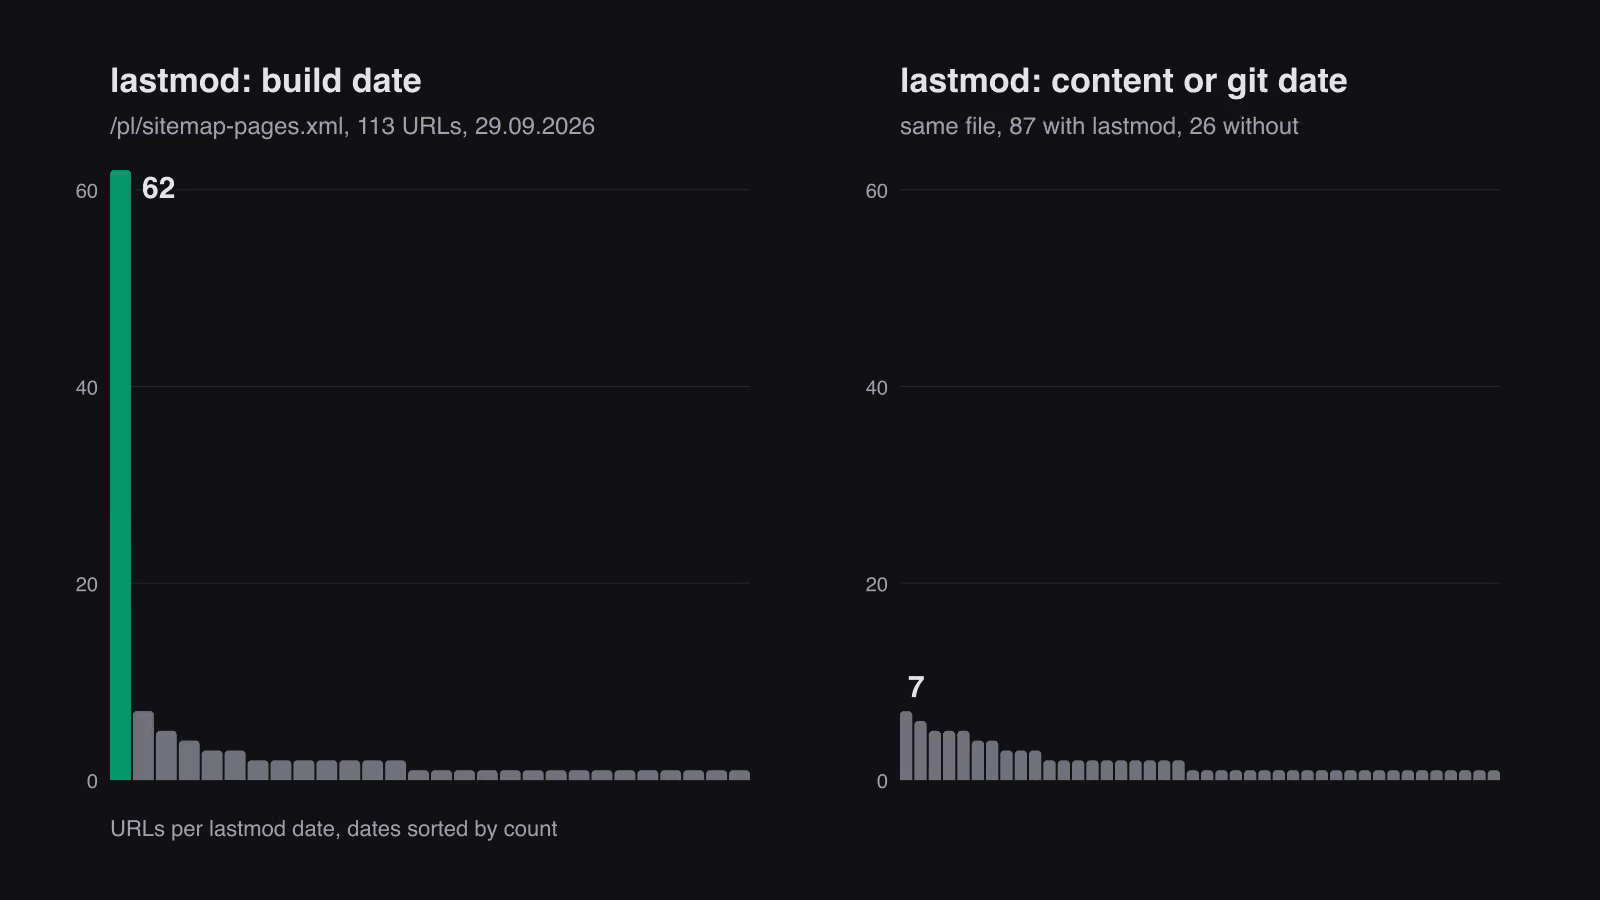
Não confie no antigo endpoint de ping. A Google anunciou a sua descontinuação a 26 de junho de 2023: deixou de funcionar seis meses depois e os pedidos devolvem 404. Os sitemaps declaram-se com a linha Sitemap: no robots.txt ou submetem-se pela Search Console. A mesma publicação diz que a Google só usa o lastmod para agendar rastreios quando este corresponde de forma consistente à realidade.
Automatizar a indexação na Google num pipeline de CI/CD
Em sites estáticos feitos com Astro, Next.js ou frameworks semelhantes (como o stack da wppoland.com), integrar os avisos no pipeline de build garante que cada deploy envia as notificações certas.
Exemplo de hook pós-build
Um script pós-build lê o sitemap gerado, identifica URLs novos ou alterados e envia-os para o IndexNow. Só os URLs de ofertas de emprego e transmissões em direto seguem para a Google Indexing API:
const { readFileSync } = require('fs');
const { XMLParser } = require('fast-xml-parser');

async function postBuildIndex(sitemapPath) {
  const xml = readFileSync(sitemapPath, 'utf-8');
  const parser = new XMLParser();
  const sitemap = parser.parse(xml);

  const urls = sitemap.urlset.url
    .filter(entry => {
      const lastmod = new Date(entry.lastmod);
      const oneDayAgo = new Date(Date.now() - 86400000);
      return lastmod > oneDayAgo;
    })
    .map(entry => entry.loc);

  console.log(`Found ${urls.length} recently modified URLs`);
  await submitIndexNow(urls, process.env.INDEXNOW_KEY, 'wppoland.com');  // IndexNow
  const jobUrls = urls.filter(u => u.includes('/emprego/'));  // apenas páginas JobPosting
  await submitBatch(jobUrls);  // Google Indexing API
}Integração em CI/CD
No GitHub Actions ou no GitLab CI, acrescente um passo depois do deploy:
- name: Notify search engines
  env:
    GOOGLE_INDEXING_CREDENTIALS: ${{ secrets.GOOGLE_INDEXING_CREDENTIALS }}
    INDEXNOW_KEY: ${{ secrets.INDEXNOW_KEY }}
run: node scripts/post-build-index.jsComo distribuir a quota
Com 200 pedidos de publicação por dia, por defeito, para todo o projeto do Cloud, um portal de emprego tem de definir prioridades:
- Ofertas novas primeiro: uma oferta que a Google nunca viu passa à frente.
- Ofertas expiradas a seguir: envie
URL_DELETEDquando a vaga é preenchida, para que saia dos resultados em vez de levar candidatos a uma página morta. - Ignore conteúdo sem alterações: compare datas
lastmodou hashes do conteúdo para não gastar quota em páginas que não mudaram. - Passe o excedente para o dia seguinte: se um deploy ultrapassar a quota, guarde os URLs restantes e processe-os no dia seguinte com uma tarefa agendada.
Quanto tempo demoram de facto o rastreio, a indexação e a apresentação
Muitos casos de “porque é que ainda não está indexado” não são um erro, são uma questão de relógio. Gary Illyes mostrou no Search Central Live em Barcelona os tempos internos da Google, e a Search Engine Roundtable publicou a tabela a 5 de outubro de 2026. Cada linha tem um tempo típico e um tempo máximo:
| Processo | Típico | Mais lento |
|---|---|---|
| Descoberta de um URL novo | ~20 horas | Semanas a nunca |
| Atualização de um URL conhecido | ~30 dias | Semanas a nunca |
| Processamento do sitemap | ~24 horas | Até 14 dias, ou nunca (qualidade) |
| Renderização | Segundos a renderizar, horas na fila | Dias a semanas |
| Indexação de ponta a ponta | ~1,5 horas | Meses ou nunca (qualidade) |
| Mudança de canonicalização | 1-3 semanas | Meses (sinais em conflito) |
| Dados estruturados | Horas a 1-2 semanas | Semanas ou nunca (qualidade) |
| Remoção na Search Console (proprietário) | ~2 horas | 24 horas |
| Atualização do título | 1-2 dias | Várias semanas a meses |
| Levantamento de uma ação manual | 1-2 semanas | 4-6 semanas, ou muito mais em sites inativos |
| Recuperação após core update | 3-6 meses | 6 meses a 1 ano (próximo core update) |
| Efeito de um spam update | 1-2 semanas (contínuo) | Meses (atualizações em lote) |
A fonte avisa que os processos estão ligados: uma página não é indexada antes de ser rastreada, e os atrasos somam-se. E o próprio Gary disse:
“tenham em conta que isto foi um exercício para ver se o público se identificava com os números que recolhemos internamente e pusemos nesses diapositivos.”
Gary Illyes, Google, Search Engine Roundtable, tradução própria
São ordens de grandeza, não um SLA.
Vale a pena anotar mais um limite ao lado. A página de limites da API da Search Console dá à API de inspeção de URLs 2000 consultas por dia e 600 por minuto por site, por isso um site com 6000 URLs precisa de três dias para os inspecionar todos uma vez.
Exemplos reais de atrasos de indexação na Search Console
- Um sitemap por atualizar escondeu 2034 URLs. A GSC descarregou pela última vez os nossos seis sitemaps de localizações a 1 de setembro às 10:08, quando tinham 2037 URLs. O corpus cresceu para 4071 e a Google não voltou a descarregá-los durante cinco dias, embora lesse os sitemaps do blog todos os dias. Ao voltar a submetê-los pela API a 6 de setembro, a descarga aconteceu no mesmo dia. As páginas com impressões passaram de 223 para 343 e as impressões de 1570 para 4382, mas houve 2 cliques em 7 dias. A descoberta mexeu, a conversão não.
- Um veredicto é uma fotografia. A 17 de setembro, 3609 de 6747 URLs do sitemap (53,5%) não tinham uma única impressão em 90 dias. Em 19 URLs inspecionados, 6 apareciam como “Excluded by noindex” enquanto a página publicada servia
index, follow. A 27 de setembro, 3 de 20 continuavam assim, com o último rastreio entre 7 de maio e 20 de agosto. Onoindexjá tinha desaparecido, a Google simplesmente ainda não tinha voltado. - IndexNow com URLs adivinhados gasta a quota. O nosso script construiu 2328 URLs a partir de nomes de ficheiros, nenhum estava no sitemap e todos responderam 301. Construa a lista a partir do sitemap, não do sistema de ficheiros.
Antes de declarar uma página fraca, compare a data do veredicto com a data da sua última alteração. Se o veredicto for mais antigo, está a medir o passado.
Porque é que as páginas não são indexadas depois de submetidas
Se as páginas continuam fora do índice depois de submeter um sitemap ou pedir indexação, verifique estes cinco problemas antes de olhar para a qualidade do conteúdo.
robots.txt a bloquear recursos essenciais
Um erro comum em WordPress é bloquear ficheiros CSS ou JavaScript de que o Googlebot precisa para renderizar a página. Use “Testar URL publicado” para ver o que o Googlebot renderiza. Se a página parecer partida, verifique se o robots.txt bloqueia recursos necessários. Deve permitir sempre:
User-agent: Googlebot
Allow: /wp-content/themes/
Allow: /wp-content/plugins/
Allow: /wp-includes/
Bloqueie também os bots de IA que gastam orçamento de rastreio sem enviar tráfego:
User-agent: GPTBot
Disallow: /

User-agent: CCBot
Disallow: /Conflitos de canónica
Se a página tiver um <link rel="canonical"> a apontar para outro URL, a Google indexa o destino. Isto acontece muitas vezes com a barra final, conflitos HTTP/HTTPS ou www contra sem www. Confirme que as definições do WordPress, a CDN e o servidor usam o mesmo formato canónico. No Yoast ou no RankMath, verifique que a canónica não é substituída página a página.
Etiquetas e cabeçalhos noindex
Procure <meta name="robots" content="noindex"> no código-fonte. Em WordPress isto pode estar definido por página (através de plugins de SEO), por categoria ou globalmente em Definições > Leitura > “Desencorajar os motores de pesquisa de indexar este site”. Verifique também os cabeçalhos HTTP à procura de X-Robots-Tag: noindex, que alguns plugins de segurança ou configurações de CDN acrescentam sem aviso.
Problemas de renderização com JavaScript
Se o seu tema WordPress carrega conteúdo com JavaScript (temas baseados em React, paginação AJAX), o Googlebot pode não ver tudo. A ferramenta de inspeção mostra o HTML renderizado. Compare-o com o HTML de origem para perceber o que só é carregado no cliente. A solução definitiva é a renderização no servidor ou a pré-renderização.
Falhas na indexação mobile-first
A Google usa a versão móvel da página para indexar e posicionar. Se a versão móvel esconde conteúdo, usa outro markup ou carrega dados estruturados diferentes do computador, é a versão móvel que é indexada. A ferramenta de inspeção mostra em Disponibilidade da página > Rastreio > Rastreada como qual o rastreador que descarregou a página. Confirme que indica smartphone e procure conteúdo em falta no HTML renderizado. Mantenha o mesmo conteúdo no telemóvel e no computador.
Como criar um sitemap de imagens para AVIF e WebP
O Yoast e o RankMath acrescentam as imagens automaticamente, mas um stack próprio ou headless tem de o fazer sozinho. A documentação da Google sobre sitemaps de imagens descreve estas tags como uma forma de indicar à Google imagens que de outro modo talvez não encontrasse, como as que o seu site carrega com JavaScript. Um <img> normal em HTML renderizado no servidor é encontrado sem elas.
<url>
  <loc>https://wppoland.com/pt-pt/o-meu-artigo/</loc>
  <image:image>
    <image:loc>https://wppoland.com/images/o-meu-artigo.avif</image:loc>
  </image:image>
</url>
Cada <url> aceita até 1000 tags <image:image>. A Google retirou da documentação <image:caption>, <image:title>, <image:geo_location> e <image:license>, por isso os geradores que ainda as emitem desperdiçam bytes. Imagens num domínio de CDN não são problema, desde que esse domínio também esteja verificado na Search Console e o robots.txt não o bloqueie.
Como pôr uma página nova no índice, passo a passo
Este é o fluxo que usamos na wppoland.com para cada conteúdo que publicamos ou atualizamos:
- Publique ou atualize a página no WordPress ou no seu CMS. Dados estruturados, meta tags e links internos ficam prontos antes de a página ir para o ar.
- O sitemap atualiza-se sozinho: o sitemap XML é regenerado (o Yoast, o RankMath ou o seu gerador estático tratam disso). Confirme que o
lastmodreflete a data real. - IndexNow: o script pós-build ou o hook de publicação envia o URL para o IndexNow e avisa o Bing, o Yandex e os restantes participantes.
- Google Indexing API, só emprego e diretos: para uma página com
JobPostingou umBroadcastEventdentro de umVideoObject, o mesmo script enviaURL_UPDATED. As páginas normais saltam este passo. - Sitemap pela API: se o próprio ficheiro de sitemap mudou, volte a submetê-lo com
sitemaps.submite verifique olastDownloadedno dia seguinte. Para meia dúzia de páginas normais importantes, use “Pedir indexação” na ferramenta de inspeção. - Monitorize na GSC: confirme com a ferramenta de inspeção, ou com a API de inspeção dentro do limite de 2000 por dia, que a página foi rastreada e indexada. A própria Google fala em dias a semanas para o rastreio.
- Itere: se a página continuar sem indexação, leia o motivo no relatório de indexação de páginas, corrija a causa e só depois peça um novo rastreio.
Este fluxo mantém cada alteração visível para a Google sem forçar uma API fora do âmbito documentado. Seja um portal de emprego, uma loja com produtos sazonais ou uma agência com sites de clientes, a ordem é a mesma: sitemaps corretos primeiro, canais de envio onde são permitidos e dados da Search Console para confirmar o resultado.
Veja os nossos serviços de SEO e GEO.