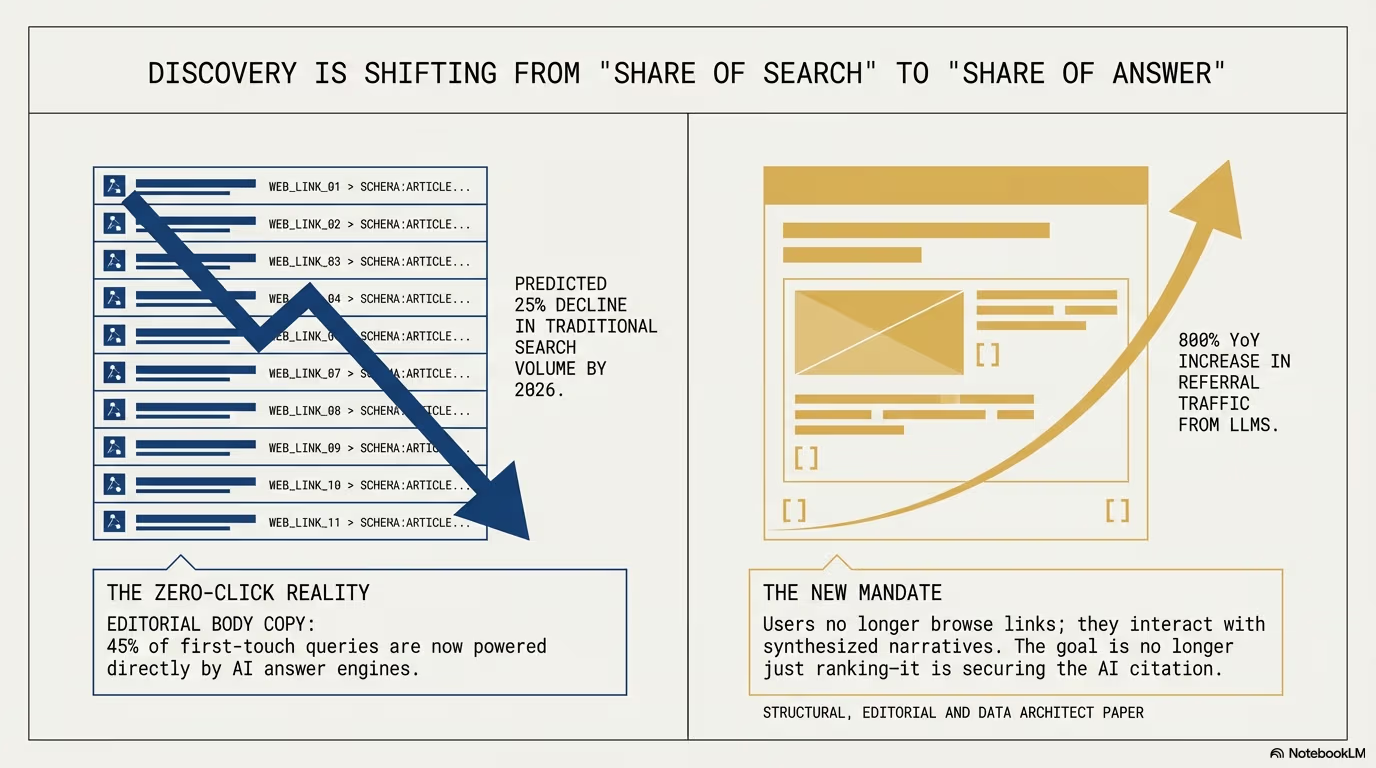
A Gartner projetou uma queda de 25% no volume de pesquisa tradicional até 2026, e um editor que leia essa frase como um problema de posicionamento está a ler a coluna errada da sua própria folha de cálculo. A queda não atinge o ranking, atinge a sessão. Uma página pode continuar a ser recuperada, lida e usada para compor uma resposta sem gerar um único pedido de HTML ao servidor do editor que a escreveu, e sem gerar a impressão publicitária, o evento de analytics ou o formulário preenchido que pagavam a sua produção. Este artigo percorre sete mecanismos concretos da descoberta por IA, e em cada um pergunta a mesma coisa: o que acontece ao tráfego e a quem paga a conta quando a resposta deixa de exigir um clique.
A transição de SEO para GEO

O clique era a unidade de faturação da web aberta. Não era apenas uma métrica: era o momento em que o valor mudava de mãos. O leitor chegava ao servidor do editor, o editor servia o anúncio ou registava a lead, e a cadeia fechava-se. Um motor generativo parte essa cadeia ao meio. Recupera o documento, extrai dele o fragmento de que precisa, compõe a resposta na sua própria interface e, no melhor dos casos, devolve ao editor uma linha de atribuição que o utilizador pode ignorar sem custo nenhum. O trabalho editorial continua a ser consumido. O que desaparece é o evento que o pagava.
Vale a pena olhar para o que se passa do lado técnico, porque a diferença não é filosófica. Há pelo menos dois tipos de pedido a chegar ao servidor de um editor e eles não valem o mesmo. Um é a recolha para treino, que passa uma vez, leva o texto e não volta a precisar dele: o documento passa a estar dentro dos pesos do modelo e nenhuma visita futura é gerada por ele. O outro é a recolha em tempo de resposta, em que o sistema vai buscar a página no momento em que alguém fez uma pergunta, precisamente porque precisa de material que não tem memorizado. Este segundo caso é o único em que o editor tem alguma alavanca, porque é o único em que a página é lida por causa de uma pergunta concreta e pode ser nomeada na resposta a essa pergunta.
O robots.txt regula mal esta distinção, e convém não fingir o contrário. É um ficheiro de convenção, obedecido por quem escolhe obedecer, que opera sobre caminhos e agentes declarados. Consegue pedir a um agente identificado que não recolha uma secção. Não consegue distinguir a finalidade da recolha quando o mesmo agente serve as duas, não consegue impedir que um terceiro que já recolheu a página a use, e não tem efeito nenhum sobre um cliente que não se identifique. É uma porta com etiqueta, não uma fechadura.
É aqui que a nossa própria medição ajuda a calibrar a conversa. Durante 23 horas de agosto de 2026, 72,4% dos pedidos a este site chegaram com um user agent não reconhecido, contra 19,7% do Chrome, e os rastreadores de motores de busca com nome somaram 3,5%. O método e os números completos estão em tráfego de bots medido num site pequeno. A leitura económica desse resultado é desconfortável: a maior parte da largura de banda que um site pequeno paga é consumida por clientes que não deixam rasto identificável, não geram uma sessão e não podem ser reconciliados com nenhuma linha de receita. O custo de servir é real e imediato. O retorno é indireto, diferido e, na maioria dos casos, não mensurável com as ferramentas que a equipa de marketing já tem instaladas.
As taxas de crescimento do tráfego referido por IA que circulam em apresentações quase nunca têm fonte nomeada, por isso não acrescentamos mais uma. A aritmética explica porquê: esse tráfego parte de uma fração de um por cento das visitas, e uma fração que triplica continua a ser uma fração. Um multiplicador grande sobre uma base minúscula produz um título e quase nenhum visitante. As secções seguintes não assentam, portanto, numa taxa de crescimento. Assentam no que já se vê nos registos do servidor e em estudos com amostra e autor declarados.
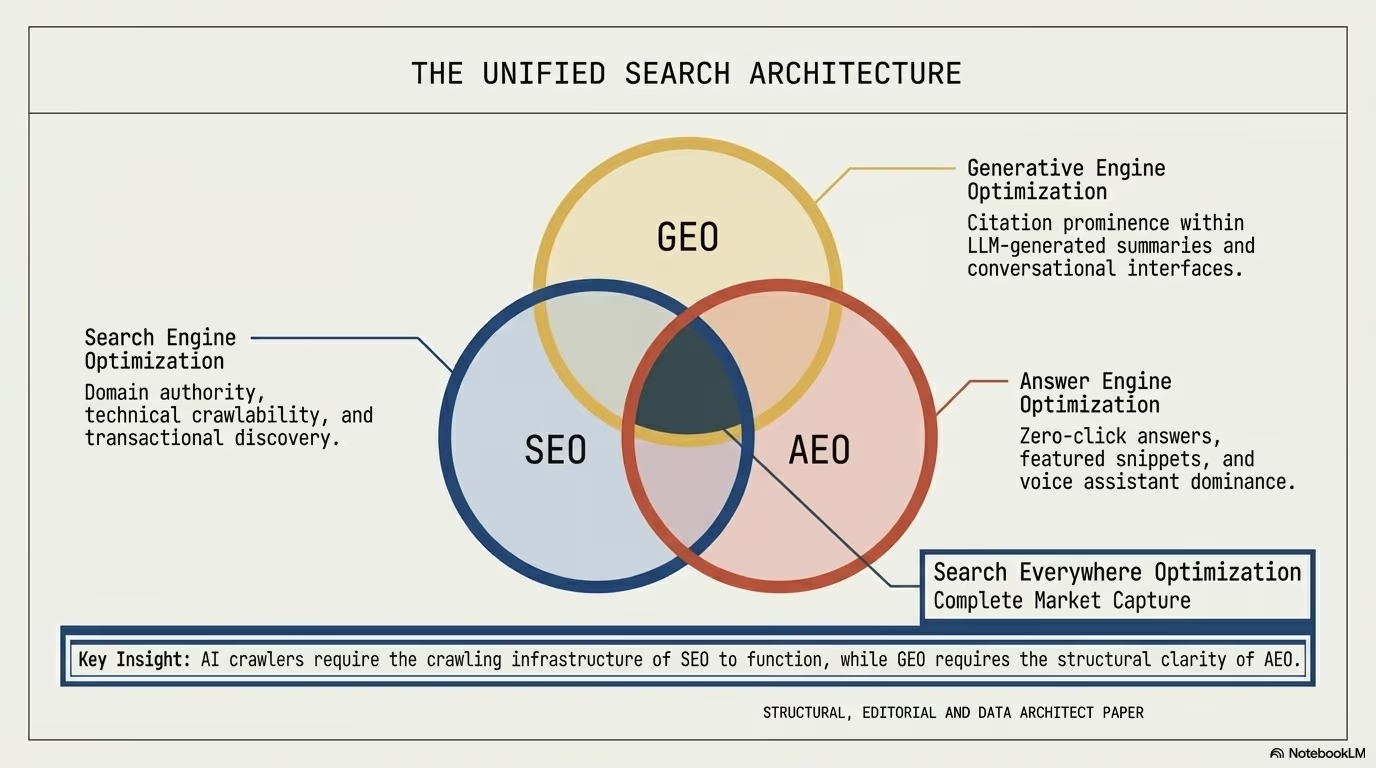
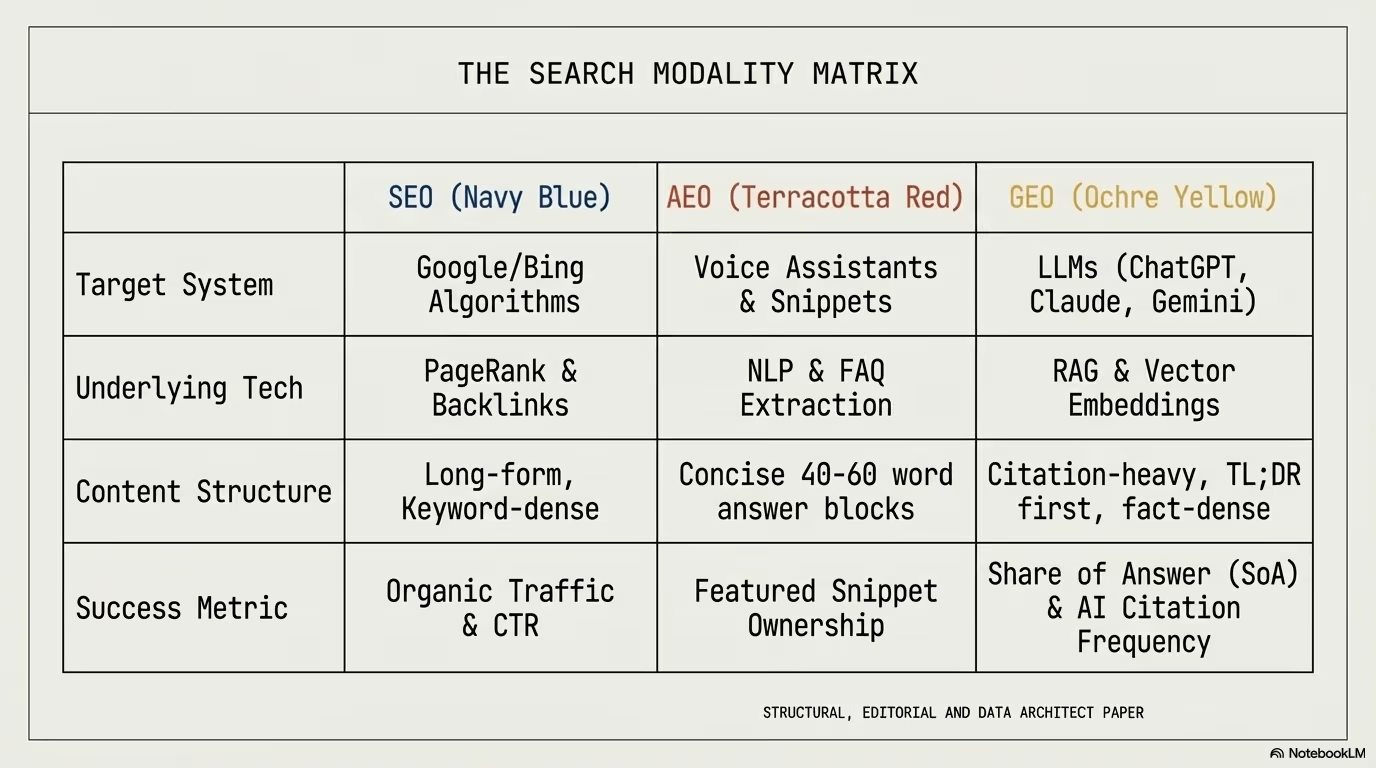
A diferença operacional entre SEO e GEO resume-se ao que cada sistema recompensa. O SEO recompensa a página que convence uma pessoa a clicar, e o título e a meta descrição são instrumentos de persuasão. O GEO recompensa a página em que um sistema automático confia o suficiente para a nomear perante o seu utilizador, e aí não há persuasão nenhuma: há um fragmento que ou é extraível e verificável, ou não é. Tratar os dois como o mesmo trabalho deixa o conteúdo encalhado entre os dois, bom demais para ser barato e frouxo demais para ser citado.
1. A regra “TLDR”: as citações são ganhas nas primeiras 200 palavras
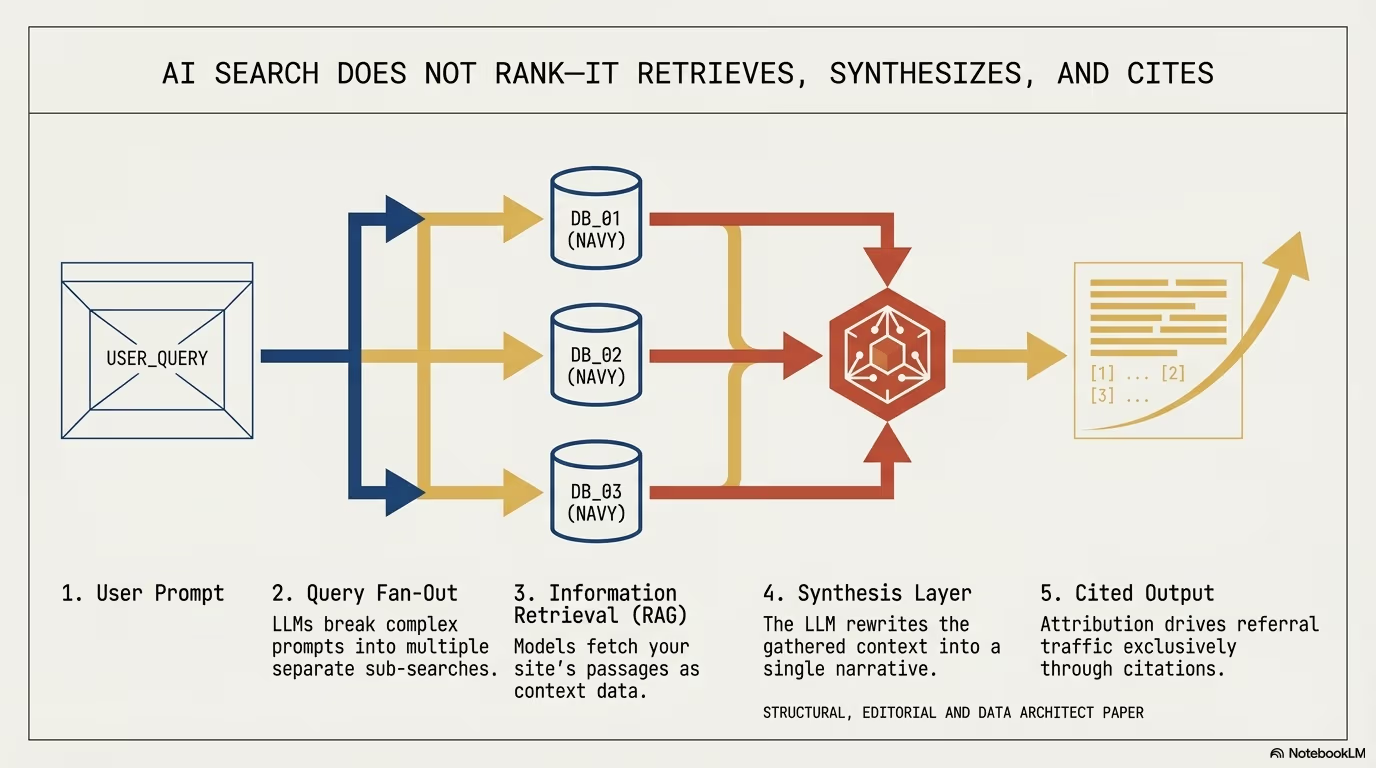
Comecemos pelo mecanismo, porque a recomendação só faz sentido depois dele. Um sistema de Retrieval-Augmented Generation não lê o artigo. Parte o documento em fragmentos de algumas centenas de palavras, converte cada fragmento num vetor, compara esses vetores com o vetor da pergunta e entrega ao modelo apenas os melhores classificados, tipicamente meia dúzia. O modelo escreve a resposta com o que lhe foi entregue. Tudo o que ficou de fora dessa seleção não existe para efeitos daquela resposta, por mais bem escrito que esteja e por mais que esteja indexado.
A análise de Kevin Indig sobre 1,2 milhões de respostas do ChatGPT mostra que 44,2% das citações verificadas de LLM vêm dos primeiros 30% de uma página. O número não é um capricho de leitura rápida. É consequência direta de como o fragmento inicial costuma estar escrito: apresenta o tema, define os termos e enuncia a conclusão, o que o torna semanticamente próximo de quase qualquer formulação da pergunta. O fragmento que vive a meio de uma secção técnica está cheio de pronomes cujo antecedente ficou no parágrafo anterior e que, isolado, deixa de ser interpretável.
A consequência económica é que a primeira secção deixou de ser uma rampa de entrada e passou a ser o produto. Durante anos a abertura foi escrita para adiar a resposta e prolongar o tempo na página, porque o tempo na página alimentava métricas de envolvimento e impressões publicitárias. Esse cálculo inverteu-se. Adiar a resposta agora significa entregá-la a um concorrente cujo primeiro fragmento estava pronto a ser extraído.
Na prática, isto exige uma abertura que funcione sozinha: um resumo abaixo de trezentas palavras que responda diretamente à pergunta principal, com os termos escritos por extenso em vez de referidos por pronome, e com os dados de suporte no mesmo fragmento em que está a afirmação que eles sustentam. Um número separado da sua afirmação por três parágrafos é, para o classificador, um número sem contexto.
“Responda à pergunta primeiro, depois explique as nuances. É assim que se escreve para pesquisa com IA: clareza primeiro, profundidade depois.”
Nada disto justifica conteúdo superficial. A profundidade continua a decidir se a fonte volta a ser citada depois de o modelo verificar o resto da página. O que muda é a arquitetura: os factos mais citáveis à cabeça, e o corpo restante a construir o contexto, as evidências e as ressalvas que sustentam a abertura. Um teste barato antes de publicar: copie o primeiro fragmento para um ficheiro em branco, leia-o sem o resto e pergunte se ainda responde à pergunta. Se precisar de voltar ao artigo para o compreender, o classificador também precisaria, e ele não vai voltar.
2. A maioria das citações de IA vem de fora do top 10 orgânico
A Digital Applied analisou 863 412 pesquisas entre outubro de 2025 e fevereiro de 2026 e concluiu que 62% das citações do AI Overview vêm de páginas na posição onze ou abaixo, ou de páginas totalmente fora do top 100. Para uma direção de marketing, esta é a linha do artigo com consequências orçamentais mais imediatas, porque desfaz a equivalência entre a fatura do SEO e a visibilidade em IA que quase todos os planos anuais ainda assumem.
O mecanismo por baixo é a diferença entre um resultado e um fragmento. A página de resultados clássica ordena documentos: dez candidatos, avaliados como unidades, com a autoridade de domínio e o perfil de links a pesar bastante na ordenação. A recuperação para uma resposta generativa ordena fragmentos e fá-lo sobre um conjunto muito maior do que os dez primeiros lugares. Uma página que esteja em quadragésimo lugar para a frase principal pode conter, a meio, o parágrafo que responde exatamente à subconsulta que o sistema gerou, e é esse parágrafo que entra no contexto. O ranking nem chega a ser consultado como critério.
Isto abre uma janela genuína para quem não tem escala. Um domínio pequeno não compete em autoridade acumulada, mas compete perfeitamente em clareza de formulação, em dados estruturados corretos e em ter uma afirmação verificável escrita num parágrafo autónomo. Nenhuma dessas três coisas custa orçamento de aquisição de links. Custam disciplina editorial, que é um custo de outra natureza e cabe numa equipa pequena.
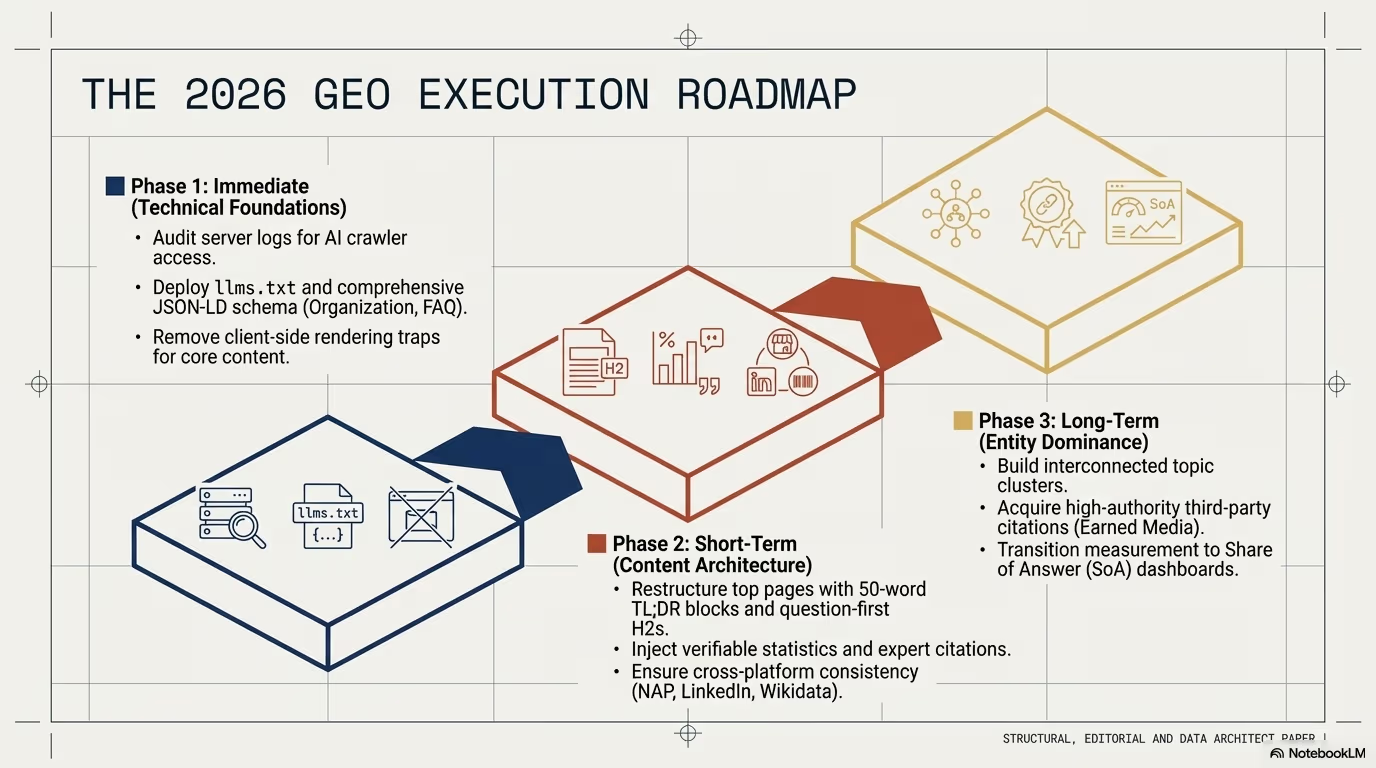
A leitura orçamental correta não é cortar SEO. É reconhecer que os dois trabalhos deixaram de ser o mesmo trabalho e que uma percentagem do esforço tem de passar da aquisição para a estruturação: markup de dados estruturados, afirmações factuais nas primeiras duzentas palavras, schema ao nível de entidades e um ciclo de revisão de frescura. Quem não fizer essa separação vai continuar a pagar por posições que se mantêm enquanto as citações vão para outro lado, e a única forma de o descobrir é ir ver as respostas, porque nenhum relatório de posições o mostra.
3. A autoridade é uma rede, não uma página
A Yext analisou 6,8 milhões de citações de IA e verificou que 86% das citações provêm de sites com cinco ou mais páginas interligadas sobre um tópico específico. Páginas isoladas, por muito bem escritas que sejam, raramente ganham citações, e a razão é de verificação, não de qualidade.
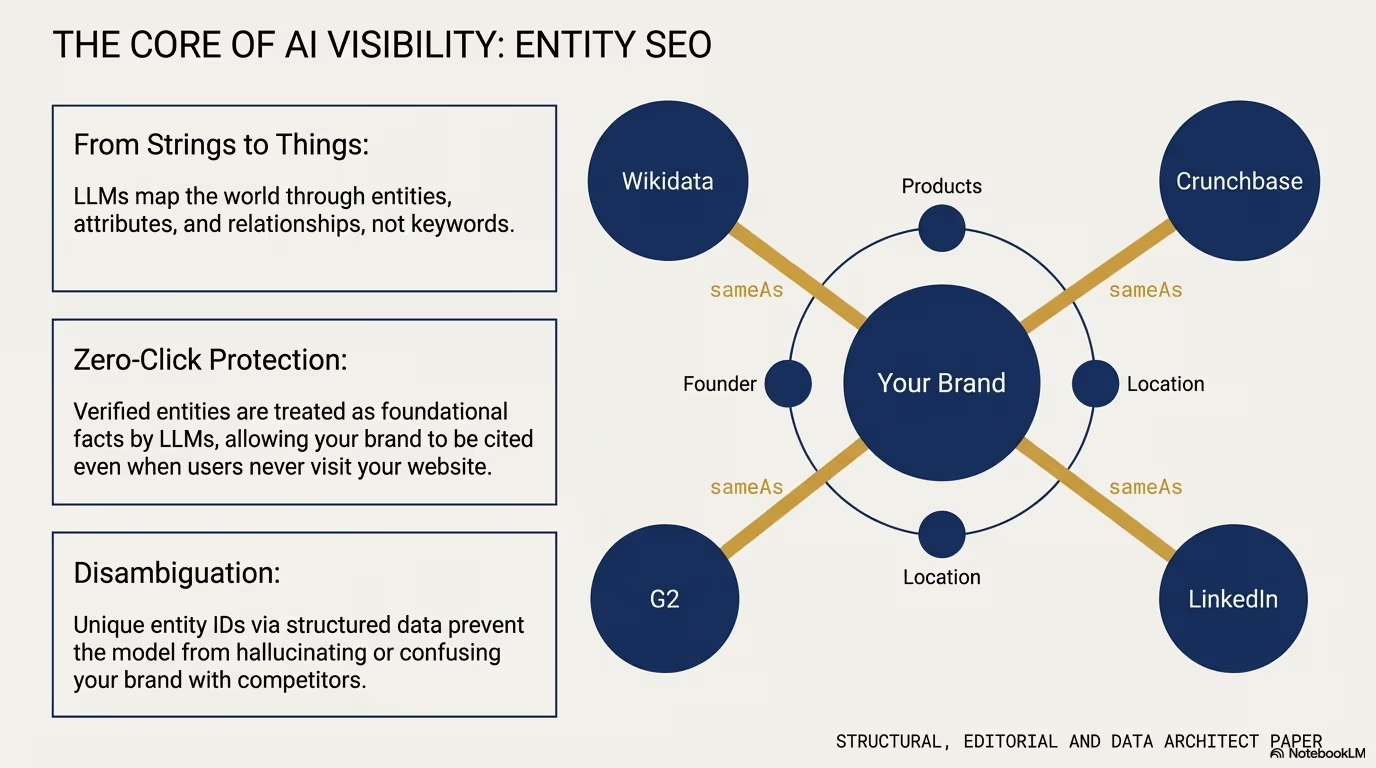
Não encontrámos nenhum estudo publicado que reduza o valor de uma arquitetura pilar e cluster a um único multiplicador, por isso não citamos nenhum. O conjunto de dados da Yext sustenta uma direção, não um coeficiente: o limiar de cinco páginas é onde a quota de citações se concentra, e os sites que o ultrapassam são mantidos por links internos bidirecionais, não por partilharem categoria no menu. O mecanismo por baixo é o risco. Um modelo que compõe uma resposta tem de decidir se a fonte que vai nomear conhece mesmo o tema ou apenas posicionou para uma frase. Uma página isolada dá-lhe um dado e nenhuma forma de o testar. Um pilar com oito subpáginas, cada uma sobre uma parte diferente do tema e cada uma a ligar de volta, dá-lhe um grafo que pode percorrer antes de colocar a sua marca numa resposta que não poderá retirar. Sem esse grafo a página fica órfã: indexada no sentido técnico, inverificável no sentido que aqui conta.
A consequência para quem faz o orçamento é que a unidade de investimento deixou de ser o artigo e passou a ser o conjunto. Cinco páginas coerentes sobre um tema estreito valem mais, em probabilidade de citação, do que quinze artigos avulsos sobre quinze temas, e custam menos a manter atualizadas porque partilham as mesmas fontes e o mesmo ciclo de revisão. É uma conclusão pouco popular em planos editoriais que medem produção por volume mensal, e é a que os dados sustentam.
Na prática, isto significa um pilar que cobre o tema amplo e páginas de cluster que aprofundam subtópicos, todas a ligar de volta ao pilar e entre si com anchor text descritivo. Um site que cubra segurança WordPress como pilar precisa de páginas interligadas sobre configuração de firewall, deteção de malware, proteção do login, implementação de SSL, verificação de vulnerabilidades em plugins e resposta a incidentes. A ressalva importa tanto como a receita: cinco páginas finas escritas para atingir o limiar não produzem o efeito, porque o que é percorrido na verificação é o conteúdo das páginas ligadas, não a contagem de links.
A camada de entidades fecha o argumento. Cada conceito central do site ganha em estar ligado à sua entidade correspondente na Wikidata, e os dados estruturados em exprimir as relações entre essas entidades em vez de as listar. Quando um sistema consegue percorrer um grafo de entidades claro ao longo do conteúdo, deixa de tratar o site como uma coleção de artigos e passa a tratá-lo como uma base de conhecimento consultável.
4. O precipício de frescura de 90 dias
O estudo da Seer Interactive sobre o impacto da atualidade na visibilidade em IA aponta que o conteúdo atualizado nos últimos 90 dias atinge taxas de citação cerca de 2x maiores do que material mais antigo, e que o conteúdo sem alterações há mais de 18 meses é largamente ignorado, independentemente da autoridade histórica da página.
O mecanismo é defensivo, não estético. Um sistema que responde com números tem um problema que um motor de busca clássico não tinha: se citar um preço, uma versão ou uma percentagem desatualizada, o erro aparece dentro da resposta, com a marca do sistema por cima e a marca da fonte por baixo. Um motor de busca que devolvia dez links transferia essa avaliação para o leitor. Um motor que sintetiza assume-a. A data serve então como aproximação barata para o risco de estar errado, e na dúvida o sistema prefere a fonte recente.
A consequência económica é a que mais custa a digerir: o custo de manter passou a ser comparável ao custo de criar. Um catálogo de duzentos artigos com um ciclo trimestral de revisão é um compromisso operacional permanente, não um projeto que fecha na publicação. Muitas equipas descobrem, ao fazer esta conta pela primeira vez, que produziram mais conteúdo do que conseguem manter vivo, e a resposta correta costuma ser reduzir o catálogo a um número que a equipa consegue rever de facto, não contratar mais produção.
Manter frescura significa atualizar dados e estatísticas por ciclo, acrescentar secções sobre subtópicos que entretanto apareceram, verificar que os links externos ainda resolvem e rever recomendações que possam ter mudado. Mexer na data sem mexer no texto não produz o efeito e é detetável: o que muda entre duas recolhas é o corpo do documento, não o campo da data.
5. Os sistemas de IA preferem a “camada de legitimidade”
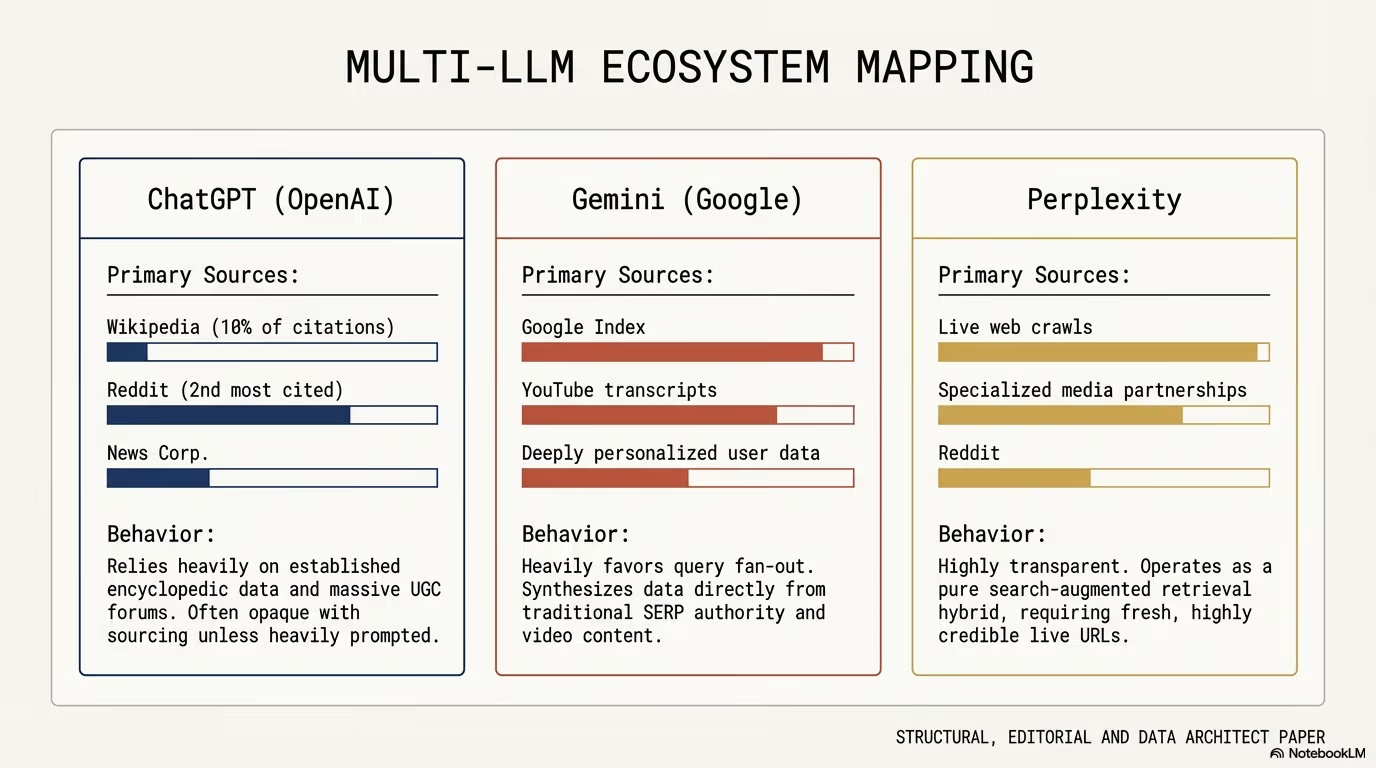
Segundo a análise de padrões de citação da Profound, a Wikipedia representa 7,8% de todas as citações do ChatGPT, com o Reddit em segundo lugar a alguma distância. Uma única plataforma enciclopédica gera mais citações do que a soma de um número muito grande de sites corporativos, e isto não se explica por qualidade editorial.
Explica-se por estrutura e por incentivo. A Wikipedia escreve em afirmações curtas, atribuídas e datadas, com uma referência ao lado de cada uma. É o formato mais próximo do que o processo de extração precisa e, ao mesmo tempo, é conteúdo que ninguém publicou para vender nada, o que reduz o risco de o sistema estar a repetir material promocional. O conteúdo da própria marca falha nas duas frentes ao mesmo tempo: costuma estar escrito em parágrafos persuasivos e tem um interesse comercial declarado.
Daí resulta uma ordem de operações que muitas empresas invertem. Para ser citado no seu próprio domínio, muitas vezes é preciso primeiro ser mencionado em domínios que o sistema já trata como fiáveis: fóruns, imprensa, publicações setoriais, repositórios académicos. Essas menções funcionam como o sinal que justifica nomear o domínio próprio numa resposta. Sem essa camada, o conteúdo de primeira parte fica num vazio de confiança.
“A Wikipedia lidera as citações do ChatGPT com uma quota de 7,8%, enquanto a segunda fonte mais citada, o Reddit, fica muito atrás. Funciona como uma camada de legitimidade para as empresas.”
A tradução orçamental é que uma parte do investimento em conteúdo próprio tem de migrar para relações públicas digitais e presença em comunidades, e essa parte tem um perfil de retorno diferente: mais lento, mais difícil de atribuir e menos controlável. A ressalva honesta é que nenhuma destas superfícies aceita colocação paga de factos. Uma menção comprada num sítio que o sistema trata como fiável degrada esse sítio antes de beneficiar quem a comprou, e a correção dessa degradação não está sob controlo de nenhuma das partes.
6. O /LLMs.txt: um sinal, não uma fechadura
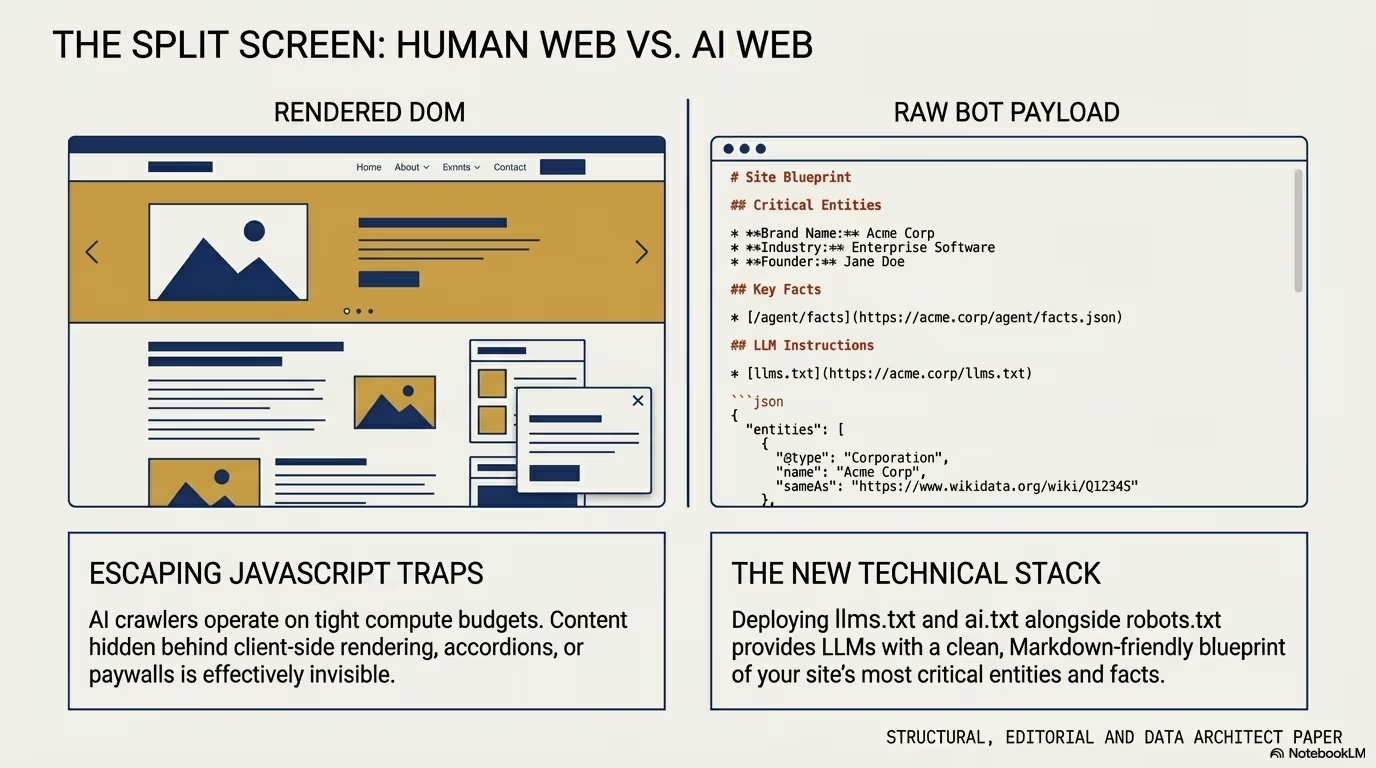
O ficheiro /LLMs.txt é um diretório em Markdown, colocado na raiz do domínio, com a especialização do site, as afirmações factuais centrais e links para as páginas mais sólidas. A diferença face ao robots.txt é de finalidade e vale a pena ser exato sobre ela: o robots.txt diz onde um agente identificado não deve ir, e o /LLMs.txt oferece material já preparado a um agente que decidiu vir.
O problema que tenta resolver é de custo de leitura. Quando um agente vai buscar uma página durante uma conversa, tem uma janela de contexto finita e um orçamento de tempo apertado. O que recebe é o HTML completo: cabeçalho, menus de navegação, banners de consentimento, rodapé com dezenas de links e, com frequência, conteúdo que só aparece depois de correr JavaScript que o agente pode não correr. A parte útil do documento pode ser uma fração pequena dos bytes transferidos. Um resumo limpo em Markdown elimina esse desperdício.
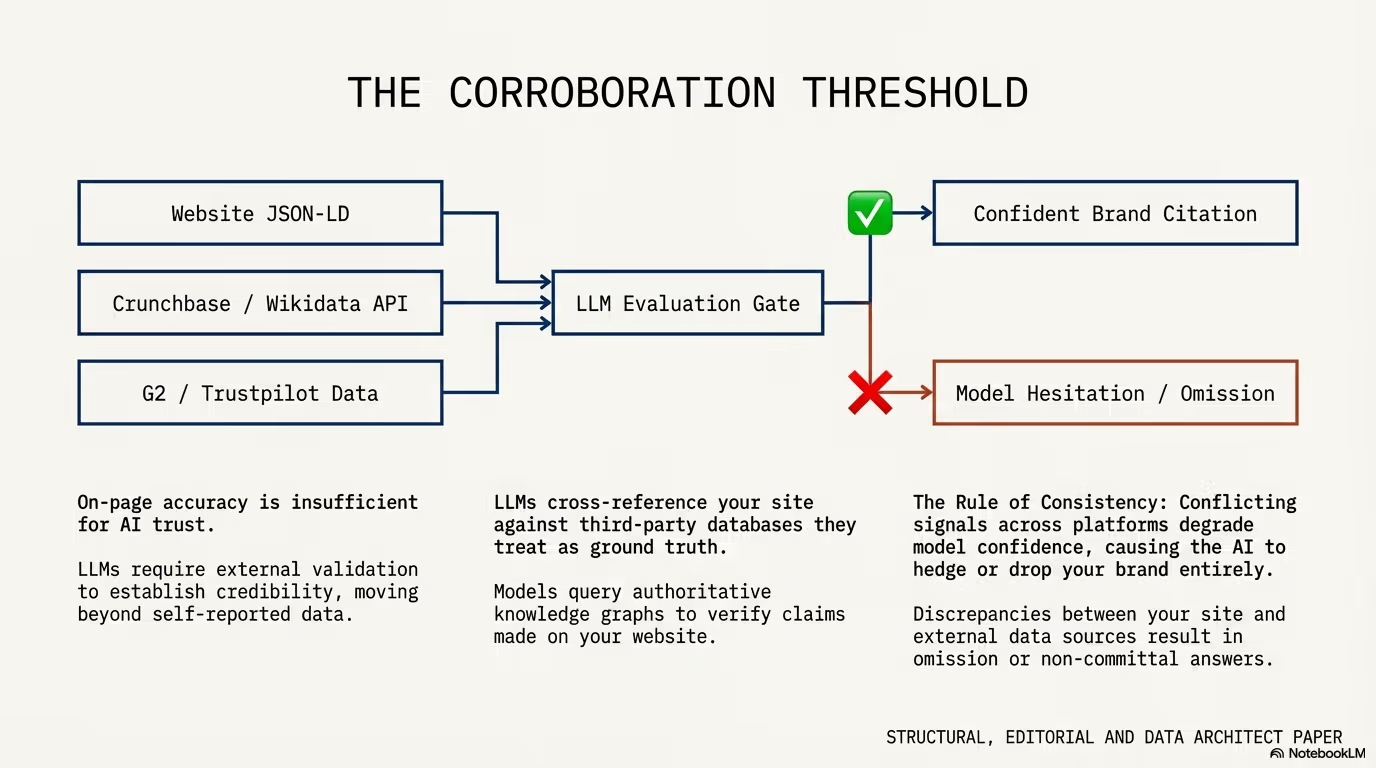
A implementação é direta: um ficheiro Markdown na raiz que descreve a especialização do site, lista o conteúdo mais importante com resumos breves e enuncia factos que um modelo possa extrair e atribuir, atualizado sempre que sai conteúdo relevante. Alguns sites acrescentam ficheiros complementares, como um sitemap orientado a IA ou feeds em JSON, com a mesma lógica de reduzir o trabalho de quem lê.
Aqui é preciso dizer o que não sabemos, e esta é a parte que a maioria dos textos sobre o tema omite. Não existe um resultado publicado, com amostra e método, que demonstre que a presença deste ficheiro aumenta a taxa de citação. É uma convenção emergente, não um padrão implementado de forma uniforme, e nada obriga um sistema a lê-lo. O argumento a favor é de custo: o ficheiro leva uma tarde a escrever e uma hora por trimestre a manter, o que é pouco para uma aposta com retorno incerto. O argumento contra é confundi-lo com controlo. Publicar um /LLMs.txt não restringe nada, não impede a recolha do resto do site e não constitui qualquer forma de licença sobre o conteúdo.
7. Intenção sobre precisão: o poder do “query fan-out”
Segundo o SOCi Visibility Index, as pesquisas tradicionais digitadas têm em média 4 palavras e as consultas dirigidas a sistemas de IA têm em média 23 palavras. A diferença não é de estilo. É de quantidade de restrições que o utilizador entrega logo à partida.
Um utilizador escrevia “melhores plugins segurança WordPress 2026”. O mesmo utilizador escreve agora: “Tenho uma loja WooCommerce em alojamento partilhado e estou preocupado com a segurança. Que plugins devo instalar para proteger contra os ataques mais comuns sem abrandar o meu site?” Ali estão a plataforma, o tipo de alojamento, o risco percebido e uma restrição de desempenho. O sistema executa então um query fan-out: divide a pergunta em várias subconsultas, cada uma sobre um aspeto diferente, recupera fragmentos para cada uma e compõe uma resposta única a partir do conjunto.
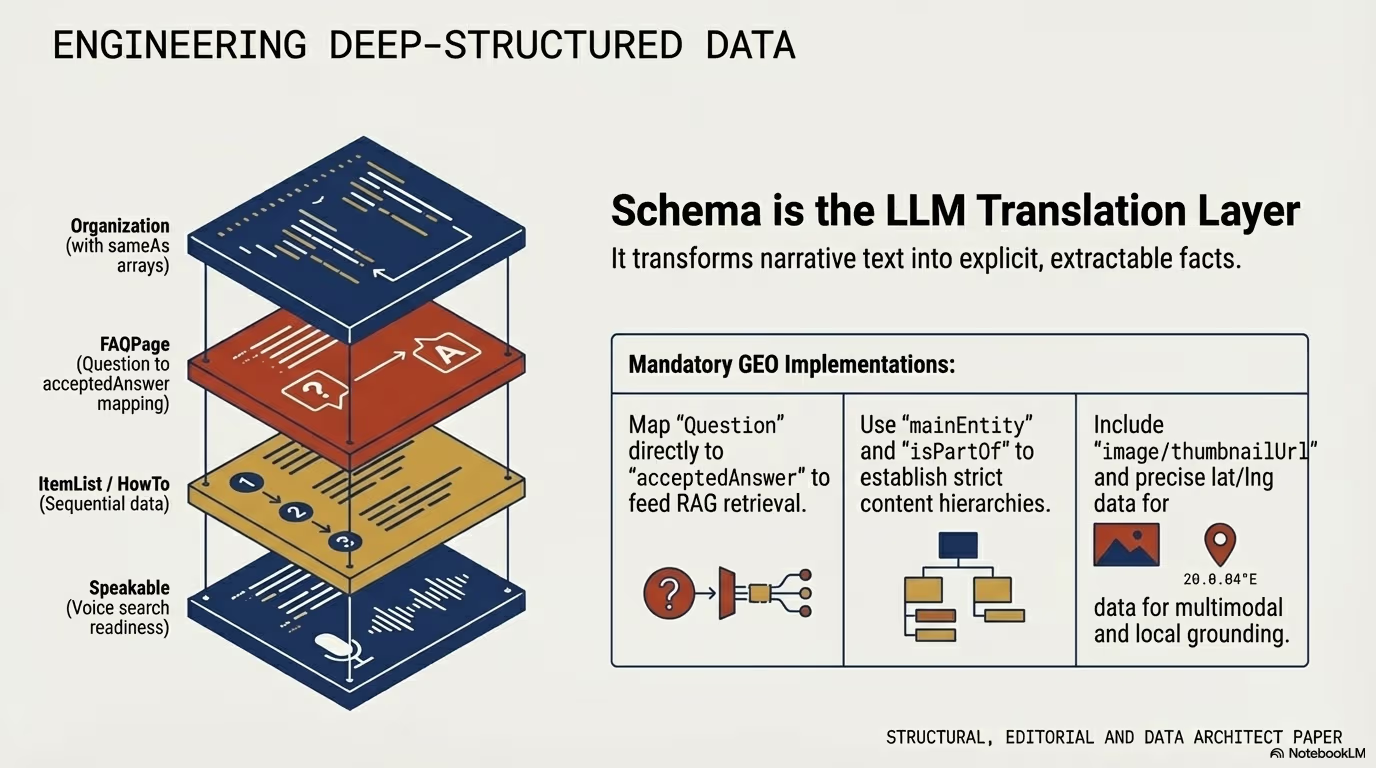
A consequência prática é que uma resposta pode citar cinco fontes distintas, cada uma a cobrir um pedaço do problema, e nenhuma delas se posicionava para a frase inteira. Ganha citação o texto que trata de um cenário concreto com as suas restrições, não o que trata do tema em abstrato. Conteúdo estruturado como “se está na situação X, a abordagem é Y porque Z” tem muito melhor desempenho do que “a melhor abordagem é Y”, porque dá ao sistema o material para justificar que a resposta se aplica a este utilizador e não a um utilizador genérico.
A leitura económica é a mais contraintuitiva de todo o artigo. O fan-out fragmenta a procura: em vez de uma frase de alto volume disputada por todos, aparecem muitas formulações longas, cada uma com pouquíssimas ocorrências, e cada uma a puxar fragmentos diferentes. Isso desvaloriza o ativo em que mais se investiu na última década, a página única otimizada para a frase principal, e valoriza o material de cauda longa que muitos catálogos consideravam demasiado nicho para justificar produção. Uma FAQ honesta, um guia passo a passo e uma recomendação por cenário deixaram de ser conteúdo de segunda linha e passaram a ser a matéria-prima de que o fan-out precisa. Escrever como uma pessoa escreve para outra pessoa tornou-se, por esta via, uma otimização técnica e não apenas uma preferência de estilo.
Tornar-se a resposta
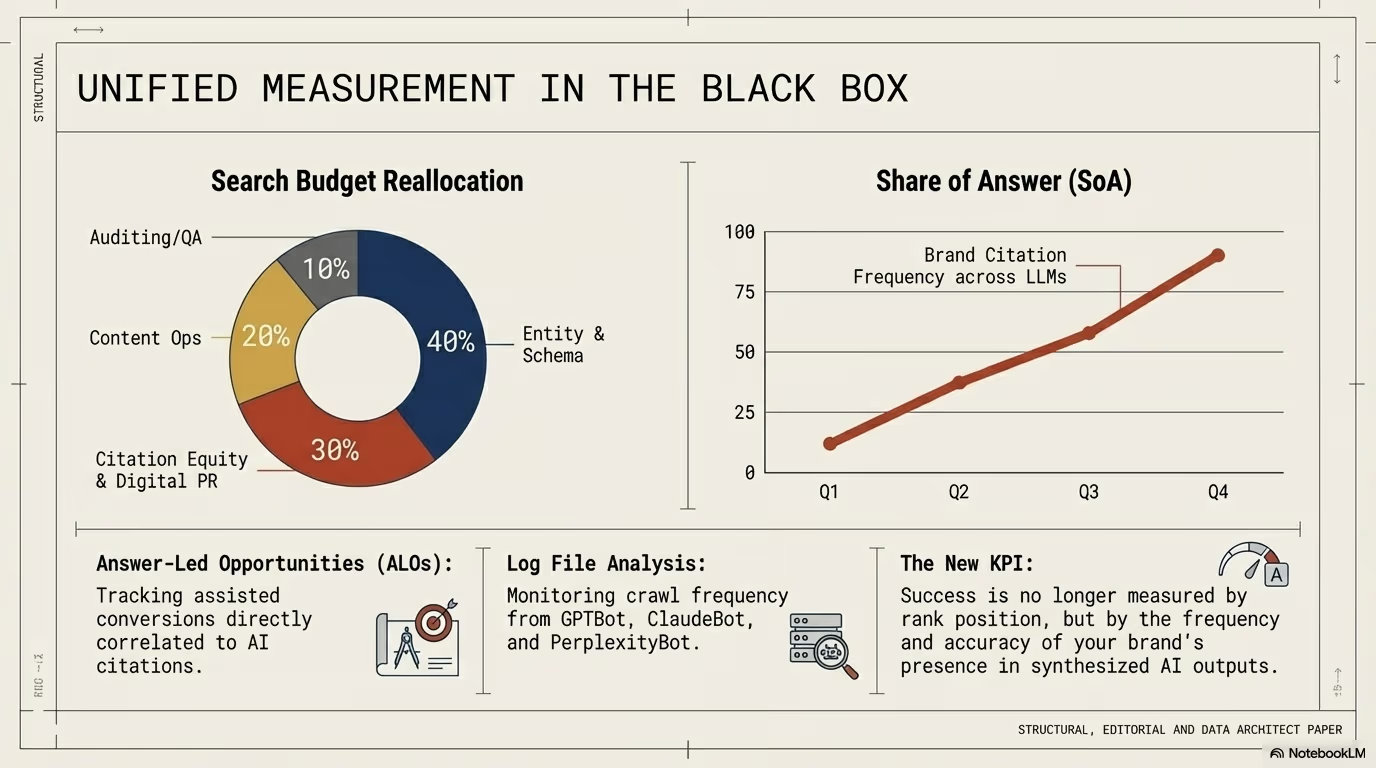
Fica por resolver o problema que nenhuma das sete secções resolve sozinho: a medição. Se um leitor obtém a resposta da sua marca dentro de uma interface de IA e nunca chega ao seu servidor, não existe sessão, não existe referrer utilizável, não existe evento de analytics e não existe nada para reconciliar com receita. A visibilidade aconteceu e o instrumento não a registou. Enquanto isto se mantiver, qualquer discussão sobre retorno deste trabalho assenta em aproximações, e é mais sério dizê-lo do que fabricar um número.
Há aproximações utilizáveis, todas imperfeitas. Verificar manualmente, com uma cadência fixa, se a marca aparece nas respostas a um conjunto pequeno de perguntas que interessam ao negócio. Ler os registos do servidor para separar clientes automáticos de pessoas, como fizemos na medição citada mais acima, que serve aqui um segundo propósito: não só mostra quanta largura de banda vai para clientes sem sessão, como identifica quais dos caminhos do site esses clientes procuram, o que é o indício mais barato de que material está a ser consumido sem clique. E acompanhar pesquisas diretas pelo nome da marca, que costumam subir quando alguém ouviu falar dela numa resposta e foi procurá-la à mão.
As sete secções acima resumem-se a sete decisões operacionais:
- Estruture o conteúdo para extração: coloque os factos mais citáveis nas primeiras duzentas palavras, num fragmento que se perceba isolado.
- Separe os dois orçamentos: SEO e GEO passaram a ser trabalhos distintos, e a fatura de um não compra os resultados do outro.
- Construa redes temáticas: cinco ou mais páginas coerentes e interligadas por tema, porque é o conjunto que permite a verificação.
- Conte o custo de manter: um ciclo de 90 dias sobre um catálogo que a equipa consegue rever vale mais do que um catálogo maior parado.
- Invista na camada de legitimidade: menções em plataformas que os sistemas já tratam como fiáveis, ganhas e não compradas.
- Publique o /LLMs.txt pelo custo, não pela promessa: barato de manter, sem efeito demonstrado, e sem qualquer poder de controlo.
- Escreva por cenário: o fan-out procura restrições concretas, não frases de alto volume.
O fim do clique não é o fim da visibilidade, mas é o fim de uma forma de a cobrar. Durante vinte anos a web aberta financiou-se com a visita, e a visita era simultaneamente o produto e o recibo. O que substitui isso ainda não está definido, e a diferença entre as empresas que vão atravessar bem esta mudança e as que não vão atravessar é menos uma questão de técnica de conteúdo do que de aceitar cedo que a métrica que mediu tudo até aqui deixou de medir a maior parte do que acontece.