As previsões de Thorsten Ball e os dados com que as testamos
A 19 de setembro de 2026, Thorsten Ball publicou no X uma mensagem curta: a maioria das previsões que vê são, na opinião dele, ainda demasiado cautelosas, por isso apresenta as suas. Juntou uma nota intitulada «What I believe about the future of software development», com 16 teses. Ball é cofundador e cocriador da Amp, trabalhou antes na Sourcegraph e na Zed e publicou em edição de autor dois livros sobre programação. Não é uma voz de fora do setor.
As teses são duras: a revisão de código vai morrer, os testes unitários podem morrer, o terminal já morreu, o open source na forma atual deixou de fazer sentido. Respondemos a cada uma em separado, com uma avaliação: concordamos, concordamos em parte ou não concordamos.
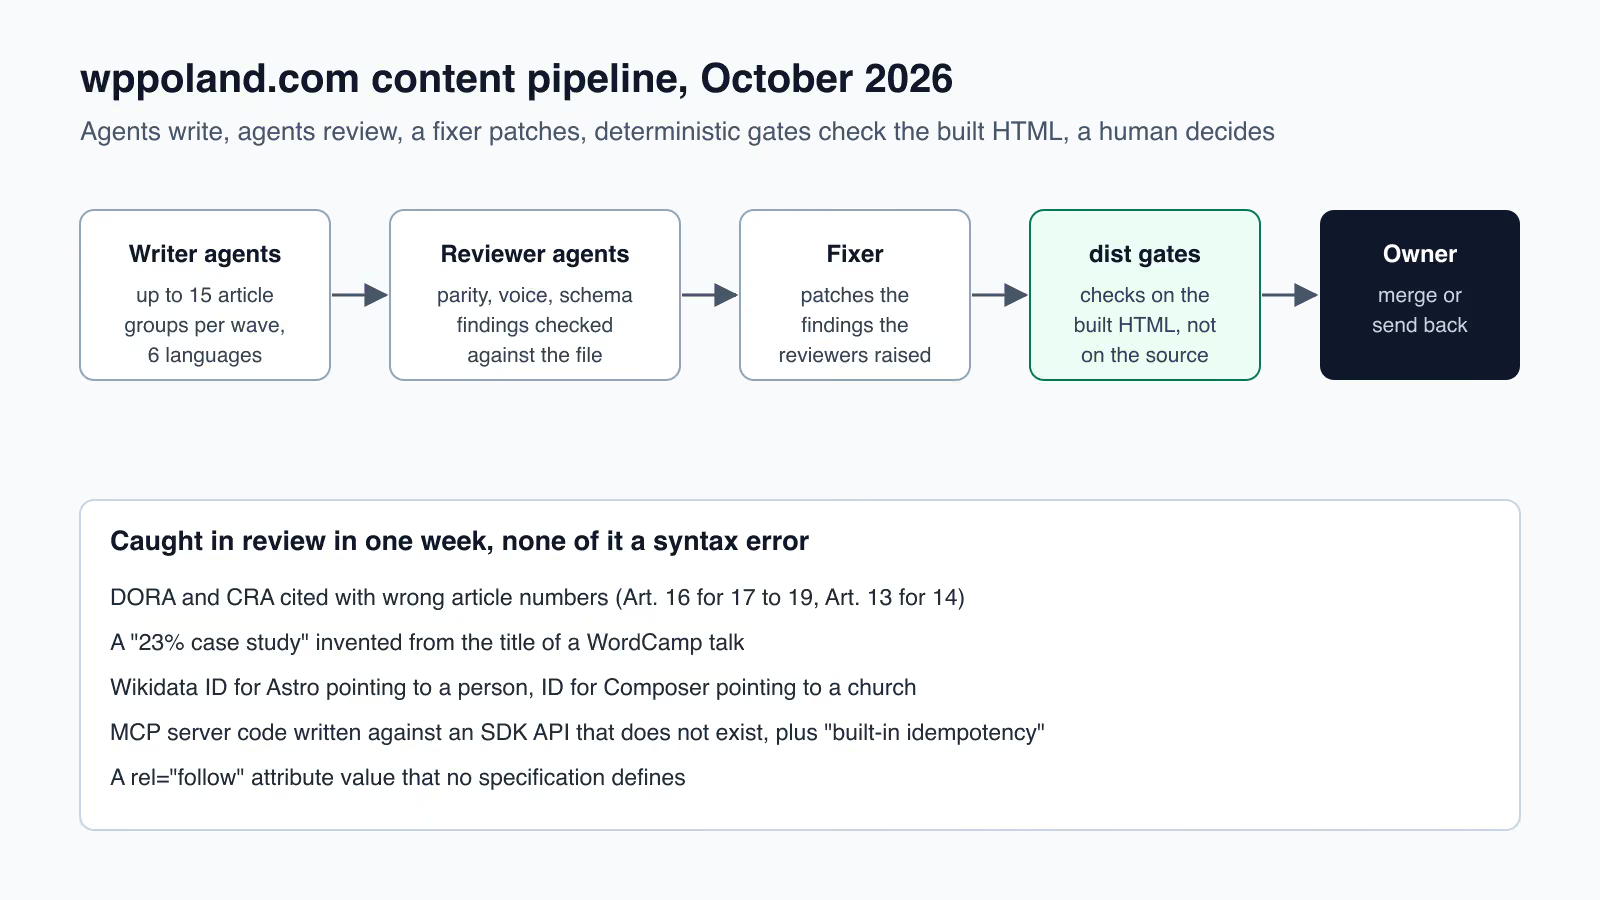
As nossas provas vêm de um sítio que conhecemos de perto: o pipeline de agentes de IA que, em outubro de 2026, está a expandir os conteúdos deste site. Os agentes que escrevem trabalham em paralelo e, numa só vaga, tratam até 15 grupos de artigos em seis línguas. Segundo o histórico do repositório, a vaga 20, de 15 de outubro, abrangeu 14 grupos e 85 ficheiros. Agentes revisores independentes verificam a coerência entre versões linguísticas, o estilo e os dados estruturados, e um agente separado corrige o que eles apontaram. No fim, controlos executados sobre o HTML gerado decidem se a alteração pode sequer avançar. O esquema está na ilustração no topo da página.
O pipeline trabalha sobre um site em produção com milhares de páginas, por isso um erro de agente que ninguém apanhe vai direto para o motor de pesquisa. É por isso que a nossa opinião sobre o futuro da programação é mais estreita do que a de Ball, mas assenta no que vimos com os nossos próprios olhos na última semana.
O futuro do desenvolvimento de software segundo Thorsten Ball
Abaixo estão todas as teses da nota, pela ordem do autor, com a nossa avaliação. Cada uma é desenvolvida mais à frente no texto.
| Tese de Thorsten Ball | A nossa avaliação |
|---|---|
| A revisão de código vai morrer | Não concordamos, a revisão muda de objeto |
| Os testes unitários podem morrer | Não concordamos |
| O ofício de escrever código vai desaparecer | Concordamos em parte |
| O ofício de construir software vai ser mais importante do que nunca | Concordamos |
| A maioria dos erros será do tipo «pediu a coisa errada» | Concordamos |
| O open source na forma atual deixou de fazer sentido | Não concordamos |
| O contributo humano para o desempenho vai continuar a ser um caso marginal | Concordamos em parte |
| O terminal morreu | Não concordamos |
| Os tokens são o novo paradigma de computação | Concordamos em parte |
| A tríade PM, design e engenharia vai desaparecer | Concordamos em parte |
| O fosso entre grandes e pequenas empresas vai aumentar | Concordamos em parte |
| Não há prova de que o «bom código» vá importar | Concordamos em parte |
| Algumas pessoas vão deixar de poder pagar para produzir software | Concordamos em parte |
| É duvidoso que os modelos mais baratos venham a ser usados | Concordamos |
| A interface será gerada em tempo real | Sem dados do nosso lado |
| Vai demorar uma geração | Concordamos |
Balanço: em quatro pontos damos razão a Ball, em quatro discordamos, em sete vemos a direção mas não a escala, e num não temos dados.
A revisão de código ainda faz sentido com IA
«A revisão de código vai morrer. Quer dizer: já está morta. Mas, no futuro, as pessoas não vão encontrar um erro ou um problema no código produzido por um modelo, pelo menos não num tempo razoável. As pessoas vão rever apenas o sistema e a sua composição, mas não em PRs nem a percorrer cada linha do código.»
(Thorsten Ball, publicação no X de 19 de setembro de 2026, tradução própria)
Avaliação: não concordamos, embora a segunda metade da tese esteja certa.
Ball tem razão numa coisa: uma pessoa a rever linha a linha centenas de ficheiros por vaga não tem hipótese. Erra na conclusão. A revisão não morre, muda de objeto. No nosso pipeline já ninguém procura um ponto e vírgula em falta. O revisor procura a afirmação falsa que está sintaticamente correta.
Eis a lista de uma única semana de outubro de 2026, apanhada pelos revisores:
- Os agentes indicaram números de artigo errados em textos sobre regulação: o artigo 16 do DORA onde deviam estar os artigos 17 a 19, e o artigo 13 do CRA onde devia estar o artigo 14.
- Um agente criou um «estudo de caso com um resultado de 23 por cento» a partir apenas do título de uma palestra num WordCamp. Esse estudo não existia.
- O identificador Wikidata indicado para o Astro apontava para uma pessoa, e o do Composer para uma igreja.
- Um agente escreveu código de servidor MCP para uma API do SDK que não existe e atribuiu ao protocolo MCP uma «idempotência integrada» que ele não tem.
- Num texto sobre links apareceu o atributo
rel="follow", que nenhuma especificação define.
Nenhum destes erros é um erro de código no sentido clássico. Todos passariam na compilação, no parser de YAML e no validador de Markdown. Todos teriam sido publicados se a revisão tivesse morrido. Pior: parte deles são afirmações que o leitor aceita sem verificar, porque soam a factos tirados da documentação.
A segunda metade da tese de Ball está certa: a revisão sai dos PRs e passa para o sistema. Os nossos revisores não leem diffs, comparam afirmações com as fontes e as versões linguísticas entre si. A revisão passa de «esta linha está correta?» para «esta frase é verdadeira e o conjunto é coerente?». Isso não se faz na janela de um pull request, mas continua a fazer-se, e é do lado humano que fica a decisão sobre se a alteração vai para produção.
Os testes unitários ainda são necessários com IA
«Os testes unitários também podem morrer. Para quê rodinhas, se nunca cai? Já tive modelos a escrever 900 linhas de C para Arduino, a compilá-las sem um único erro e a enviá-las para o dispositivo, onde o programa correu na perfeição. No futuro, 900 linhas não serão nada.»
(Thorsten Ball, publicação no X de 19 de setembro de 2026, tradução própria)
Avaliação: não concordamos.
O exemplo do Arduino é verdadeiro e impressiona. Mas prova outra coisa do que a tese sugere. Um programa que compila e corre cumpre um critério: faz alguma coisa sem falhar. Não se sabe se faz o que o autor queria com qualquer entrada, nem se vai continuar a fazê-lo depois da próxima alteração.
No nosso site, os testes mais valiosos foram os que verificam o resultado do build, não o código-fonte. Controlos executados sobre a pasta dist contam os títulos H1 de cada página, verificam se alguma marcação Markdown escapou como texto e se os dados estruturados correspondem ao endereço canónico. Esses controlos apanharam regressões em alterações que compilaram sem um único aviso. O compilador não sabe que a página devia ter um título H1 e tem dois.
Um teste não é uma rodinha. É o registo de uma expectativa numa forma que a máquina verifica a cada alteração seguinte, incluindo a que um agente fizer daqui a meio ano. Quanto mais código os modelos escrevem, mais compensa esse registo, porque nenhuma pessoa vai ler tudo o que eles geraram. O que muda é antes o nível dos testes: menos testes de uma função isolada, mais testes do comportamento do sistema inteiro e do seu resultado.
Vale a pena aprender a programar em 2027
«O ofício de escrever código vai desaparecer. Sim, ainda há sapateiros italianos por aí. Mas olhe para os seus pés.»
«O ofício de construir software vai ser mais importante do que nunca. Saber resolver problemas de negócio com software, como outro software o fez e porquê e porque não, quando e como lançá-lo, como recolher feedback sobre ele: esse é o novo jogo.»
(Thorsten Ball, publicação no X de 19 de setembro de 2026, tradução própria)
Avaliação: com a primeira tese concordamos em parte, com a segunda totalmente.
Escrever código linha a linha perde de facto importância. No nosso pipeline, os agentes escrevem conteúdo, correções e scripts auxiliares mais depressa do que qualquer um de nós. Mas, para avaliar se o código de um servidor MCP chama uma API que existe, é preciso saber ler esse código e saber onde verificar o SDK. Ler código não desaparece junto com escrevê-lo. O sapateiro da metáfora de Ball já não precisa de coser sapatos, mas alguém tem de reparar que a sola está colada torta.
A segunda tese é a frase mais certeira de toda a nota. Saber o que construir, como dividir o trabalho, quando lançar e como medir o efeito é hoje o gargalo. O nosso repositório tem para isso um documento próprio com princípios de produto, que começa por dizer que o problema deixou de ser «como implementar isto» e passou a ser «o que deve sequer existir».
À pergunta sobre se vale a pena aprender a programar respondemos, portanto: aprender a construir software e tratar a escrita de código como caminho para perceber o que o agente produz. Desenvolvemos o tema de saber se a IA vai tirar trabalho a quem faz sites no texto a IA vai substituir os programadores WordPress, e o trabalho com agentes em equipa no artigo sobre agentic engineering.
Erros em código feito com IA vêm muitas vezes do pedido errado
«A maioria dos erros não serão erros ‘de código’. Serão erros do tipo ‘pediu a coisa errada’.»
(Thorsten Ball, publicação no X de 19 de setembro de 2026, tradução própria)
Avaliação: concordamos.
É uma tese que a nossa lição mais cara confirma. Lotes anteriores de tarefas para os agentes pediam para expandir artigos até um determinado número de palavras. Os agentes cumpriram exatamente essa instrução: acrescentaram texto que fazia subir o contador e não trazia conteúdo. O código dos scripts não tinha erros. Errado estava o pedido. Hoje, uma regra do repositório proíbe scripts que enchem conteúdo até um número de palavras, e um controlo separado apanha blocos de enchimento repetidos.
O mesmo mecanismo vê-se no estudo de caso inventado com o resultado de 23 por cento. O agente recebeu a tarefa «acrescenta uma secção baseada em fontes» e uma fonte que era apenas o título de uma palestra. O modelo preencheu a lacuna com um número. O pedido não dizia o que fazer quando a fonte é demasiado fraca.
Conclusão prática: o que mais tempo consome hoje no trabalho com agentes é escrever a tarefa, ou seja, descrever qual é o resultado, o que é proibido e o que fazer quando faltam dados. É uma especificação, só que mais curta e escrita com mais frequência do que antes.
O open source vai sobreviver à IA
«O open source na sua forma atual já não faz sentido. ‘Com olhos suficientes, todos os erros são superficiais’ continua a ser verdade, mas agora temos olhos artificiais.»
(Thorsten Ball, publicação no X de 19 de setembro de 2026, tradução própria)
Avaliação: não concordamos.
Ball remete para a lei de Linus, formulada por Eric S. Raymond: com muitos participantes, os erros encontram-se depressa. A tese é que, se os modelos podem olhar para o código em vez das pessoas, o modelo aberto de contribuição perde o sentido.
Os dados de um dos projetos open source mais importantes mostram o efeito contrário. Daniel Stenberg, autor do curl, terminou o programa de bug bounty do projeto a 31 de janeiro de 2026. Desde 2019, o programa rendeu 87 vulnerabilidades confirmadas e mais de 100 000 USD em recompensas para investigadores. Segundo Stenberg, nos anos anteriores mais de 15 por cento dos relatórios revelavam-se vulnerabilidades reais, e desde 2025 a percentagem caiu para menos de 5 por cento com a avalanche de relatórios gerados por IA. Nem um em cada vinte era verdadeiro.
Os olhos artificiais existem, mas nesta forma produzem relatórios e não correções, e sobrecarregam os mesmos mantenedores humanos que deviam beneficiar deles. O open source muda, portanto, os filtros de entrada, não o princípio. O WordPress, com que trabalhamos todos os dias, continua a viver de código aberto e de pessoas que decidem o que entra no núcleo. Essa escolha não desaparece quando houver mais código. Vai ser mais importante.
O desempenho do código ainda importa com IA
«As contribuições humanas críticas para o desempenho vão continuar a ser o que são: um caso marginal. Em 99% do software não importa que pudesse ter escrito um algoritmo mais rápido ou escolhido uma estrutura de dados melhor. […] Quando importa, os modelos conseguem corrigir.»
(Thorsten Ball, publicação no X de 19 de setembro de 2026, tradução própria)
Avaliação: concordamos em parte.
É difícil discutir a primeira parte. A maior parte do código não é um gargalo e nunca será. A discordância está na frase «os modelos conseguem corrigir». Um modelo corrige o desempenho se alguém souber onde ele se perde. No nosso build, o problema não estava num algoritmo que alguém pudesse ter escrito melhor, mas num passo em que ninguém pensava até medirmos o tempo de cada etapa. A medição foi feita por uma pessoa; a correção pôde depois ser escrita por um modelo.
Na prática dos sites WordPress passa-se algo parecido: uma loja lenta raramente tem um único algoritmo mau. Tem plugins a mais, consultas sem índice ou cache configurada no sítio errado. Decidir o que remover exige perceber o negócio do cliente, não apenas o profiler.
Os agentes de IA vão acabar com o terminal
«O terminal morreu. A maior parte das ferramentas de desenvolvimento vai ser arrastada pelos tokens. Shells, editores de texto e ferramentas CLI deixarão de ser usados por pessoas.»
(Thorsten Ball, publicação no X de 19 de setembro de 2026, tradução própria)
Avaliação: não concordamos, embora percebamos de onde vem a tese.
O próprio Ball sublinha que o escreve como apaixonado pelo terminal. Tem razão em que as pessoas se lembram cada vez menos das flags do jq. O nosso pipeline mostra, no entanto, que o terminal não desaparece, muda de utilizador. Os agentes trabalham precisamente na shell: correm npm run gates:run, leem ficheiros, chamam git. Cada controlo que apanha os erros deles é um script de linha de comandos.
O terminal torna-se a interface dos agentes e da pessoa que verifica o que o agente fez. Quando um revisor aponta um erro, a forma mais rápida de o confirmar é um único comando grep sobre o ficheiro. A pessoa escreve menos comandos, mas lê mais.
Tokens como novo paradigma de computação
«Os tokens são o novo paradigma de computação. Tudo vai ser refeito sobre eles. […] Estamos a entrar na era pós-binária.»
(Thorsten Ball, publicação no X de 19 de setembro de 2026, tradução própria)
Avaliação: concordamos em parte.
Ball nota que durante 80 anos tivemos computadores determinísticos e confundimos a forma como funcionavam com a forma como têm de funcionar. É uma observação honesta. A nossa experiência acrescenta-lhe uma ressalva: quanto mais trabalho fazem os modelos não determinísticos, mais valem os controlos determinísticos à volta deles.
No nosso pipeline, um agente pode escrever a mesma frase de dez maneiras, mas o controlo conta os títulos sempre da mesma forma. A combinação funciona: o modelo gera, o script verifica. A era pós-binária, se chegar, vai assentar numa base binária de controlo. É-nos difícil imaginar uma implementação responsável em que o modelo se verifica a si próprio sem um critério rígido.
A IA vai substituir gestores de produto e designers
«A tríade PM/Design/Eng vai desaparecer. […] ‘Engenheiros’ que funcionam como ‘proxies de carne’, enfiam tickets em agentes e reportam de volta a pessoas deixarão de ter valor.»
(Thorsten Ball, publicação no X de 19 de setembro de 2026, tradução própria)
Avaliação: concordamos em parte.
A tese dos «proxies de carne» está certa. Um papel que consiste apenas em passar tarefas entre uma pessoa e um agente não tem valor, porque o agente aceita a tarefa diretamente. No nosso pipeline não há intermediário entre o proprietário e os agentes.
As decisões que a tríade repartia não desaparecem, porém, com a divisão de papéis. Alguém continua a ter de decidir o que se constrói e o que não se constrói, como deve ser a interface e se a alteração está pronta. Connosco, essas decisões concentraram-se numa só pessoa em vez de se dissolverem. É mais uma fusão de papéis numa só cabeça do que o seu fim. Daí resulta uma exigência: quem conduz os agentes precisa de competências nas três áreas.
IA em pequenas empresas e em grandes empresas
«A diferença entre a engenharia de software nas grandes empresas e nas pequenas vai aumentar.»
«Algumas pessoas vão ficar de fora da produção de software por causa do preço. […] se não consegue obter tokens suficientes, está a jogar na segunda divisão. Tem de chegar aos tokens.»
(Thorsten Ball, publicação no X de 19 de setembro de 2026, tradução própria)
Avaliação: concordamos em parte com ambas as teses.
Ball escreve que as startups que copiam as práticas da Google vão parecer ainda mais ridículas, porque podem construir mais depressa e com menos restrições. Do ponto de vista de uma equipa pequena, é verdade: o nosso pipeline de agentes não tem comité de arquitetura, e uma vaga de alterações em dezenas de ficheiros passa no mesmo dia. Mas o que nos protege dos erros é exatamente a prática conhecida das grandes empresas: controlos automáticos, revisão independente, um único dono da decisão. Uma empresa pequena pode abdicar do processo, mas não do controlo.
Quanto ao custo dos tokens: o acesso a modelos fortes custa de facto dinheiro, e esse custo cresce com o número de agentes em paralelo. A fronteira não passa, porém, entre ricos e pobres, mas entre quem sabe transformar tokens num resultado verificado e quem paga por texto para deitar fora. O enchimento escrito para o contador de palavras também gastou tokens.
Modelo de IA barato ou inteligente para programar
«É duvidoso que os modelos mais baratos venham a ser usados. […] um modelo mais inteligente comete menos erros e precisa de menos turnos. Quando é que pensa mesmo ‘não me importo que se engane algumas vezes’?»
(Thorsten Ball, publicação no X de 19 de setembro de 2026, tradução própria)
Avaliação: concordamos.
O nosso pipeline tem esta regra escrita nas instruções do repositório. O agente que escreve prosa e traduções trabalha com o modelo predefinido, mais forte. O modelo mais barato trata exclusivamente de revisões só de leitura, e cada apontamento seu é verificado no ficheiro antes de alguém fazer uma correção.
Esta divisão responde diretamente à pergunta de Ball. Um modelo barato é aceitável onde um engano custa uma verificação. Onde um engano vai parar a um texto em produção em seis línguas, a poupança em tokens transforma-se numa revisão mais longa e em mais correções. O que conta é o custo do ciclo inteiro, não o preço de uma chamada.
Código limpo ainda importa com IA
«Não há prova de que o ‘bom código’ vá importar no futuro. A própria noção de ‘bom código’ baseia-se sobretudo na ideia de que é fácil, barato e eficiente para as pessoas trabalharem com ele. Mas as pessoas não vão modificar a maior parte do código.»
(Thorsten Ball, publicação no X de 19 de setembro de 2026, tradução própria)
Avaliação: concordamos em parte.
A largura de 80 colunas não importa, de facto, a um agente. Parte das regras do «código limpo» vai, no entanto, sobreviver por outra razão que não o conforto humano: o código tem de ser verificável. Os nossos controlos só funcionam porque o resultado tem uma estrutura previsível. Frontmatter com um contrato de campos claro, um único dono para cada identificador nos dados estruturados, uma única função que define o endereço de um serviço. Quando dois sítios do código emitiam o mesmo identificador de schema, o problema não era a fealdade, era o facto de nenhum controlo saber qual deles era a fonte de verdade.
«Bom código» deixa de significar «agradável de ler». Passa a significar «cuja correção se pode verificar automaticamente». É uma deslocação, não um fim.
Interfaces geradas por IA em tempo real
«Os modelos vão ficar tão rápidos que a interface será gerada em tempo real. Muita interface existe porque o software não consegue perceber o que se quer.»
(Thorsten Ball, publicação no X de 19 de setembro de 2026, tradução própria)
Avaliação: não temos dados que confirmem ou refutem esta tese.
Ball escreve que menus, ecrãs de definições, painéis e filtros são em grande parte uma interface para a pessoa lidar com uma «máquina burra». A observação é interessante. Não geramos interfaces em tempo real e não temos uma medição que permita avaliar como uma interface dessas se comporta em acessibilidade, previsibilidade e confiança do utilizador. Preferimos dizê-lo a adivinhar.
Uma observação do nosso trabalho: os utilizadores dos sites que construímos continuam a esperar que o botão esteja no mesmo sítio na segunda visita. Uma interface que muda a cada entrada teria de responder de alguma forma a essa necessidade.
Quando é que a IA vai mudar o desenvolvimento de software
«Vai demorar uma geração até o ‘novo software’ substituir o ‘velho software’. […] daqui a 10 anos haverá pessoas empregadas para escrever código. Mas quer ter esse emprego?»
(Thorsten Ball, publicação no X de 19 de setembro de 2026, tradução própria)
Avaliação: concordamos.
Até medir quanto a IA dá aos programadores se revela difícil. A organização METR realizou em 2025 um estudo com grupo de controlo aleatório com programadores experientes de open source a trabalhar nos seus próprios repositórios. Com ferramentas de IA, as tarefas levaram-lhes mais 19 por cento de tempo. Em fevereiro de 2026, a METR descreveu um segundo estudo: para os programadores da primeira edição, a estimativa da variação do tempo por tarefa foi de menos 18 por cento (intervalo de confiança de menos 38 a mais 9 por cento) e, para os novos participantes, de menos 4 por cento. A própria METR considerou, porém, estes dados um sinal pouco fiável, porque cada vez mais programadores recusavam participar por não quererem trabalhar sem IA.
É um bom retrato do período de transição: as ferramentas já estão tão entranhadas no trabalho que é difícil encontrar um grupo de controlo e, ao mesmo tempo, não há um número sólido sobre quanto rendem. Uma geração é uma escala de tempo razoável para uma mudança destas. A pergunta de Ball no fim da nota fica para o leitor.
O que isto significa para empresas que encomendam software
Das 16 teses tiramos quatro conclusões práticas para empresas que encomendam sites, lojas e integrações.
- Pergunte quem revê as afirmações e como, não apenas o código. O código feito com IA compila corretamente. Os erros estão nos factos, nos números das normas, nos nomes das APIs e nos pressupostos de negócio.
- Exija controlos automáticos sobre o resultado. Um teste que verifica a página gerada ou o funcionamento de uma integração apanha uma regressão que não se vê no código-fonte.
- Invista na descrição da tarefa. A maioria dos erros são pedidos mal feitos. Uma boa especificação sai mais barata do que as correções.
- Não poupe no modelo onde o resultado vai para produção. Modelo barato na revisão com verificação, modelo forte onde nasce o conteúdo ou o código.
Se tem um site ou uma aplicação construída à pressa com ajuda de IA e não sabe o que lá está dentro, tratamos da recuperação de sites feitos por IA. Se quer introduzir agentes nos seus próprios processos com o controlo descrito acima, veja a implementação de IA e o desenvolvimento de servidores MCP. O contexto mais amplo, ou seja, porque é que os ganhos da IA chegam mais devagar do que os fornecedores prometem, está no texto sobre o paradoxo da produtividade da IA.
Última atualização: 15 de outubro de 2026.