O que a Google está a testar na barra lateral da pesquisa no computador
A 14 de outubro de 2026 Barry Schwartz escreveu no Search Engine Roundtable que a Google parece estar a testar a barra lateral vertical esquerda do AI Mode na página principal de resultados da pesquisa na web. Nas palavras dele: “Isto coloca o pequeno logótipo super G da Google à esquerda, com as linhas do histórico de conversas, uma forma de iniciar uma conversa com o AI Mode e o ícone de definições, tudo do lado esquerdo” (tradução própria).
Quem o detetou foi Damien Andell, que publicou uma captura de ecrã no X e perguntou: “A barra lateral passou a ser a barra lateral predefinida da Google nas páginas de resultados de pesquisa? Sei que já estava lá quando se clicava no botão AI Mode na página inicial, mas agora é a predefinição em todas as pesquisas” (tradução própria).
Schwartz não o conseguiu reproduzir: “Ainda não consegui replicar isto em nenhum dos meus navegadores, por isso suspeito que seja um teste” (tradução própria). Acrescentou que uma implementação tornaria o AI Mode “ainda mais acessível através da interface principal da pesquisa Google” (tradução própria).
As provas públicas ficam por aqui: a captura de ecrã de um utilizador e um artigo de um site do setor. A Google não publicou qualquer anúncio, página de ajuda ou artigo de blogue sobre este layout. O relato não mostra filtros de temas, seletores de formato nem ligações para secções dentro da barra, por isso qualquer descrição que os inclua vai além das provas.
+-----------------------------------------------------------------------------+
| Página de resultados no computador segundo o relato (teste não confirmado)  |
| +---------------------+  +------------------------------------------------+ |
| | BARRA LATERAL       |  | ÁREA PRINCIPAL DE RESULTADOS                   | |
| | ESQUERDA            |  | Sem alterações, tanto quanto o relato indica   | |
| | - Logótipo "G"      |  |                                                | |
| | - Histórico         |  |                                                | |
| | - Nova conversa     |  |                                                | |
| | - Definições        |  |                                                | |
| +---------------------+  +------------------------------------------------+ |
+-----------------------------------------------------------------------------+A Google confirmou o teste da barra lateral do AI Mode
Não. A 16 de outubro de 2026 as únicas fontes são a captura de ecrã no X e o relato do Search Engine Roundtable. O relato recebeu duas atualizações no mesmo dia. Marie Haynes escreveu primeiro que, ao entrar diretamente no AI Mode, via na barra as suas conversas da aplicação Gemini. Depois corrigiu-se: as conversas vinham da sobreposição do Gemini no seu telemóvel Android, não da aplicação Gemini, e considerou isso “talvez não tão interessante como a aplicação Gemini a fundir-se com o AI Mode” (tradução própria).
Para quem gere um site, isto significa três coisas:
- Ainda não existem dados sobre o layout. Ninguém publicou medições do efeito da barra nos cliques em resultados orgânicos.
- A barra é navegação do próprio produto da Google. Encaminha o utilizador para conversas no AI Mode e para o respetivo histórico. Nada no relato mostra ligações para páginas de terceiros.
- A questão prática é o próprio AI Mode. Se o teste avançar, mais pessoas ficam a um clique do AI Mode. O que conta é a forma como o AI Mode trata e reporta as suas páginas, e isso a Google documenta.
O que a Google diz sobre otimizar para o AI Mode
A página da Google AI features and your website é direta: “Não existem requisitos adicionais para aparecer nas AI Overviews ou no AI Mode, nem outras otimizações especiais necessárias” (tradução própria). Uma página tem de estar indexada e ser elegível para mostrar um excerto na pesquisa.
A mesma página enumera as práticas que, segundo a Google, continuam a aplicar-se:
- rastreio permitido no robots.txt e por qualquer CDN ou camada de alojamento,
- conteúdo encontrável através de ligações internas,
- uma boa experiência na página,
- conteúdo importante disponível em texto,
- imagens e vídeos a apoiar o texto, quando faça sentido,
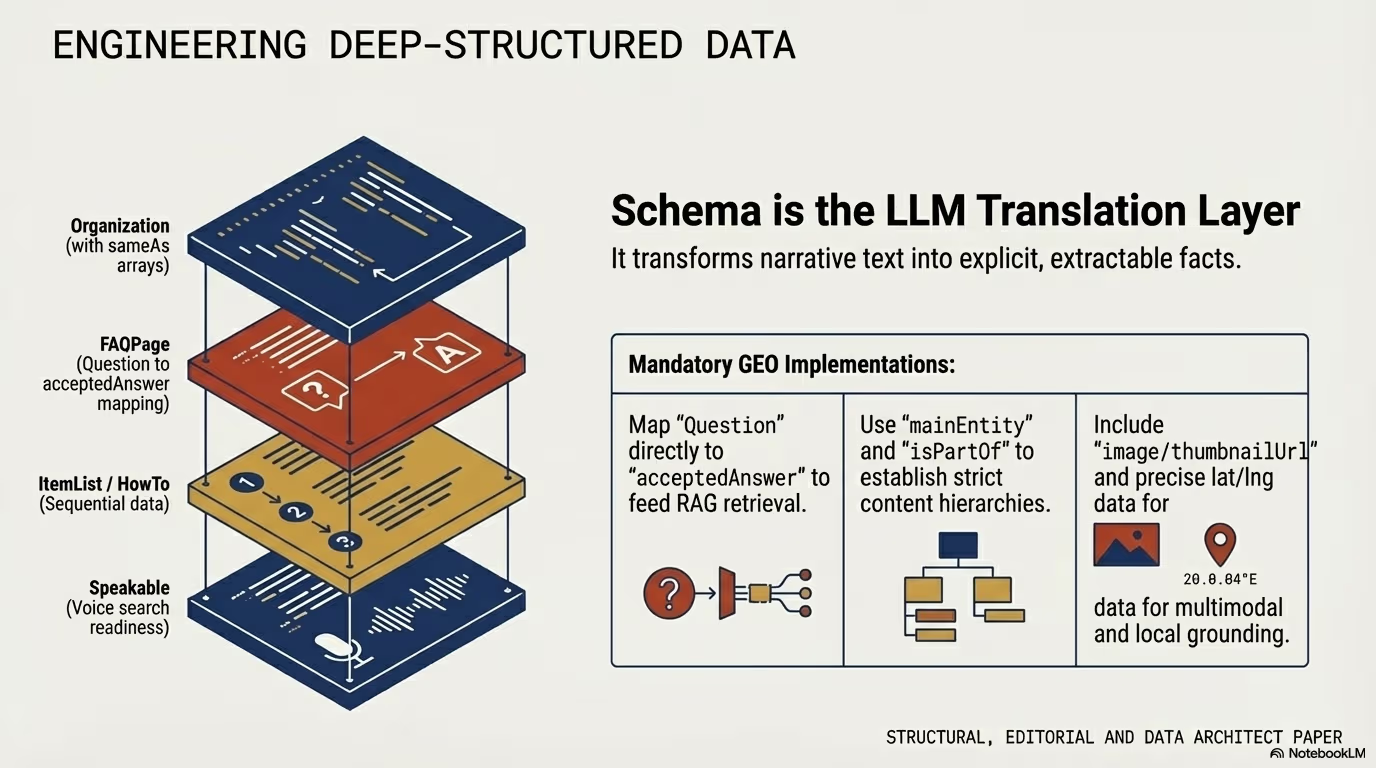
- dados estruturados que correspondam ao texto visível,
- dados atualizados no Merchant Center e no Perfil da Empresa.
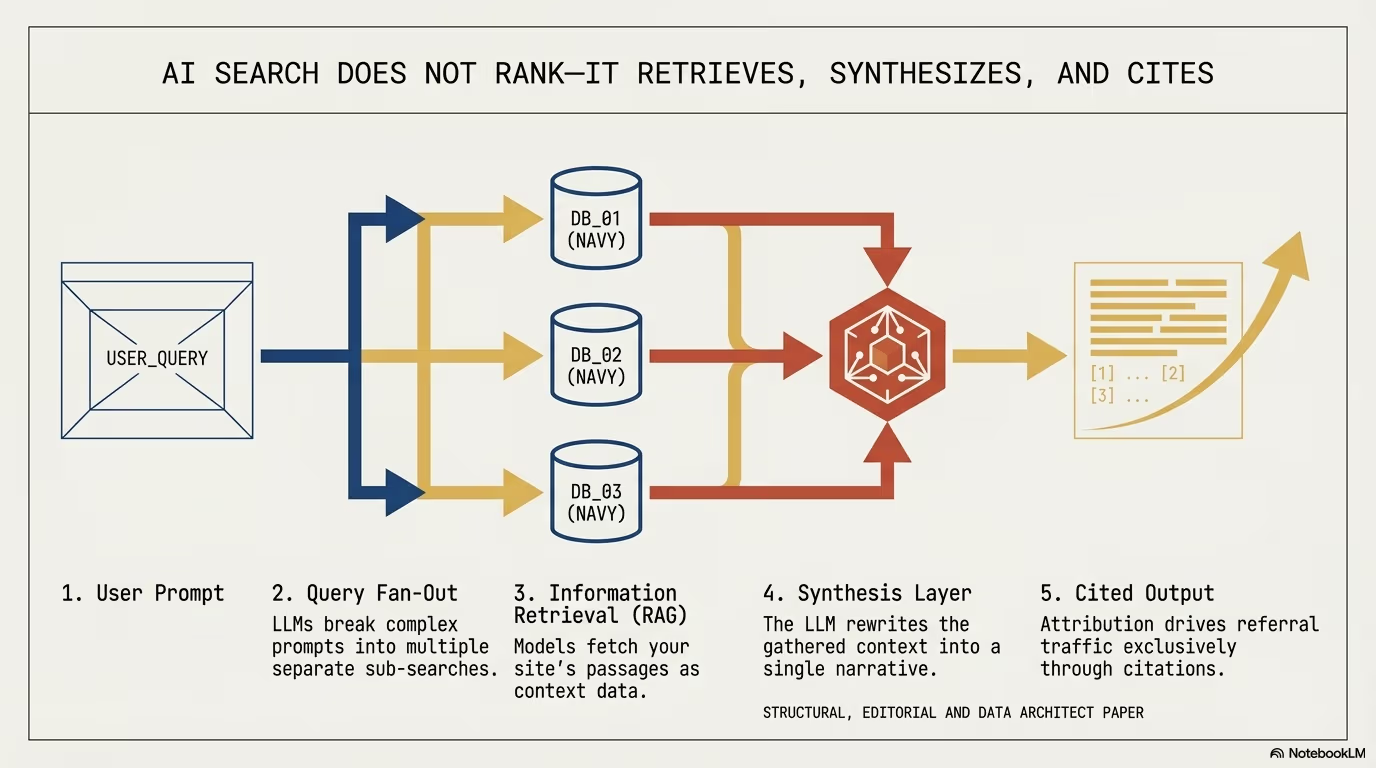
A Google descreve o query fan-out, a técnica por detrás das duas funcionalidades, como “emitir várias pesquisas relacionadas em subtemas e fontes de dados” (tradução própria) para construir uma resposta. O que isso implica para a estrutura das secções está em query fan-out e secções citáveis na pesquisa IA.
Sobre a diferença entre as duas funcionalidades, a Google escreve que o AI Mode “é particularmente útil para consultas em que é necessária mais exploração, raciocínio ou comparações complexas” (tradução própria) e que ambas “podem usar modelos e técnicas diferentes, pelo que o conjunto de respostas e ligações apresentadas vai variar” (tradução própria). Afirma também que os cliques a partir de páginas de resultados com AI Overviews “são de maior qualidade (ou seja, os utilizadores tendem a passar mais tempo no site)” (tradução própria). É uma afirmação da Google; a empresa não publica números que a sustentem.
Num site WordPress, o primeiro ponto da lista é o que mais falha na prática. Plugins de segurança e regras de bots na CDN que desafiam agentes de utilizador desconhecidos podem bloquear também o Googlebot. Verificar o ficheiro robots.txt e os registos da firewall em busca de pedidos do Googlebot faz parte da nossa auditoria de segurança WordPress.
Como aparecem os cliques e impressões do AI Mode na Search Console
O tráfego do AI Mode não tem relatório próprio. A página da Google sobre funcionalidades de IA indica que é reportado no relatório de Desempenho, dentro do tipo de pesquisa “Web”. O artigo de ajuda sobre impressões, posição e cliques define a contagem:
| Elemento | Clique | Impressão | Posição |
|---|---|---|---|
| AI Mode | Conta o clique numa ligação para uma página externa | Regras normais de impressão | Mesmo método de uma página de resultados normal |
| AI Overview | Conta o clique numa ligação para uma página externa | Regras normais de impressão | Toda a vista geral ocupa uma única posição, partilhada por todas as suas ligações |
Há mais duas regras importantes na leitura dos dados. Uma pergunta de seguimento no AI Mode é tratada como uma nova consulta, por isso as impressões e cliques dela são atribuídos a essa consulta e não à primeira. E os dados das experiências do Search Labs não são incluídos de todo. Se a barra lateral ainda for um teste, as impressões nela podem não constar do seu relatório.
A Search Console atribui ainda os dados ao URL canónico escolhido pela Google, não ao endereço exato em que o visitante clicou. Uma ligação para /guia/#passo-3 é reportada em /guia/. O fragmento também não chega ao servidor, porque os navegadores não o enviam no pedido. O único sítio onde se vê a que secção o visitante chegou é o JavaScript do lado do cliente que lê location.hash ao carregar a página e o envia para a sua ferramenta de análise.
Como a Google liga a uma secção específica de uma página
O mecanismo que a Google documenta é a ligação profunda “Read more”. A documentação sobre excertos define-a como “uma ligação dentro de um excerto que leva os utilizadores a uma secção específica dessa página” (tradução própria). A Google indica três práticas que tornam estas ligações mais prováveis:
- O conteúdo tem de estar imediatamente visível para uma pessoa, “e não escondido atrás de uma secção expansível ou de uma interface com separadores” (tradução própria).
- Evite JavaScript que controle a posição de deslocamento ao carregar a página, por exemplo forçando o utilizador a voltar ao topo.
- Se a página fizer chamadas à History API ou alterar
window.location.hashao carregar, não pode remover o fragmento hash do URL, “pois isso quebra o funcionamento das ligações profundas” (tradução própria).
Cada regra corresponde a algo comum em sites WordPress:
- Acordeões e separadores. Blocos de FAQ, widgets de separadores de construtores de páginas e caixas “mostrar mais” escondem texto ao carregar. O conteúdo para o qual a Google possa querer criar uma ligação profunda deve estar no fluxo normal da página.
- Scripts de deslocamento. Alguns temas e plugins de deslocamento suave chamam
window.scrollTo(0, 0)ao carregar ou animam a página até ao topo. Isso anula o salto do navegador para o alvo. - Limpeza do hash. Temas de página única e alguns banners de cookies reescrevem o URL com
history.replaceState()para remover#secção. É exatamente isso que a Google diz quebrar as ligações profundas.
Um teste rápido: abra um artigo longo com #um-cabecalho acrescentado, recarregue e confirme que o navegador fica nesse cabeçalho e que o hash continua na barra de endereço.
Como adicionar IDs aos cabeçalhos no WordPress automaticamente
O editor de blocos tem suporte nativo. Um bloco que declare anchor: true nos seus supports recebe um campo para um ID, e a referência de block supports descreve-o assim: “As âncoras permitem ligar diretamente a um bloco específico de uma página” (tradução própria). O bloco Cabeçalho do núcleo tem esta opção em Avançadas > Âncora HTML. Os editores raramente a preenchem, pelo que os arquivos longos acabam com cabeçalhos para os quais não é possível criar ligações.
O filtro seguinte acrescenta um id normalizado a cada H2 e H3 que não o tenha, no momento da apresentação, sem alterar o conteúdo guardado:
add_filter('the_content', function ($content) {
    if (!is_singular('post')) {
        return $content;
    }

    return preg_replace_callback('/<h([2-3])(.*?)>(.*?)<\/h\1>/i', function ($matches) {
        $tag_level = $matches[1];
        $attributes = $matches[2];
        $heading_text = $matches[3];

        // Manter os IDs definidos manualmente
        if (preg_match('/id=[\'"][^\'"]+[\'"]/i', $attributes)) {
            return $matches[0];
        }

        // Remover etiquetas HTML para obter um slug de âncora limpo
        $plain_text = wp_strip_all_tags($heading_text);
        $slug = sanitize_title($plain_text);

        if (empty($slug)) {
            return $matches[0];
        }

        return sprintf('<h%d%s id="%s">%s</h%d>', $tag_level, $attributes, esc_attr($slug), $heading_text, $tag_level);
    }, $content);
}, 20);
Cada cabeçalho passa a ter um URL de fragmento estável, como #configuracao-do-buffer-da-base-de-dados. Há dois limites. Dois cabeçalhos com o mesmo texto recebem o mesmo ID, por isso um artigo com cabeçalhos repetidos precisa de um contador acrescentado. E mudar a redação de um cabeçalho muda o seu ID, o que quebra qualquer ligação para a versão antiga; defina uma âncora HTML manual nos cabeçalhos para os quais outras páginas apontam.
As âncoras ajudam os leitores, os índices e as ligações de outros sites. A Google não diz que as ligações profundas “Read more” exigem IDs, por isso trate-as como boa estrutura e não como um interruptor de classificação.
Como se comportam as ligações com fragmento de texto numa página WordPress
As ligações dos resultados de pesquisa para uma passagem usam muitas vezes um fragmento de texto em vez de um ID. O MDN documenta a sintaxe como #:~:text=[prefix-,]textStart[,textEnd][,-suffix]. O navegador procura esse texto na página, desloca-se até ele e realça-o. Não é preciso qualquer ID do seu lado.
Alguns pormenores do MDN que afetam sites WordPress:
- A parte
:~:é a diretiva de fragmento. Os navegadores removem-na do URL durante o carregamento, “para que os scripts do autor não possam interagir diretamente com ela” (tradução própria). A sua ferramenta de análise não a vê emlocation.hash. - Os fragmentos de texto “só são acionados em navegações iniciadas pelo utilizador” (tradução própria) e apenas na moldura principal, nunca dentro de um
<iframe>. - Se o texto não corresponder a nada na página, o fragmento é ignorado e a página abre no topo. Texto diferente entre a versão indexada e a versão atual, por exemplo depois de uma edição ou por causa de conteúdo personalizado, quebra a ligação sem aviso.
- O realce pode ser estilizado com o pseudoelemento
::target-text, edocument.fragmentDirectivesó existe nos navegadores que suportam a funcionalidade. - Os navegadores baseados em Chromium respeitam o cabeçalho
Document-Policy: force-load-at-top, que desativa o deslocamento para fragmentos. Não o defina em páginas de conteúdo, a não ser que seja isso que pretende.
Os fragmentos de texto são mais uma razão para manter os parágrafos como texto real no HTML. Uma passagem desenhada por JavaScript depois do carregamento, ou dividida em elementos inline por um construtor de páginas, pode não corresponder.
Como otimizar as Core Web Vitals em visitas que chegam por âncoras
Quando um visitante segue uma ligação com fragmento, o navegador desloca-se diretamente para o elemento de destino. Esse salto expõe a página ao Cumulative Layout Shift (CLS).
Se os elementos acima do destino carregarem sem dimensões reservadas:
- espaços para banners sem
min-height, - imagens sem os atributos
widtheheight, - scripts de terceiros incorporados e leitores multimédia,
são desenhados tarde e empurram o documento para baixo. Um visitante que já começou a ler o parágrafo de destino perde o sítio onde estava.
Configuração de CSS para um deslocamento estável até às âncoras
html {
  /* Transições suaves para âncoras de fragmento */
  scroll-behavior: smooth;
}

/* Margem superior para que um cabeçalho fixo não tape o destino */
[id] {
  scroll-margin-top: 5rem;
}

/* Reservar altura mínima para multimédia e banners no topo da página */
.ad-slot-header {
  min-height: 250px;
  contain: layout;
}

img {
  max-width: 100%;
  height: auto;
  display: block;
}
scroll-margin-top define a margem superior da área de deslocamento, para que o navegador pare acima do cabeçalho em vez de o esconder debaixo de um menu fixo. Ajuste o valor à altura real do cabeçalho do site, incluindo a barra de administração para utilizadores com sessão iniciada.
No servidor (Nginx ou Cloudflare), tempos de cache longos para tipos de letra e folhas de estilo evitam que o layout mude durante o salto:
# Cache longa para recursos estáticos, para o salto ser desenhado com os estilos finais
location ~* \.(woff2|ttf|svg|css|js)$ {
    expires 1y;
    add_header Cache-Control "public, no-transform, immutable";
    access_log off;
}
immutable só é seguro quando o endereço do recurso muda a cada versão. O WordPress acrescenta um parâmetro ?ver= aos ficheiros colocados em fila, por isso funciona desde que o tema ou o plugin aumente o número de versão.
Como implementar a estrutura haspart do schema org
O Schema.org define hasPart para indicar as partes de uma obra. Em JSON-LD pode declarar as secções de um artigo como elementos WebPageElement, cada um com o seu URL de fragmento:
add_action('wp_head', function () {
    if (!is_singular('post')) {
        return;
    }

    global $post;
    $permalink = get_permalink($post->ID);

    // Secções principais do artigo
    $sections = [
        [
            'name' => 'Requisitos técnicos da integração com ERP',
            'anchor' => 'requisitos-tecnicos-da-integracao-com-erp',
            'description' => 'Largura de banda, formato de dados JSON e autenticação OAuth2.'
        ],
        [
            'name' => 'Eliminar bloqueios mútuos na base de dados',
            'anchor' => 'eliminar-bloqueios-mutuos-na-base-de-dados',
            'description' => 'Tabelas HPOS e afinação das filas assíncronas do Action Scheduler.'
        ]
    ];

    $parts = [];
    foreach ($sections as $sec) {
        $parts[] = [
            '@type' => 'WebPageElement',
            'name' => $sec['name'],
            'url' => $permalink . '#' . $sec['anchor'],
            'description' => $sec['description']
        ];
    }

    $schema = [
        '@context' => 'https://schema.org',
        '@type' => 'TechArticle',
        '@id' => $permalink . '#article',
        'headline' => get_the_title($post->ID),
        'inLanguage' => 'pt-PT',
        'mainEntityOfPage' => $permalink,
        'hasPart' => $parts
    ];

    echo "\n" . '<script type="application/ld+json">' . "\n";
    echo wp_json_encode($schema, JSON_UNESCAPED_SLASHES | JSON_UNESCAPED_UNICODE | JSON_PRETTY_PRINT);
    echo "\n" . '</script>' . "\n";
}, 25);
As secções do exemplo são marcadores de posição de um artigo sobre integração WooCommerce com ERP; em produção devem vir dos cabeçalhos reais do artigo. Este markup é Schema.org válido, mas a Google não documenta nenhuma funcionalidade de pesquisa que use hasPart com WebPageElement para ligações a secções. A utilização documentada de hasPart pela Google é a marcação de secções com acesso pago. Aplica-se a regra da página sobre funcionalidades de IA: os dados estruturados têm de corresponder ao texto visível, por isso cada nome e âncora da lista tem de existir na página.
Como limitar o que o AI Mode pode citar de uma página WordPress
A documentação da meta tag robots enumera os controlos, e a página sobre funcionalidades de IA indica os mesmos para as AI Overviews e o AI Mode:
nosnippetaplica-se “a todas as formas de resultados de pesquisa (na Google: pesquisa na web, Google Imagens, Discover, AI Overviews, AI Mode)” (tradução própria).max-snippet:[number]limita o comprimento do excerto em carateres e “também limita a quantidade de conteúdo que pode ser usada como entrada direta para as AI Overviews e o AI Mode” (tradução própria).0equivale anosnippet,-1deixa a escolha à Google.data-nosnippetexclui parte de uma página e funciona nos elementosspan,divesection.noindexremove a página da pesquisa por completo.
O WordPress gera a meta tag robots através do filtro wp_robots desde a versão 5.7. Um limite de excerto para um tipo de conteúdo fica assim:
add_filter('wp_robots', function ($robots) {
    if (is_singular('product')) {
        $robots['max-snippet'] = '160';
    }
    return $robots;
});
data-nosnippet vai diretamente no markup, por exemplo num bloco HTML personalizado: <div data-nosnippet>nota interna sobre preços</div>. Estes controlos reduzem a visibilidade, não apenas a reutilização. Uma página que bloqueia excertos perde também o excerto de texto nos resultados normais, por isso use-os em passagens concretas e não no site inteiro.
A regra do primeiro parágrafo para excertos e ligações profundas
HTML limpo não ajuda se o texto dificultar a extração. Excertos, ligações “Read more” e respostas de IA aproveitam passagens curtas, e uma passagem que responde ao cabeçalho na primeira frase mantém o sentido fora do contexto.
- Primeira frase a seguir ao H2: resposta direta à pergunta do cabeçalho. Evite aberturas como Nesta secção vamos analisar….
- Segunda frase: o número, parâmetro ou limite verificável.
- Parágrafos seguintes: compromissos, código e tabelas.
Secções construídas assim funcionam também para quem chega a meio da página, que é o que acontece com qualquer ligação com fragmento.
Que mecanismos da Google ligam a uma secção da sua página
| Mecanismo | Quem cria a ligação | Forma do URL | O que o site controla |
|---|---|---|---|
| Ligação profunda “Read more” no excerto | URL da página a apontar para uma secção | Conteúdo visível, nenhum deslocamento forçado, hash mantido | |
| Fragmento de texto | Google ou qualquer site que crie a ligação | #:~:text=... | Texto presente no HTML e igual à versão indexada |
| Âncora de cabeçalho | O site, outros sites, índices | #id-do-cabecalho | IDs estáveis, âncoras manuais nos cabeçalhos com ligações |
| Citação no AI Mode ou numa AI Overview | URL da página, por vezes com fragmento | Indexação, elegibilidade para excerto, controlos de excerto |
Roteiro para adaptar o seu site WordPress ao novo layout de resultados
- Verificar o acesso de rastreio:
- Confirme que o robots.txt, a CDN e os plugins de segurança deixam passar o Googlebot.
- Testar ligações profundas nas páginas principais:
- Abra cada uma com
#id-do-cabecalhoe com um fragmento de texto, recarregue e confirme que o navegador fica no destino e mantém o hash. - Remova scripts que desloquem para o topo ou limpem o hash ao carregar.
- Abra cada uma com
- Completar as âncoras dos cabeçalhos:
- Adicione o filtro de IDs e depois defina âncoras HTML manuais nos cabeçalhos para os quais outras páginas apontam.
- Estabilizar o layout acima das secções:
- Reserve dimensões para imagens, anúncios e incorporações, e defina
scroll-margin-topcom a altura do cabeçalho.
- Reserve dimensões para imagens, anúncios e incorporações, e defina
- Manter os dados estruturados fiéis ao conteúdo:
- Se usar
hasPart, gere-o a partir dos cabeçalhos reais.
- Se usar
- Medir no sítio certo:
- Leia os cliques do AI Mode no relatório de Desempenho da Search Console, em “Web”, lembrando que os fragmentos não são reportados aí.
- Registe
location.hashà entrada na sua ferramenta de análise para ver que âncoras com ID trazem visitantes.
- Aguardar confirmação:
- Enquanto a Google não documentar a barra lateral, planeie para o AI Mode tal como existe hoje e não para um layout não confirmado.