Um pedido cujo user agent diz Googlebot prova apenas que alguém escreveu a palavra Googlebot num cabeçalho. O teste que conta é o endereço IP: tem de constar da lista que a Google publica, ou passar uma consulta de DNS reverso seguida de uma consulta direta que devolve o mesmo endereço. Este guia vai de um grep de uma linha no registo de acessos até uma regra que bloqueia os impostores sem tocar no rastreador verdadeiro, com uma variante para cada sítio onde o seu WordPress pode estar: Cloudflare, alojamento partilhado com .htaccess ou servidor próprio com nginx.
O motivo para olhar para isto agora: a 30 de outubro de 2026, o Search Engine Roundtable publicou um resumo de uma entrevista a Gary Illyes, da Google, no Odys Podcast, em que ele liga o aumento de bots que se fazem passar por outros à IA. Se o seu site está atrás do Cloudflare, leia também o meu artigo anterior sobre se o Cloudflare bloqueia o Googlebot. Esse texto trata das definições de bots de IA, do Bot Fight Mode e do que um 403 faz às páginas indexadas. Este trata do passo anterior: saber quem está realmente a bater à porta.
Todos os comandos e configurações abaixo foram executados a 30 de outubro de 2026 contra os ficheiros da Google em produção, com nginx 1.27.2 e Apache 2.4.63 numa máquina de teste. Quando não consegui testar algo num servidor real, digo-o.
Porque é que há cada vez mais Googlebots falsos?
Barry Schwartz, do Search Engine Roundtable, resumiu a conversa entre Illyes e a apresentadora do podcast, Aneta Samkoff. Perante a pergunta sobre porque é que a usurpação de identidade se tornou um problema tão grande, Illyes respondeu:
“Acho que é a IA.”
Gary Illyes, citado pelo Search Engine Roundtable, 30 de outubro de 2026; episódio no YouTube, Odys Podcast (tradução própria)
O raciocínio, tal como o Search Engine Roundtable o cita: as empresas procuram conteúdo para treinar modelos, as firewalls e as CDN ficaram melhores a identificar rastreadores mas continuam longe da perfeição, e um pequeno motor de IA ou um scraper que diga ser o Googlebot acaba muitas vezes por entrar onde, de outra forma, seria bloqueado. Segundo o mesmo resumo, Illyes mantém armadilhas (honeypots) para rastreadores e viu nelas pedidos que se apresentavam como Googlebot a partir de IP sem qualquer relação com a Google. O título do episódio fala em cerca de 30 segundos para fingir ser o Googlebot, o que bate certo com a prática: o user agent é um cabeçalho que o próprio cliente define.
Não encontrei uma transcrição do episódio, por isso tudo o que atribuo a Illyes passa pelo texto do Search Engine Roundtable.
A lógica do impostor é simples. Quem bloqueia scrapers abre quase sempre uma exceção para o Googlebot, porque ninguém quer desaparecer da Google. Uma regra do tipo “deixar passar o Googlebot” sem verificar o IP é, por isso, uma porta aberta com uma placa por cima. A própria ajuda do Search Console diz o mesmo noutro contexto: dar acesso ao Googlebot sem login a uma página protegida retira-lhe, na prática, a segurança, porque o Googlebot pode ser falsificado (Ajuda do Search Console, relatório Estatísticas de rastreio).
Onde encontro o registo de acessos do meu alojamento?
Num servidor próprio (VPS) com nginx, o ficheiro costuma estar em /var/log/nginx/access.log. Com Apache, em /var/log/apache2/access.log nas distribuições Debian e Ubuntu, ou em /var/log/httpd/access_log na família RHEL.
Num alojamento partilhado não tem acesso a essas pastas, mas o painel de controlo deixa descarregar o registo em bruto. No cPanel, a opção chama-se Raw Access e está na secção de métricas; no Plesk, procure a ferramenta de registos do domínio. O formato é quase sempre o mesmo, o “combined”: IP, data, pedido, código de resposta, tamanho, referer e user agent. Descarregue pelo menos uma semana, porque um único dia esconde padrões.
Se o painel não mostrar nada disto, pergunte ao suporte do alojamento onde fica o registo de acessos em bruto e por quantos dias é guardado. Sem esse ficheiro, o resto deste guia só funciona ao nível do Cloudflare.
Como encontro os pedidos que dizem ser o Googlebot?
Comece pelos números. Este comando lista os IP que enviaram um user agent com Googlebot, do mais ativo para o menos ativo:
grep -i 'googlebot' /var/log/nginx/access.log | awk '{print $1}' | sort | uniq -c | sort -rn | head -20Num ficheiro descarregado do painel, troque o caminho pelo nome do ficheiro local. Para ver o que cada um desses IP pediu, imprima o endereço ao lado da linha do pedido:
awk -F'"' 'tolower($6) ~ /googlebot/ {split($1,a," "); print a[1], $2}' /var/log/nginx/access.log | head -50Um exemplo construído, com endereços de documentação do RFC 5737 em vez de tráfego real, mostra o padrão a procurar:
66.249.66.1 GET / HTTP/1.1
203.0.113.7 GET /wp-login.php HTTP/1.1
203.0.113.7 GET /?s=test HTTP/1.1
O Googlebot verdadeiro raramente tem motivo para pedir wp-login.php, xmlrpc.php ou uma sequência interminável de URL da pesquisa interna. Um “Googlebot” que o faça merece ser verificado primeiro. Numa loja WooCommerce, outro sinal é o mesmo IP a percorrer todas as páginas de produto em poucos minutos, com e sem parâmetros de filtro. O padrão de URL diz-lhe por onde começar; quem decide é o IP.
Zach Chahalis defende o mesmo no guia da Moz sobre análise de registos para a pesquisa com IA, publicado a 29 de outubro de 2026: o user agent é apenas o nome que o próprio pedido escolhe dar-se, os scrapers inflacionam os números e as regras de segurança feitas para travar bots falsos podem travar também os verdadeiros (Moz, How To Analyze Server Logs for AI Search). Ele recomenda ativar a verificação de bots logo na importação dos registos, por exemplo a opção Verify Bots When Importing Logs do Log File Analyser da Screaming Frog, para que os impostores nunca cheguem aos gráficos.
Como verifico um IP do Googlebot com host ou dig?
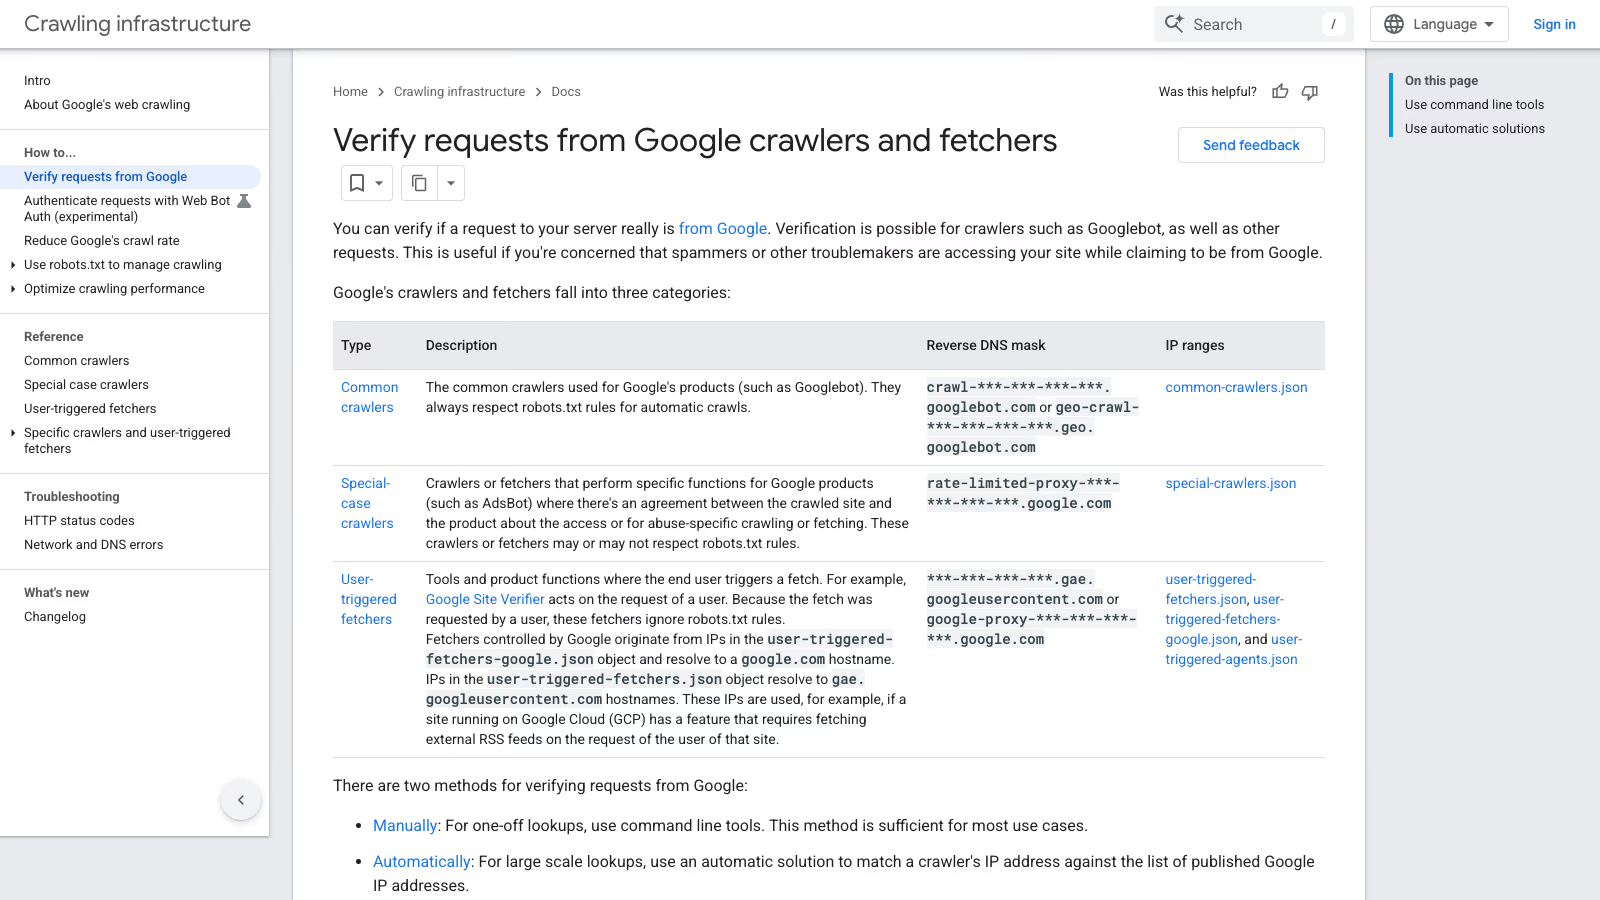
A Google descreve uma verificação manual em quatro passos (Google Crawling Infrastructure, Verify requests from Google crawlers and fetchers):
- Fazer uma consulta de DNS reverso ao IP do registo com o comando
host. - Confirmar que o nome termina em
googlebot.com,google.comougoogleusercontent.com. - Fazer uma consulta de DNS direta a esse nome.
- Confirmar que devolve o IP original.
Foi isto que obtive a 30 de outubro de 2026 com um dos endereços de exemplo da própria Google:
$ host 66.249.66.1
1.66.249.66.in-addr.arpa domain name pointer crawl-66-249-66-1.googlebot.com.
$ host crawl-66-249-66-1.googlebot.com
crawl-66-249-66-1.googlebot.com has address 66.249.66.1
O passo direto não é opcional. Quem controla um bloco de IP pode pôr no DNS reverso o nome que quiser, incluindo crawl-1-2-3-4.googlebot.com. Não consegue é obrigar os servidores de DNS da Google a responder à consulta direta com o seu endereço. Os comandos dig +short -x 66.249.66.1 e dig +short crawl-66-249-66-1.googlebot.com dão as mesmas respostas numa forma mais curta.
Para mais do que meia dúzia de IP, ponha a verificação num ciclo. Este script aceita nomes da Google e do Bing; corri-o a 30 de outubro de 2026 contra endereços da Google, do Bing e dois que não são rastreadores:
#!/usr/bin/env bash
# Two-way DNS check for an IP that claims to be Googlebot or Bingbot.
# Usage: ./verify_dns.sh 66.249.66.1 [more IPs]
for ip in "$@"; do
  name=$(host "$ip" | awk '/domain name pointer/ {print $NF; exit}')
  name=${name%.}
  case "$name" in
    *.googlebot.com|*.google.com|*.googleusercontent.com|*.search.msn.com) ;;
    *) echo "$ip FAKE: PTR is '${name:-none}'"; continue ;;
  esac
  if host "$name" | grep -qwF -- "$ip"; then
    echo "$ip OK: $name"
  else
    echo "$ip FAKE: $name does not resolve back to $ip"
  fi
done
Resultado nesse dia: 66.249.66.1 OK: crawl-66-249-66-1.googlebot.com, 157.55.39.1 OK: msnbot-157-55-39-1.search.msn.com e 8.8.8.8 FAKE: PTR is 'dns.google'. Há três limites. O comando host vem do pacote dnsutils em Debian e Ubuntu e do bind-utils na família RHEL. FAKE significa apenas que o IP não é da Google nem do Bing, por isso corra o script só com IP que se apresentaram como rastreador, e não com o registo inteiro. E os endereços IPv6 podem ser escritos de várias formas válidas, pelo que a comparação de texto pode falhar uma correspondência; para IPv6, use o método da lista de IP descrito mais abaixo.
Que nome de anfitrião corresponde a cada tipo de rastreador da Google?
A Google divide o seu tráfego em três grupos, cada um com o seu padrão de nome e o seu ficheiro de IP (Google, Verify requests):
| Grupo | Exemplos | robots.txt | DNS reverso | Ficheiro de IP |
|---|---|---|---|---|
| Rastreadores comuns | Googlebot, Googlebot-Image, Google-InspectionTool | Respeitado sempre nos rastreios automáticos | crawl-***-***-***-***.googlebot.com ou geo-crawl-***-***-***-***.geo.googlebot.com | common-crawlers.json |
| Rastreadores especiais | AdsBot | Pode ou não ser respeitado | rate-limited-proxy-***-***-***-***.google.com | special-crawlers.json |
| Pedidos iniciados por utilizadores | Google Site Verifier, Feedfetcher, Google-Agent | Ignorado, porque foi uma pessoa a pedir | ***-***-***-***.gae.googleusercontent.com ou google-proxy-***-***-***-***.google.com | user-triggered-fetchers.json, user-triggered-fetchers-google.json, user-triggered-agents.json |
A tabela importa por uma razão prática: um pedido com user agent de Googlebot deve vir da primeira linha. Se resolver para gae.googleusercontent.com, passou o segundo passo da verificação manual e, mesmo assim, não é o Googlebot. A Google explica que os IP do user-triggered-fetchers.json resolvem para gae.googleusercontent.com e são usados, por exemplo, quando um site alojado no Google Cloud vai buscar um feed RSS externo a pedido de um dos seus utilizadores. É um pedido legítimo, só que não é o rastreador da pesquisa.
Que lista de IP da Google devo usar e o que aconteceu ao googlebot.json?
A Google publica cinco ficheiros JSON em formato CIDR em https://developers.google.com/static/crawling/ipranges/. A 30 de outubro de 2026 tinham estes números de prefixos (mudam com o tempo, por isso trate a contagem como uma fotografia do dia):
| Ficheiro | Prefixos a 30.10.2026 | Para que serve |
|---|---|---|
common-crawlers.json | 317 | Googlebot e os outros rastreadores comuns |
special-crawlers.json | 272 | AdsBot e outros rastreadores especiais |
user-triggered-fetchers.json | 1068 | Pedidos feitos por utilizadores de sites no Google Cloud |
user-triggered-fetchers-google.json | 504 | Pedidos iniciados por utilizadores em serviços da própria Google |
user-triggered-agents.json | 20 | Google-Agent e agentes semelhantes |
Se escreveu um script há alguns anos, provavelmente descarrega o googlebot.json. A 30 de outubro de 2026, o endereço antigo https://developers.google.com/search/apis/ipranges/googlebot.json devolvia um redirecionamento 301 para o common-crawlers.json, enquanto https://developers.google.com/static/crawling/ipranges/googlebot.json devolvia 404. Um script que segue redirecionamentos continua a funcionar; um que tenha sido fixado no caminho mais recente, ou que trate qualquer resposta diferente de 200 como lista vazia, deixa de funcionar. Confirme o seu. Uma lista de permissões vazia transforma “bloquear o Googlebot falso” em “bloquear o Googlebot”.
Para outros serviços da Google que possam chamar o seu site (o Apps Script, por exemplo), a Google remete para a lista geral em https://www.gstatic.com/ipranges/goog.json.
O Bing e a OpenAI publicam ficheiros com a mesma estrutura: um creationTime e uma lista prefixes com entradas ipv4Prefix ou ipv6Prefix. Um único script consegue, por isso, verificar todos. Este usa apenas a biblioteca padrão do Python:
#!/usr/bin/env python3
"""Check IPs against the crawler IP lists Google, Bing and OpenAI publish.

Usage: python3 verify_bot_ip.py 66.249.66.1 157.55.39.1 1.2.3.4
       awk '{print $1}' access.log | sort -u | python3 verify_bot_ip.py -
"""
import ipaddress
import json
import sys
import urllib.request

LISTS = {
    "google-common": "https://developers.google.com/static/crawling/ipranges/common-crawlers.json",
    "google-special": "https://developers.google.com/static/crawling/ipranges/special-crawlers.json",
    "google-user-fetchers": "https://developers.google.com/static/crawling/ipranges/user-triggered-fetchers.json",
    "google-user-fetchers-google": "https://developers.google.com/static/crawling/ipranges/user-triggered-fetchers-google.json",
    "google-user-agents": "https://developers.google.com/static/crawling/ipranges/user-triggered-agents.json",
    "bingbot": "https://www.bing.com/toolbox/bingbot.json",
    "openai-gptbot": "https://openai.com/gptbot.json",
    "openai-searchbot": "https://openai.com/searchbot.json",
    "openai-chatgpt-user": "https://openai.com/chatgpt-user.json",
}


def load(url):
    with urllib.request.urlopen(url, timeout=20) as r:
        data = json.load(r)
    return [
        ipaddress.ip_network(p.get("ipv4Prefix") or p.get("ipv6Prefix"))
        for p in data["prefixes"]
    ]


def main(args):
    ips = [l.strip() for l in sys.stdin] if args == ["-"] else args
    nets = {name: load(url) for name, url in LISTS.items()}
    for raw in filter(None, ips):
        try:
            ip = ipaddress.ip_address(raw)
        except ValueError:
            print(f"{raw}\tnot an IP")
            continue
        hits = [n for n, ranges in nets.items() if any(ip in net for net in ranges)]
        print(f"{ip}\t{', '.join(hits) or 'NOT IN ANY LIST'}")


if __name__ == "__main__":
    main(sys.argv[1:])
Passe-lhe todos os IP que se apresentaram como Googlebot:
grep -i 'googlebot' /var/log/nginx/access.log | awk '{print $1}' | sort -u | python3 verify_bot_ip.py -A 30 de outubro de 2026 respondeu 66.249.66.1 google-common, 66.249.90.77 google-special, 157.55.39.1 bingbot e 8.8.8.8 NOT IN ANY LIST, e tratou bem o IPv6 (2001:4860:4801:10::1 google-common). O script descarrega nove ficheiros em cada execução, por isso corra-o à mão ou a partir do cron. Nunca o chame a cada pedido. Se está num alojamento partilhado sem Python, corra-o no seu computador sobre o registo descarregado do painel: o resultado é o mesmo.
Porque é que um IP real do Googlebot às vezes falha a verificação do nome?
Durante os testes corri também o segundo exemplo da Google, 35.247.243.240. A página da Google diz que resolve para geo-crawl-35-247-243-240.geo.googlebot.com. A 30 de outubro de 2026, tanto o resolvedor do meu sistema como o 8.8.8.8 público da Google devolveram 240.243.247.35.bc.googleusercontent.com. O endereço vizinho, 35.247.243.241, devolveu o nome documentado geo-crawl-35-247-243-241.geo.googlebot.com, e o 35.247.243.240 está dentro de 35.247.243.240/28 no common-crawlers.json.
Não sei porque é que aquele endereço tem um registo PTR diferente, e é uma única observação. Uma regra que aceite apenas nomes *.googlebot.com teria rejeitado um IP que a Google lista como rastreador comum. Uma regra que aceite qualquer nome em googleusercontent.com deixaria passar pedidos iniciados por utilizadores que não são o Googlebot. Para um pedido com user agent de Googlebot, o teste decisivo é a presença no common-crawlers.json. Guarde o método DNS para verificações pontuais, que é como a própria Google o apresenta: suficiente para consultas isoladas, com as listas de IP recomendadas para verificação em grande escala.
Como bloqueio o Googlebot falso no Cloudflare?
Se o site está atrás do Cloudflare, a borda da rede é o melhor sítio para a regra, porque o Cloudflare já verifica os bots por si. É também a única camada realista para muitos sites em alojamento partilhado, onde não há acesso à configuração do servidor. O campo cf.client.bot indica se o pedido veio de um bot ou rastreador conhecido e de confiança (Cloudflare Docs, cf.client.bot). O Cloudflare considera um bot verificado quando ele se identifica com uma assinatura Web Bot Auth, com uma lista de IP publicada e um user agent estável, ou por DNS reverso, e quando se comporta dentro de limites razoáveis (Cloudflare Docs, Verified bots).
Uma regra personalizada (custom rule) para Googlebots falsos:
(lower(http.user_agent) contains "googlebot" and not cf.client.bot)O lower() está lá porque a comparação de texto na linguagem de regras do Cloudflare distingue maiúsculas de minúsculas (Cloudflare Docs, Functions). O exemplo do próprio Cloudflare para este padrão combina um filtro por país com not cf.client.bot e um Managed Challenge (Cloudflare Docs, Allow traffic from search engine bots).
Não pus esta expressão em produção numa zona real, por isso trate-a como ponto de partida. Antes de escolher a ação de bloqueio, use a expressão como filtro no Security Analytics ou comece com Managed Challenge, e confirme que nenhum pedido vindo de um IP do common-crawlers.json corresponde à regra. Se um dia o Cloudflare não reconhecer um pedido real do Googlebot e a sua regra disser bloquear, a Google recebe um 403. A Google afirma que os URLs indexados que devolvem códigos 4xx, exceto 429, são removidos do índice (Google, HTTP status codes).
O Cloudflare expõe também o cf.verified_bot_category, um texto com a finalidade de um bot verificado. Valores antigos como Search Engine Crawler e AI Crawler continuam a funcionar nas regras personalizadas. A referência do campo não diz em que planos está disponível, por isso confirme se o editor de regras o oferece antes de desenhar a regra à volta dele. As regras personalizadas correm antes do Super Bot Fight Mode (Cloudflare Docs, Challenge bad bots). A forma como o Bot Fight Mode gratuito e as categorias de bots de IA se relacionam com o Googlebot está no artigo sobre o Cloudflare.
Como bloqueio o Googlebot falso no .htaccess ou no Apache?
O Apache 2.4 faz o mesmo com mod_setenvif e mod_authz_host. Primeiro precisa da lista de IP. Este gerador descarrega o common-crawlers.json e escreve-a no formato do nginx ou do Apache, e recusa-se a escrever se a Google devolver uma lista vazia:
#!/usr/bin/env python3
# Builds allow lists from Google's common-crawlers.json (Googlebot and friends).
# Usage: python3 make_googlebot_ranges.py nginx  > /etc/nginx/googlebot-ranges.conf
#        python3 make_googlebot_ranges.py apache > /etc/apache2/googlebot-ranges.conf
import json, sys, urllib.request

URL = "https://developers.google.com/static/crawling/ipranges/common-crawlers.json"
with urllib.request.urlopen(URL, timeout=20) as r:
    nets = [p.get("ipv4Prefix") or p.get("ipv6Prefix") for p in json.load(r)["prefixes"]]
if not nets:
    sys.exit("empty list from Google, refusing to write")

if sys.argv[1:] == ["nginx"]:
    print("\n".join(f"{n} 1;" for n in nets))
elif sys.argv[1:] == ["apache"]:
    for i in range(0, len(nets), 20):
        print("Require ip " + " ".join(nets[i:i + 20]))
else:
    sys.exit("usage: make_googlebot_ranges.py nginx|apache")
Num servidor onde controla o virtual host, a regra vai no virtual host ou num bloco <Directory>:
SetEnvIfNoCase User-Agent "googlebot" claims_googlebot
<RequireAny>
    <RequireAll>
        Require all granted
        Require not env claims_googlebot
    </RequireAll>
    Include /etc/apache2/googlebot-ranges.conf
</RequireAny>
A lógica lê-se assim: entra quem não diz ser o Googlebot e, além disso, quem vem de um IP da lista. O meu teste deu 200 para um navegador, 403 para um Googlebot falso e 200 para um user agent de Googlebot vindo de um endereço acrescentado ao ficheiro incluído.
Num alojamento partilhado, a regra vai para o .htaccess, onde o Include não é permitido. Corra o gerador com o argumento apache no seu computador e cole as linhas Require ip que ele imprime (16 linhas a 30 de outubro de 2026) diretamente dentro do bloco:
SetEnvIfNoCase User-Agent "googlebot" claims_googlebot
<RequireAny>
    <RequireAll>
        Require all granted
        Require not env claims_googlebot
    </RequireAll>
    # Paste the "Require ip ..." lines printed by
    # python3 make_googlebot_ranges.py apache
    # Without them every real Googlebot gets 403.
</RequireAny>
Testei também esta variante de .htaccess, com os mesmos três resultados. Ela exige que o alojamento permita as sobreposições AuthConfig e FileInfo: só com AuthConfig, o meu servidor de teste respondeu a todos os pedidos com erro 500 e registou SetEnvIfNoCase not allowed here. Abra a página inicial no navegador logo depois de enviar o ficheiro. Lembre-se também de que a lista fica congelada no momento em que a colou: marque no calendário uma atualização mensal, ou a Google acrescenta intervalos novos que a sua regra passa a bloquear.
A armadilha do proxy aplica-se aqui. Atrás do Cloudflare, o Apache vê o IP do Cloudflare e não o do visitante; é preciso o mod_remoteip com RemoteIPHeader CF-Connecting-IP e os intervalos do Cloudflare como proxies de confiança, senão a regra bloqueia o rastreador verdadeiro. Num alojamento partilhado não controla isso, e é mais uma razão para pôr a regra no Cloudflare. Muitos alojamentos partilhados correm LiteSpeed em vez de Apache. O LiteSpeed lê a maioria das diretivas do .htaccess, mas não testei este bloco nele, por isso confirme o resultado com um user agent falso a partir do seu computador antes de confiar na regra.
Como bloqueio o Googlebot falso no nginx?
Num VPS com nginx, gere o ficheiro de inclusão com o mesmo script (python3 make_googlebot_ranges.py nginx), marque os pedidos cujo user agent contém “googlebot” e devolva 403 apenas quando o user agent diz Googlebot e o IP não está na lista. Os blocos geo e map vão no contexto http; o if vai no bloco server do site WordPress:
# http { ... }
geo $googlebot_ip {
    default 0;
    include /etc/nginx/googlebot-ranges.conf;
}
map $http_user_agent $claims_googlebot {
    default 0;
    ~*googlebot 1;
}
map "$claims_googlebot:$googlebot_ip" $fake_googlebot {
    default 0;
    "1:0"   1;
}

# server { ... }
if ($fake_googlebot) {
    return 403;
}
Testei exatamente este bloco: um pedido normal do navegador recebeu 200, um pedido com user agent de Googlebot vindo de um IP que não é da Google recebeu 403 e, depois de acrescentar o endereço da máquina de teste ao ficheiro incluído, o mesmo pedido recebeu 200. Repita este último passo no seu servidor com um IP real do Googlebot tirado dos seus registos antes de confiar na regra.
Atualize a lista a partir do cron, escrevendo primeiro para um ficheiro temporário, para que uma descarga falhada nunca deixe o nginx com uma inclusão vazia:
python3 make_googlebot_ranges.py nginx > /tmp/googlebot-ranges.conf \
  && mv /tmp/googlebot-ranges.conf /etc/nginx/googlebot-ranges.conf \
  && nginx -t && systemctl reload nginx
O gerador e o nginx -t foram testados; a linha com mv e o recarregamento não correu num servidor real. A armadilha que vira a regra contra si é a mesma do Apache: um proxy à frente do nginx. Atrás do Cloudflare, de um balanceador de carga ou de um proxy do fornecedor, $remote_addr é o endereço do proxy e nunca o da Google, e todos os pedidos reais do Googlebot recebem 403. Configure primeiro o módulo realip (set_real_ip_from para cada intervalo do proxy e real_ip_header CF-Connecting-IP; no caso do Cloudflare) e confirme no registo de acessos que vê IP de visitantes, e não do proxy, antes de ativar o bloqueio.
Os plugins de segurança para WordPress bloqueiam bem o Googlebot falso?
Alguns sim, se a opção certa estiver escolhida. O Wordfence é um bom exemplo porque a documentação descreve os dois lados. Nas opções de limitação de pedidos (rate limiting), a definição Verified Google crawlers have unlimited access to this site usa uma consulta de DNS reverso, e um visitante que falsifique o cabeçalho do Googlebot falha esse teste de PTR. A alternativa, Anyone claiming to be Google has unlimited access, faz o que o nome diz: um Googlebot falso também ganha acesso ilimitado (Wordfence Help, Rate limiting). Se usa a limitação de pedidos do Wordfence, confirme qual das duas está selecionada.
Para qualquer plugin ou regra própria, três perguntas separam o que é seguro do que é arriscado:
- Verifica o IP ou só o user agent? Uma regra que bloqueia ou autoriza apenas pelo user agent é exatamente aquilo com que os impostores contam.
- Usa uma lista atual ou uma consulta DNS em tempo real? Uma lista de IP fixa, copiada de um fórum em 2019, não conhece os intervalos mais recentes da Google e acaba por bloquear o rastreador verdadeiro.
- Corre antes ou depois da cache de páginas? Um plugin em PHP só vê os pedidos que chegam ao PHP. Se o alojamento ou um plugin de cache serve HTML guardado diretamente, um Googlebot falso que leia páginas em cache nunca se cruza com o plugin. Para proteção contra scraping de catálogos isto pesa; para ataques de força bruta ao
wp-login.phppesa menos, porque esse URL não fica em cache.
As regras que “bloqueiam bots” com uma lista de user agents no .htaccess têm o problema oposto: travam os rastreadores honestos que se identificam e deixam passar todos os que mentem. Quando encontro uma lista dessas num site de que trato no âmbito da manutenção de WordPress, substituo-a por uma regra baseada no IP ou passo a decisão para o Cloudflare. Quando a lógica de bloqueio tem de viver na própria aplicação, por exemplo num plugin à medida num alojamento sem acesso ao servidor, isso é trabalho de desenvolvimento WordPress e usa a mesma lista de IP como fonte.
Como verifico o Bingbot e os rastreadores da OpenAI?
Bingbot. O método da Microsoft é a mesma verificação de DNS nos dois sentidos: o DNS reverso tem de terminar em search.msn.com e a consulta direta a esse nome tem de devolver o mesmo IP (Bing Webmaster Blog, How to Verify that Bingbot is Bingbot). A 30 de outubro de 2026:
$ host 157.55.39.1
1.39.55.157.in-addr.arpa domain name pointer msnbot-157-55-39-1.search.msn.com.
$ host msnbot-157-55-39-1.search.msn.com
msnbot-157-55-39-1.search.msn.com has address 157.55.39.1
O Bing oferece também uma ferramenta pública de verificação em bing.com/toolbox/verify-bingbot, e a mesma ferramenta dentro do Bing Webmaster Tools. A lista de IP, bing.com/toolbox/bingbot.json, tinha um creationTime de 3 de janeiro de 2024 quando a descarreguei, com 28 prefixos. Uma lista que não é regenerada há quase três anos pode continuar correta, mas eu não montaria um bloqueio rígido sobre ela. É por isso que as regras de nginx e Apache acima cobrem apenas o Googlebot. Para o Bing, verifique primeiro os IP do seu registo com o script de DNS e só depois decida.
OpenAI. A OpenAI documenta quatro rastreadores, cada um com o seu ficheiro de IP (OpenAI, Overview of OpenAI crawlers):
| User agent | Finalidade | Lista de IP |
|---|---|---|
OAI-SearchBot | Mostra sites nas respostas da pesquisa do ChatGPT | openai.com/searchbot.json |
GPTBot | Rastreia conteúdo que pode ser usado para treinar modelos | openai.com/gptbot.json |
ChatGPT-User | Vai buscar uma página quando um utilizador pede; a OpenAI diz que as regras do robots.txt podem não se aplicar | openai.com/chatgpt-user.json |
OAI-AdsBot | Verifica páginas de destino de anúncios no ChatGPT | openai.com/adsbot.json |
O script em Python acima já verifica as três primeiras listas. O mesmo padrão do nginx funciona para elas, se quiser: uma inclusão geo separada, gerada a partir do ficheiro certo, e uma correspondência de user agent com o nome certo.
O que nunca devo bloquear ao limpar o tráfego de bots?
Uma limpeza demasiado zelosa pode custar mais do que os impostores, porque os rastreadores verdadeiros perdem o acesso. Deixe estes de fora de qualquer regra de bloqueio:
- Google-Extended. É um token do robots.txt e não um rastreador. A Google diz que não tem user agent próprio: o rastreio é feito com os user agents habituais da Google e o token só controla se o conteúdo pode ser usado no treino e na fundamentação (grounding) do Gemini. Segundo a Google, não afeta a presença do site na Pesquisa Google (Google, common crawlers). Uma regra no servidor que procure Google-Extended no user agent só apanha impostores. Se quer sair do treino do Gemini, a ferramenta é uma linha Disallow no robots.txt, que comparei com os outros interruptores da Google em controlos de IA da Google.
- Pedidos iniciados por utilizadores. O Google Site Verifier vai buscar o token de verificação do Search Console, o Feedfetcher lê o feed RSS, o Google Read Aloud lê páginas em voz alta a utilizadores e o GoogleMessages cria pré-visualizações de links. Ignoram o robots.txt por desenho, porque foi uma pessoa a pedir (Google, user-triggered fetchers). Bloqueá-los estraga a verificação e as pré-visualizações, e não o rastreio.
- Google-InspectionTool. É usado pela inspeção de URL do Search Console e pelo teste de resultados avançados. Os seus IP estão na lista de rastreadores comuns; o user agent não contém “Googlebot”, por isso as regras acima não lhe tocam.
- Google-Agent. É usado pelos agentes da Google que agem a pedido de um utilizador, com IP do
user-triggered-agents.json. A Google está a experimentar o Web Bot Auth em parte destes pedidos, com a identidadehttps://agent.bot.goog. A própria documentação diz que nem todos os pedidos são assinados e que a verificação deve recorrer ao IP, ao DNS reverso e ao user agent (Google, Web Bot Auth). Os pedidos assinados trazem o cabeçalhoSignature-Agent: g="https://agent.bot.goog"e verificam-se com as chaves emagent.bot.goog/.well-known/http-message-signatures-directory, segundo o RFC 9421. Para um site WordPress, a resposta prática é deixar essa verificação à CDN, se ela a suportar, e não bloquear o que ela ainda não consegue verificar.
O robots.txt nem entra nesta lista de ferramentas contra impostores. Illyes, no resumo do Search Engine Roundtable, chamou-lhe uma sugestão e não uma restrição que se possa impor. Os rastreadores honestos leem-no; um Googlebot falso ignora-o, ou lê a secção do Googlebot e toma-a como autorização.
Bloquear Googlebots falsos altera as estatísticas de rastreio no Search Console?
Não deve alterar, e é isso que torna o relatório um bom controlo. O relatório Estatísticas de rastreio mostra o histórico de rastreio do seu site pela Google (Ajuda do Search Console, relatório Estatísticas de rastreio). Os pedidos dos impostores nunca lá aparecem, porque não foi a Google a fazê-los. A Google acrescenta que o relatório inclui a maioria dos pedidos de rastreio, mas não necessariamente todos, por isso pequenas diferenças face aos seus registos são normais.
Daqui sai uma verificação aproximada. Se o registo mostra muitos mais pedidos “Googlebot” do que as Estatísticas de rastreio para os mesmos dias, o excedente é candidato a usurpação, e o script de IP confirma-o. Esta leitura é minha, não da Google. O caso inverso tem explicação oficial: se as Estatísticas de rastreio mostram muito mais do que os registos, a Google diz que isso pode acontecer quando o robots.txt esteve indisponível durante demasiado tempo e a Google contou os rastreios que teria feito.
Depois de ativar um bloqueio, acompanhe duas coisas nas Estatísticas de rastreio durante uma ou duas semanas. O total de pedidos deve manter-se, e a divisão por resposta não deve mostrar 403 novos. Uma subida de respostas 403 logo após uma alteração de regra significa que a regra está a atingir o Googlebot verdadeiro. A Google diz também que 401 e 403 não servem para limitar o ritmo de rastreio (Google, HTTP status codes). Se o problema de carga vem do rastreio real, um 429 ou um 503 fazem a Google abrandar temporariamente sem perder URL.
Resolução de problemas: o que significa cada resultado?
| O que vê | O que significa | O que fazer |
|---|---|---|
| User agent de Googlebot, IP fora de todas as listas, PTR ausente ou alheio | Impostor | Bloquear no Cloudflare ou no servidor; sem risco para o SEO |
PTR termina em googlebot.com, consulta direta devolve outro IP | Alguém configurou um PTR falso | Tratar como falso; o passo direto existe para isto |
User agent de Googlebot, PTR em gae.googleusercontent.com | Pedido iniciado por um utilizador, não o rastreador da pesquisa | Confirmar no user-triggered-fetchers.json; não contar como Googlebot |
IP no common-crawlers.json, PTR fora do padrão documentado | Rastreador real da Google com um PTR invulgar (vi um a 30.10.2026) | Confiar na lista |
| O registo mostra muito mais pedidos Googlebot do que as Estatísticas de rastreio | Provavelmente há impostores no registo | Correr o script de IP sobre esses endereços |
| As Estatísticas de rastreio mostram muito mais do que o registo | Segundo a Google, o robots.txt esteve indisponível demasiado tempo | Ver o estado do robots.txt no Search Console |
| Sobem as respostas 403 nas Estatísticas de rastreio após uma regra nova | A regra atinge o Googlebot verdadeiro | Rever o IP do proxy, a atualidade da lista e a ordem das regras |
Erro 500 em todo o site logo após enviar o .htaccess | O alojamento não permite FileInfo no .htaccess | Repor o ficheiro anterior e passar a regra para o Cloudflare |
| O seu próprio rastreador de SEO, configurado com user agent de Googlebot, recebe 403 | A regra funciona: o seu IP não é da Google | Usar outro user agent nas auditorias ou autorizar o seu IP |
| A regra não bloqueia nada, nem um falso óbvio | O servidor vê o IP do proxy, ou a cache respondeu primeiro | Corrigir realip ou remoteip, ou passar a regra para a CDN |
Lista de verificação para um site WordPress
- Conte os IP que se apresentaram como Googlebot na última semana de registos de acesso.
- Corra o script de IP sobre eles e anote quantos aparecem como
NOT IN ANY LIST. - Compare o total do registo com as Estatísticas de rastreio para os mesmos dias.
- Se bloquear, bloqueie por IP mais user agent, nunca só pelo user agent.
- Atrás de um proxy ou CDN, confirme que o servidor regista os IP dos visitantes antes de ativar qualquer regra por IP.
- Gere as listas de permissão a partir do
common-crawlers.jsone atualize-as com uma proteção contra descargas vazias; no.htaccess, marque uma atualização manual mensal. - Deixe o Google-Extended, os pedidos iniciados por utilizadores, o Google-InspectionTool e o Google-Agent fora das regras de bloqueio.
- Acompanhe as respostas 403 nas Estatísticas de rastreio durante duas semanas após cada alteração.
Se os seus registos mostram muito tráfego de impostores a bater em wp-login.php e xmlrpc.php, o Googlebot falso costuma ser o menor dos problemas do servidor. Uma auditoria de segurança WordPress parte dos mesmos registos de acesso e analisa o que esses pedidos tentavam fazer.