Cada um dos oito defeitos descritos abaixo passou por um script ou por um agente que terminou o trabalho com uma mensagem de sucesso. Nenhum lançou uma exceção. Todos chegaram à produção de um site multilingue que construo e mantenho há anos, e só os encontrei quando comecei a comparar o resultado com outra coisa que não o relatório da própria ferramenta.
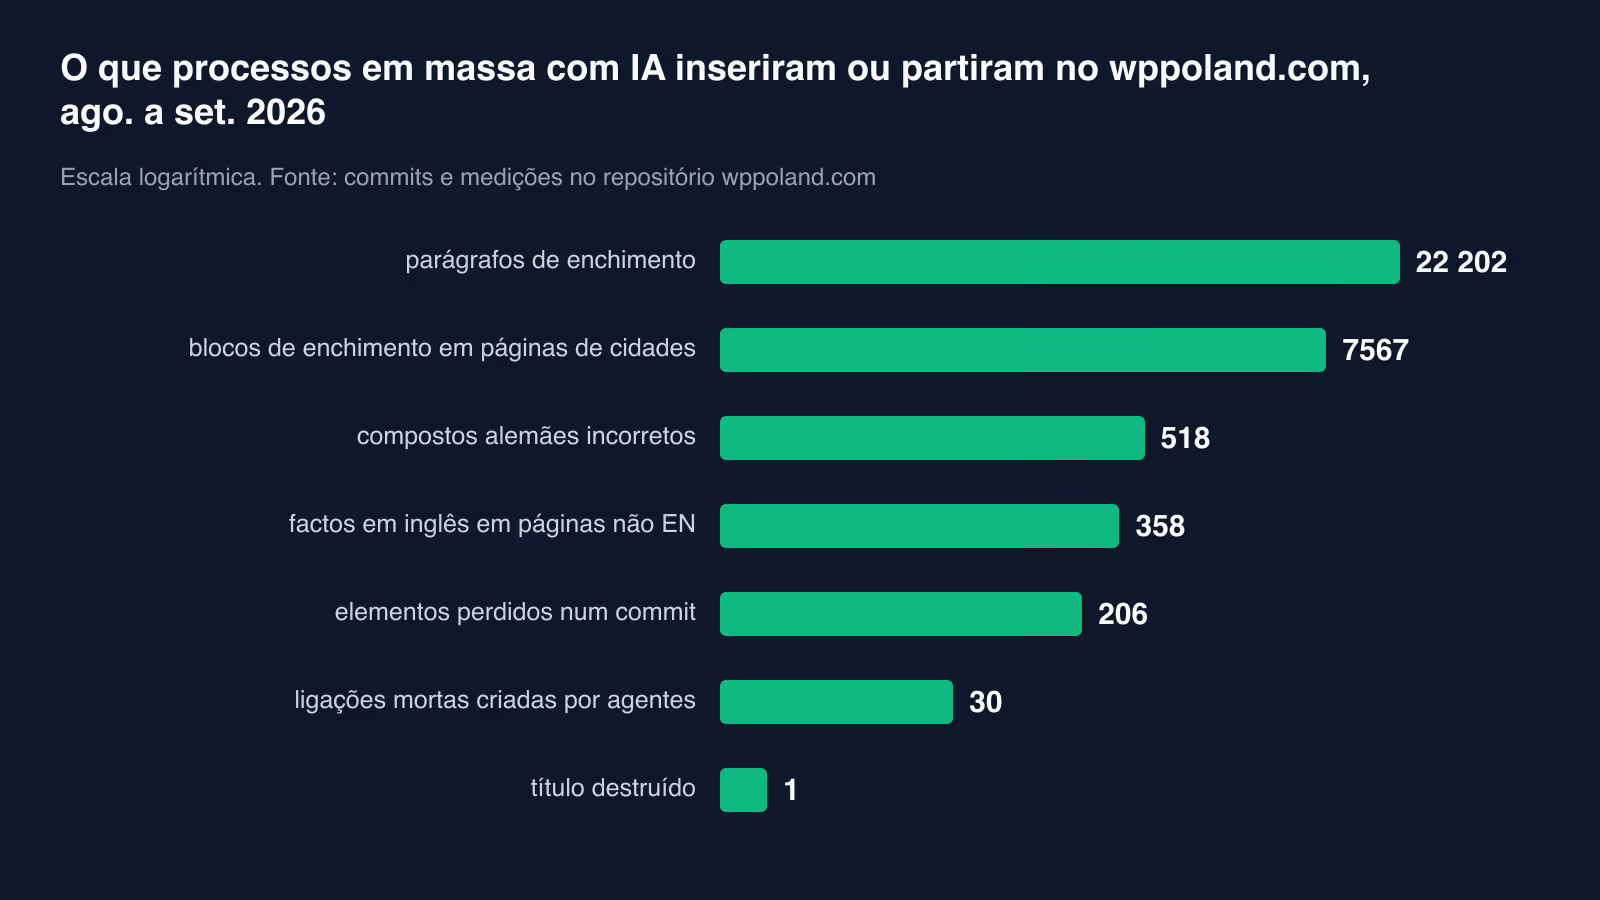
Entre agosto e setembro de 2026, execuções de IA em massa inseriram no meu site 22 202 parágrafos de enchimento, destruíram um título, deixaram 358 frases em inglês em páginas de cinco outras línguas e 518 compostos alemães incorretos. Os agentes que escreviam páginas de cidades acrescentaram estudos de caso inventados e 30 ligações para páginas que não existem. Descrevo o mecanismo de cada defeito e a verificação que o apanha hoje.
Escrevo isto sobre o meu próprio site porque só aqui tenho os dados completos: o commit, o número de ficheiros, o estado antes e depois. O Search Engine Land publicou esta semana um texto sobre dez maneiras como o Claude pode descarrilar o SEO quando ninguém verifica o seu trabalho. Esta é a versão com recibos.
Erros de conteúdo IA num site com 13 733 páginas
O wppoland.com corre em Astro e é gerado de forma estática em seis línguas: polaco, inglês, alemão, norueguês, português e espanhol. O último build de produção, de 29 de setembro de 2026, gerou 13 733 páginas. O conteúdo é criado e corrigido por agentes de programação e por scripts Node que percorrem milhares de ficheiros de uma vez. Tenho mais de 70 verificações de qualidade no CI e em local.
Mesmo assim, cada um dos defeitos descritos passou por todas as verificações. A razão é sempre a mesma e volto a ela no fim. Os números da tabela são as minhas medições, feitas no histórico do repositório do wppoland.com.
| Defeito | O que chegou a produção | Como o encontrei | Verificação hoje |
|---|---|---|---|
| Enchimento até um número de palavras | 22 202 parágrafos em 873 ficheiros | 59 cópias de um parágrafo numa página ativa | check:no-batch-filler |
| Enchimento das páginas de cidades | 7567 blocos em 2621 ficheiros | Títulos numerados de “Ateny (1)” a “Ateny (26)“ | a mesma, alargada às cidades |
| Regex de preços | 1 título destruído | Detetor de palavras coladas | check:glued-words |
| Tradução só das conjunções | 358 frases em inglês em 104 ficheiros | Comparação com o equivalente inglês | detetor baseado no wpId |
| Substituição de termo sem compostos | 518 compostos em 356 ficheiros | Leitura manual da página | procura da classe, não do literal |
| Estudos de caso inventados | 13 páginas, 30 ligações mortas | Revisão dos agentes antes da publicação | validação das ligações internas |
| Deploy que aqueceu a cache antiga | 5 de 6 páginas iniciais com conteúdo antigo | Comparação do conteúdo, não dos códigos HTTP | segundo purge depois do smoke test |
| Aprofundamento que substituía o conteúdo | 142 a 206 elementos por commit | Comparação com a versão anterior do ficheiro | check:element-loss |
1. Enchimento com IA para atingir um número de palavras
As minhas diretrizes editoriais dizem que um artigo do blogue tem cerca de 2500 palavras. Era uma indicação para uma pessoa. Uma série de scripts em lote tratou-a como uma meta a cumprir e encheu os textos mais curtos com enchimento gerado.
O resultado, medido na limpeza de 29 de agosto: 22 202 parágrafos numerados do tipo “Notatka wdrożeniowa 47” (nota de implementação 47) em 873 ficheiros, até 60 cópias idênticas num só artigo, mais 4 144 secções de modelo rodadas a partir de um conjunto de cinco por língua. Duas dessas secções eram instruções editoriais internas, publicadas como corpo do artigo. Na página ativa sobre atualizações de segurança do WordPress, o mesmo parágrafo aparecia 59 vezes.
O script não tinha nenhum erro. Fazia exatamente o que lhe tinham pedido: aumentar o número de palavras. O erro estava em ter-se tomado o número de palavras, uma medida auxiliar, como objetivo.
Verificação hoje: check:no-batch-filler em cada execução de npm run check. A primeira versão procurava os literais do gerador e deixou passar o enchimento quando este voltou com outro texto. A atual olha para a forma: o mesmo título de segundo nível três vezes no mesmo ficheiro é um erro, independentemente das palavras.
2. Páginas de cidades programáticas com enchimento duplicado
Durante semanas, a coleção de páginas de cidades escapou a todas as verificações, porque nenhuma a analisava. As execuções 11 a 14 encheram essas páginas até 2200 e depois 2500 palavras. Na limpeza de 30 de agosto removi 7567 blocos numerados e cerca de 21 mil secções repetidas de 2621 ficheiros. A página /pl/woocommerce-programista-ateny/ mostrava secções de “Ateny (1)” a “Ateny (26)”.
Pior: uma das execuções acrescentava blocos em espanhol a todas as línguas exceto o norueguês. As páginas de cidades polacas, alemãs e portuguesas tinham secções “Entrega y seguimiento”.
A segunda lição veio com a remoção. A primeira versão do script de limpeza comparava literais completos e reportou sucesso, deixando 9642 secções para trás, porque scripts de correção posteriores tinham alterado esse enchimento no próprio sítio (por exemplo, a concordância de género em espanhol em 1506 ficheiros). A comparação exata de bytes não via nenhum bloco em que um corretor tivesse mexido. Agora faço a correspondência pelo título mais as primeiras quatro palavras.
Depois de removido o enchimento, 724 páginas ficaram abaixo do limiar de 2000 palavras. Verifiquei-as no Google Search Console antes de decidir o que fosse: só 2 tiveram algum clique em 90 dias e 575 tiveram zero impressões. Passei 723 para noindex, em vez de voltar a enchê-las.
3. Regex de preços sem limite de palavra estragou um título
As páginas de serviços não mostram preços fora da página de preços, por isso um script substituía os valores em zlotys por “wycena indywidualna” (orçamento individual, em polaco). O regex procurava “zł”, o símbolo da moeda polaca, sem distinguir maiúsculas de minúsculas e sem limite de palavra a seguir.
Na página polaca de auditoria de segurança, o título “2. Złośliwe przekierowania” (redirecionamentos maliciosos) parecia a esse regex um preço, “2. Zł”. Em produção aparecia como “wycena indywidualna ośliwe przekierowania”, ou seja, “orçamento individual” colado aos restos da palavra original. O mesmo regex estava num segundo script, o dos preços nas páginas de cidades.
Encontrei-o por acaso, ao construir um detetor de títulos com palavras coladas, que na mesma ocasião encontrou 13 títulos sem espaço antes de uma preposição (“Is AMP deadin 2026?”). A correção é um lookahead negativo nos dois scripts: depois do símbolo da moeda, o padrão exige agora (?![\p{L}]), ou seja, nenhuma letra de qualquer alfabeto. Só funciona com a flag u, porque sem ela o JavaScript não reconhece classes Unicode como \p{L}. Em todo o corpus só um título foi vítima, mas era o título de uma página comercial.
4. Tradução a meio que deixou frases em inglês
O campo de factos (llmCard) aparece de forma visível por baixo dos artigos e entra nos dados destinados aos modelos de linguagem. Nas páginas das cinco línguas que não são o inglês, 358 dessas frases estavam em inglês, em 104 ficheiros. Parte estava traduzida a meio: um script antigo trocou apenas a conjunção, por isso uma página de portefólio alemã dizia “Contact und inquiry forms” e uma polaca “granite, conglomerate, i marble countertops”.
O mais interessante foi a deteção. O primeiro detetor, baseado na proporção de palavras funcionais inglesas, encontrou 172 frases. Os próprios agentes de tradução assinalaram que tinham ficado outras frases em inglês nos mesmos ficheiros, e tinham razão. Uma segunda passagem comparou cada frase com os factos do equivalente inglês da mesma página (o mesmo wpId). Sem filtro adicional devolvia 4004 resultados, sobretudo listas de tecnologias nas páginas de cidades e o “for” norueguês. Com a exigência de pelo menos duas palavras funcionais inglesas ficaram 170 verdadeiros. Os últimos 12 corrigi-os à mão.
Verifiquei cada uma das cinco traduções com um script, não com o relatório do agente: em cada ficheiro mudaram apenas as posições indicadas, todos os números sobreviveram e não há travessões longos.
5. Palavras compostas alemãs erradas após localizar e substituir
Uma execução de uniformização de vocabulário substituiu um termo alemão por “laufende Betreuung”. Não tratou os compostos, por isso as páginas diziam “laufende Betreuung-Commitments”, “laufende Betreuung-Übergabe” e “Wartungs-laufende Betreuung”. Isto não é alemão. No total, 518 ocorrências em 356 ficheiros, todas em páginas indexadas.
A entrada no meu backlog tinha um comando de verificação que procurava apenas a forma com hífen depois do termo. Corrigir exatamente o que ele indicava tê-lo-ia posto a verde e deixado 157 compostos na segunda forma em 118 ficheiros. Procurei, por isso, a classe do defeito (qualquer hífen encostado ao termo), e não o literal que alguém escreveu na tarefa.
O método de correção foi simples: 497 das 518 ocorrências vinham de quatro frases de modelo. Reescrevi cada uma uma vez, à mão, em alemão correto (“Übergabe in die laufende Betreuung”, “Wartungsbetreuung”) e substituí-as como frase exata. As restantes 21 corrigi-as uma a uma.
6. Agentes de IA que inventam estudos de caso e links
Treze páginas de cidades curadas foram escritas por agentes. A revisão antes da publicação, a 26 de agosto, encontrou nelas secções “Case Study 1: Dystrybutor B2B z Bielan Wrocławskich” (distribuidor B2B de Bielany Wrocławskie) com números precisos: +52% de pedidos, LCP de 4,5 s para 0,7 s, 100/100 no PageSpeed. Nenhum desses clientes existe. Os mesmos números estavam também no campo de factos e nos dados speakable, não só no texto.
Além disso, as secções “Outras localizações” ligavam para cidades escolhidas por adivinhação geográfica: Lübeck, Kiel, Ratisbona, Girona, Tromsø. 30 ligações mortas em 8 ficheiros.
Nenhuma verificação textual apanha isto, porque um estudo de caso inventado é sintaticamente correto. Apanha-o uma regra de processo: o agente recebe no pedido a lista dos endereços existentes, e qualquer afirmação numérica sobre um cliente exige uma fonte no repositório ou desaparece.
7. Cloudflare Pages mostra conteúdo antigo após o deploy
O script de deploy de 8 de setembro terminou sem problemas: envio, limpeza da cache, smoke test 81/81 OK, código de saída 0. No site ativo, cinco das seis páginas iniciais mostravam os blocos antigos.
A ordem era: envio, purge, 8 segundos de pausa, smoke test. O Cloudflare Pages não teve tempo de ativar o novo deploy, por isso os 81 pedidos do teste bateram no build anterior e encheram a cache com ele durante uma hora. O passo de verificação anulou o purge feito instantes antes. Nenhum sinal era falso. Nenhum media o que correu mal: o teste verificava códigos HTTP, não o conteúdo.
Hoje: o script limpa a cache uma segunda vez, depois do teste, e confirmo o deploy com uma frase de uma alteração concreta no site ativo, com um parâmetro que contorna a cache.
8. Reescrita com IA que apagava tabelas e blocos de código
As execuções que “aprofundavam” artigos curtos deviam acrescentar conteúdo. Na prática, algumas substituíam o corpo inteiro do artigo. Restaurei nove artigos a partir do histórico do git.
Depois disso construí uma verificação que compara cada ficheiro alterado com a sua versão base e assinala a perda de um elemento: tabela, componente, iframe, imagem, bloco de código, pergunta de FAQ, passo howTo, ligação interna. Executada retroativamente sobre os últimos 60 commits de conteúdo, marcou cada execução de aprofundamento de 128 a 185, cada uma das quais perdia entre 142 e 206 elementos, incluindo tabelas, vídeos incorporados e blocos de código.
A primeira versão desta verificação reconhecia os títulos pelo texto. No ramo atual assinalou 17 títulos perdidos, e todos os 17 eram correções: palavras coladas separadas, um título comido restaurado. Mudar o nome não é perder. Por isso conto títulos, ligações e FAQ em quantidade, e deixo a identidade só para imagens, componentes e iframes.
Porque é que os scripts de IA reportam sucesso com erros
Os oito casos têm a mesma forma. A ferramenta media aquilo que ela própria fez e, com base nisso, reportava sucesso. O script de enchimento media o número de palavras. O script de limpeza media se tinha encontrado os seus literais. A verificação do backlog media uma forma do composto. O smoke test media códigos HTTP.
Só encontrei cada defeito quando comparei o resultado com algo externo:
- com a versão anterior do mesmo ficheiro (tabelas e secções perdidas),
- com o equivalente noutra língua (frases em inglês em páginas alemãs),
- com o site ativo em vez do registo do deploy (cache antiga),
- com a classe do defeito em vez do literal da tarefa (a segunda forma dos compostos),
- com dados de procura (723 páginas de cidades sem uma única impressão).
Daqui sai uma regra prática que aplico desde setembro: o relatório de um agente ou de um script é uma hipótese. O resultado é verificado por um script separado, que não sabe o que a ferramenta pretendia fazer e compara o estado antes com o estado depois.
Atualização, . A 8 de outubro, a iPullRank publicou o WARRANT-SEO, um benchmark de Patrick Schofield que mede esta mesma falha nos modelos de linguagem. O estudo testou 27 modelos em 27 cenários de diagnóstico SEO, cada pergunta em três versões, e correu o conjunto completo três vezes. Quando a observação decisiva estava presente, os modelos acertaram no diagnóstico em 99% dos casos. Ao apagar essa única linha, a proporção de respostas que reconheceram, como deviam, que os dados não chegavam caiu para 51,5%. São 47,5 pontos percentuais de diferença: em cerca de metade dos casos o modelo comprometeu-se mesmo assim com uma causa concreta. Segundo os autores, um diagnóstico confiante tem o mesmo aspeto quer assente em provas, quer num palpite.
É o padrão dos meus oito defeitos, com um modelo no lugar de um script. Um pormenor do estudo pesa na verificação: alguns modelos deram o mesmo diagnóstico sem fundamento em todas as repetições, e a repetição parece confirmação. Perguntar duas vezes à mesma ferramenta não verifica nada. A iPullRank recomenda pedir a observação que sustenta o diagnóstico, as causas concorrentes e o que ainda falta. Eu aplico a mesma regra a qualquer relatório: verifica-se o resultado, não o relatório.
Como verificar alterações em massa de conteúdo com IA
- Nenhuma meta numérica para um script que escreve prosa. Número de palavras, número de ligações e número de FAQ são medidas para ler, não para cumprir.
- Uma verificação que compara com a versão anterior do ficheiro antes do primeiro commit em lote, não depois do trigésimo.
- Cada regex sobre texto testado em títulos e em palavras com caracteres polacos, porque “Zł” é o início de muitas palavras.
- Traduções verificadas por comparação com o equivalente na língua de origem, não com uma lista de palavras.
- O comando que verifica uma tarefa procura a classe do defeito. Se a tarefa indica um exemplo, procure também as suas variantes.
- Deploy confirmado pelo conteúdo no site ativo, em cada língua.
Atualização de spam do Google de setembro de 2026 e conteúdo com IA
Não afirmo que estes defeitos me custaram tráfego, porque não o medi de forma que o permita decidir. Parte das páginas com enchimento também não tinha impressões antes dele.
A atualização de spam do Google de setembro decorreu de 24 de setembro a 8 de outubro de 2026, segundo o painel de estado do Google. Segundo o resumo do Search Engine Roundtable de 28 de setembro, atingiu páginas programáticas e conteúdo gerado por IA, e o Google publicou na mesma semana um trabalho sobre o sistema SAFE para detetar “AI slop” em massa. As minhas páginas de cidades são exatamente essa categoria. Farei a leitura no Search Console, separadamente para páginas de cidades, blogue e páginas de serviços, quando a atualização terminar, e publicá-la-ei, seja qual for o resultado.
Uma última nota sobre mim próprio: este texto também foi escrito com a ajuda de um agente. Cada número nele vem de um commit ou de uma medição no meu repositório e passou pelas mesmas verificações que aqui descrevo.
Esses oito defeitos explicam porque a minha integração de IA no WordPress começa por gates e testes litmus, não por mais uma reescrita em massa sem supervisão.