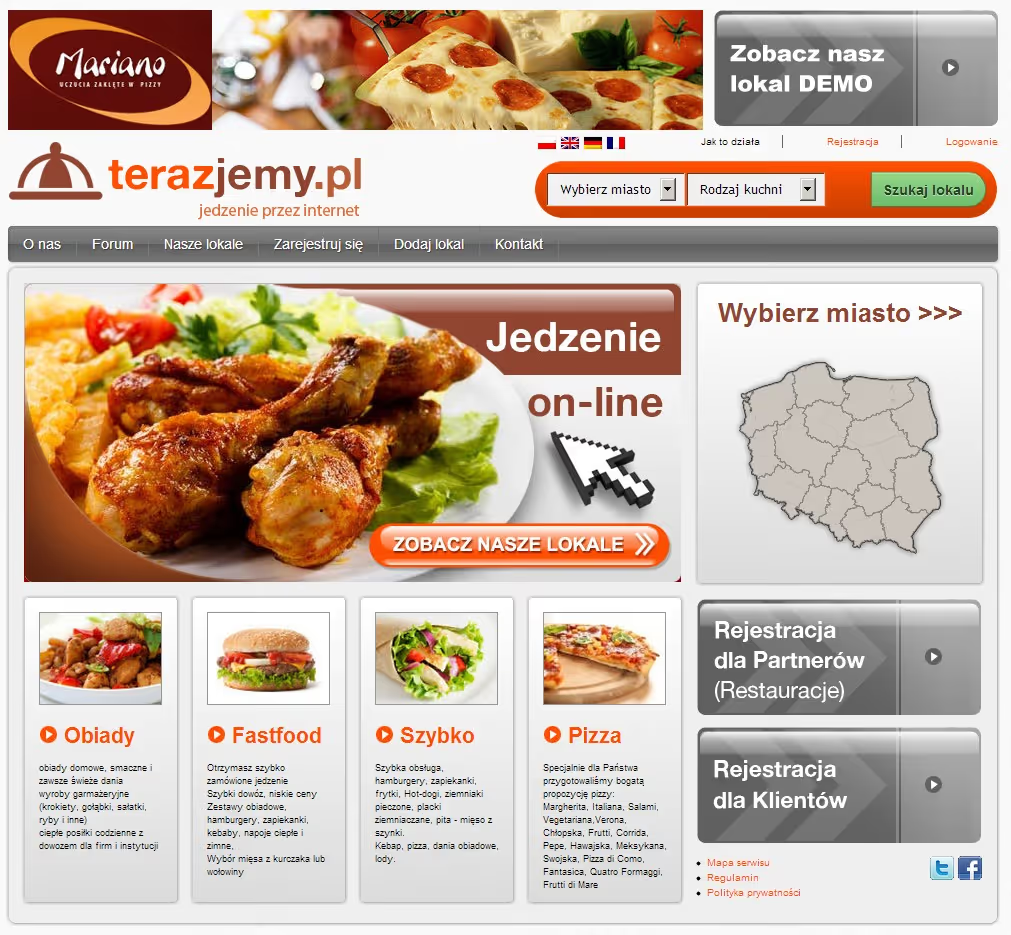
O calendário decide a carga de um portal de receitas
O terazjemy.pl foi uma plataforma sobre alimentação saudável e atividade física, com receitas, artigos educativos e guias interativos. O site já não está online há algum tempo, por isso o que se segue descreve decisões de projeto e não um estado atual. A entrega foi em 2012 e o trabalho demorou cerca de seis semanas.
Começo pela sazonalidade porque é a característica que mais distingue este tipo de site de qualquer outro portal de conteúdos. O tráfego não é uniforme. Tem picos nítidos à volta das épocas festivas e, no mercado polaco, o maior de todos é a ceia de Natal, com procura por pratos que ninguém pesquisa nos outros onze meses. O segundo pico chega no início de janeiro, quando o que muda não é o prato mas a intenção: as pessoas procuram os mesmos pratos em versão mais leve.
Daqui saem duas consequências práticas. A primeira é de capacidade: a carga não se distribui pelo ano, portanto uma configuração que chega em março pode não chegar na semana anterior às festas, e não chega em meia dúzia de endereços concretos, não no site inteiro. O tráfego entra num jato estreito sobre uma dúzia de páginas, o que por um lado é perigoso e por outro é fácil de resolver, porque essa mesma dúzia de páginas pode ser aquecida em cache antes de a onda chegar.
A segunda consequência é editorial. Material sazonal que passa o ano no site não está morto, está adormecido, por isso apagá-lo no fim da época é um erro. As receitas sazonais têm data de primeira publicação e data da última atualização e, no período em que são procuradas, voltam a lugares visíveis através de ligações temáticas, e não republicando o mesmo texto com data nova.
Uma receita não é um artigo, embora se pareça
Uma receita parece um artigo: tem título, fotografia e texto. Comporta-se de maneira completamente diferente.
Um artigo lê-se uma vez, de cima para baixo. Uma receita lê-se duas: primeiro no supermercado, pela lista de ingredientes, e depois na cozinha, pela ordem das operações, e essa segunda leitura acontece com as mãos sujas e com o ecrã a apagar-se sozinho. Um artigo tem um autor e uma data. Uma receita tem tempo de preparação, número de doses, grau de dificuldade, ingredientes com quantidades e um conjunto de etiquetas alimentares, e todas essas coisas são perguntas de pesquisa e não enfeite.
Por isso a receita não podia ser uma entrada de texto. Precisava de estrutura própria: ingredientes como lista de posições com quantidade e unidade, passos como sequência ordenada, e tempo, doses e categorias alimentares em campos separados. Só com essa estrutura se responde a uma pergunta do género jantar sem glúten em menos de trinta minutos, e só com essa estrutura se descreve o conteúdo em dados estruturados de forma que um motor de busca perceba.
Unidades, doses e o que não se pode multiplicar
Assim que os ingredientes passam a ser posições separadas, aparece um problema que o texto corrido não tem: é preciso decidir o que é uma unidade.
Na cozinha polaca convivem gramas e mililitros com o copo, a colher, a colher de chá, a pitada e o decagrama, sendo que este último é uma unidade que fora daquele contexto quase ninguém usa e que em receitas domésticas antigas aparece com toda a naturalidade. O copo, por seu lado, não tem uma capacidade única e significa uma coisa com farinha e outra com sêmola, porque nos dois casos se mede volume enquanto o leitor pensa em peso.
Há duas saídas óbvias e ambas se pagam. Pode forçar-se o sistema métrico e converter tudo, o que dá dados coerentes e receitas com ar de protocolo de laboratório. Pode deixar-se a unidade tal como a autora a escreveu, o que dá linguagem natural e inviabiliza qualquer conversão automática. Escolhemos uma terceira via: a unidade é um campo tirado de uma lista fechada e, nas que admitem equivalência métrica, o fator fica guardado ao lado. A receita aparece como foi escrita, e o ajuste de doses funciona onde tem com que trabalhar e abstém-se de forma visível onde não tem.
O ajuste de doses merece um parágrafo próprio porque parece banal e raramente está bem feito. Duplicar as doses não duplica o tempo de forno nem duplica uma pitada de sal. Um mecanismo que multiplica tudo por dois produz receitas impossíveis de executar, por isso a conversão aplica-se apenas às posições com quantidade numérica e unidade de medida, deixando intactos os tempos e as indicações descritivas.
As fotografias são a carga útil
A fotografia de um prato é, neste site, conteúdo e não ilustração. Uma receita sem fotografia praticamente não funciona, porque o leitor decide com os olhos antes de ler a lista de ingredientes. E a fotografia gastronómica está entre as mais caras de transmitir: tem muita textura, poucas zonas planas, comprime mal, e raramente vem sozinha.
O trabalho de desempenho foi por isso para onde estava a massa. Os ficheiros são processados no carregamento para um conjunto de tamanhos que corresponde aos sítios onde realmente aparecem: a miniatura da listagem, a imagem principal da receita e as fotografias dos passos. A miniatura da listagem nunca é a imagem principal redimensionada pelo navegador, porque esse redimensionamento poupa pixéis no ecrã e não poupa um único byte de transferência.
As imagens abaixo do primeiro ecrã são carregadas quando se aproximam da vista, com a Intersection Observer API. Vale a pena marcar o limite desta técnica, porque é aplicada com demasiada frequência sem reflexão: a fotografia principal de uma receita costuma ser o elemento mais importante do primeiro ecrã, portanto atrasar precisamente essa piora a perceção da página em vez de a melhorar. O carregamento diferido faz sentido abaixo da dobra, não no elemento pelo qual o leitor está à espera.
O que é de facto colocado em cache
Do ponto de vista da cache, um site de conteúdos é um caso agradecido: quase tudo o que mostra é igual para qualquer visitante e muda pouco. O ganho vem sobretudo de um pedido por uma receita já publicada não chegar a executar PHP, e é disso que trata a camada do Varnish, com VCL próprio, modo grace e blocos dinâmicos servidos à parte.
Os elementos que mudam mesmo são poucos e podem ser enumerados: o contador de comentários, o bloco de entradas recentes, o estado da sessão. Qualquer um deles, colocado diretamente no documento, invalida a cache da página inteira. Por isso ficam separados e são pedidos à parte, o que soa a complicação e é exatamente o contrário: permite manter o resto da página em cache durante muito tempo em vez de a refrescar sempre que alguém comenta.
O Redis trata da camada de baixo, ou seja, dos resultados de consultas que se repetem em muitas páginas: listagens de categorias, relações entre receitas, agregados de etiquetas alimentares. Não são coisas caras uma a uma, são coisas calculadas em cada visualização, e esse custo só se vê sob tráfego real e nunca em testes sobre uma instalação vazia. O Cloudflare fica à frente de tudo, com a camada de borda e os ficheiros.
Invalidar a cache é, nesta montagem, mais difícil do que enchê-la. Publicar uma receita não muda apenas a página dela: muda a listagem da categoria, a página inicial, o bloco de relacionadas e o mapa do site. Limpando só a primeira, o resto do site finge durante uma hora que a receita não existe. Limpando tudo, cada publicação deita fora o trabalho de cache do site inteiro. O ponto sensato está em limpar aquilo que depende mesmo do objeto alterado, e isso tem de ser escrito de forma explícita durante a construção, porque por omissão nenhum mecanismo o sabe.
Dados estruturados têm de nascer da mesma fonte que o texto
A receita é um dos poucos tipos de conteúdo para os quais os motores de busca têm tratamento próprio e detalhado. A descrição estruturada cobre ingredientes, passos, tempo de preparação e de confeção, doses e informação nutricional.
O ponto decisivo, no entanto, é organizativo e não técnico. Dados estruturados só fazem sentido se saírem da mesma fonte que o conteúdo visível. Se a redação escreve os ingredientes dentro do texto e outra pessoa preenche à parte os campos para o motor de busca, os dois conjuntos divergem em poucos meses, e divergem em silêncio, porque ninguém lê dados estruturados a olho. Por isso os campos da receita são o único ponto de entrada, e tanto a vista para pessoas como a descrição para máquinas são geradas a partir deles. O mesmo vale para o mapa XML, gerado a partir do conteúdo e não mantido à mão.
O mesmo princípio evita um segundo erro comum. A informação nutricional dada como número é uma afirmação sobre um prato concreto e depende dos produtos usados, por isso o campo correspondente é opcional e fica vazio enquanto ninguém o preencher conscientemente. Um campo que insere por omissão um valor calculado produz dados com aparência de medição que não são uma medição.
Newsletter e a parte que não é o formulário
O site recolhia endereços para uma newsletter, e é aqui que se toma atalho com mais frequência. Um campo de email e um botão montam-se num quarto de hora. O problema começa por baixo.
Um endereço escrito num formulário não é um consentimento, é uma declaração, e enquanto não for confirmado por um clique num link enviado para esse endereço nem sequer se sabe se pertence a quem o escreveu. Por isso a inscrição tem dois passos: escrever o endereço cria um registo pendente, e só a confirmação o transforma em subscrição. Sem esse passo qualquer pessoa pode inscrever o endereço de outra, e a lista cresce com entradas que no primeiro envio se transformam em queixas de abuso.
A saída conta tanto como a entrada. O link de cancelamento tem de funcionar sem sessão iniciada e sem formulário, num único clique, porque cada obstáculo colocado nesse caminho transfere o cancelamento para o botão de marcar como spam do cliente de correio, e isso custa muito mais do que perder um endereço.
O envio também não pode acontecer dentro do pedido do utilizador. Enviar para uma lista demora e falha por motivos sobre os quais quem está à frente do formulário não tem qualquer influência. Tarefas deste tipo vão para uma fila, com RabbitMQ, e correm fora do pedido com possibilidade de nova tentativa, porque uma recusa temporária do servidor de correio não devia significar que a mensagem se perdeu.
Cópias de segurança e a prova que ninguém faz
As cópias eram feitas automaticamente para o Amazon S3, fora do servidor do site, com versionamento, para permitir voltar não só ao estado anterior a uma avaria mas também ao estado anterior a um erro de redação de há uns dias. São dois cenários diferentes e só o segundo acontece com frequência.
Vale a pena repetir aqui o que raramente aparece nas descrições de projetos. Uma cópia que ninguém restaurou é uma hipótese e não uma salvaguarda. O restauro tem de ser feito pelo menos uma vez, num ambiente separado, para se saber quanto demora e o que lhe falta, porque as lacunas de uma cópia têm o hábito de se revelar exclusivamente durante um restauro.
Manutenção e caminhos que não chegaram a ser construídos
A manutenção cobria atualizações do núcleo, do tema e das extensões, revisão de registos, acompanhamento da indexação e arrumação das consultas que cresciam com o número de receitas. Os testes passavam por um ambiente com cópia de dados reais, porque um site com várias centenas de receitas e taxonomias extensas comporta-se de maneira muito diferente de uma instalação limpa com conteúdo de demonstração.
Entre os planos que nunca se concretizaram estavam um módulo de planeamento de refeições, a integração com aplicações de dieta e uma secção de comunidade. Menciono-os como direções e não como funcionalidades, porque nenhuma chegou a existir. Cada uma das três teria além disso mudado o caráter do projeto: o planeamento introduz dados que pertencem a uma pessoa concreta, a integração introduz dependência de uma interface alheia, e a comunidade introduz moderação, ou seja, trabalho humano permanente de que um site de conteúdos até aí não precisava.
O que transita daqui é o método: tratar a receita como dados e não como texto, uma única fonte para a vista e para os dados estruturados, separar o conteúdo estável dos elementos variáveis ao planear a cache, mandar para uma fila tudo o que sai do site, e testar sobre uma cópia de produção. O que não transita é o modelo de conteúdos deste projeto, escrito para uma redação concreta e um briefing da categoria Websites. Um segundo projeto começa por uma análise de âmbito, e a proposta vem a seguir.
Perguntas frequentes
Respostas práticas para aplicar o tema na execução real.
Que âmbito teve o projeto terazjemy.pl?
#Como correu a entrega de terazjemy.pl?
#O que foi mais difícil tecnicamente em terazjemy.pl?
#Que parte de terazjemy.pl pode ser reaproveitada noutro projeto?
#Precisa de FAQ adaptado ao setor e mercado? Criamos uma versão alinhada com os seus objetivos de negócio.
Fale connosco