A implementação de agentes autónomos de inteligência artificial, fluxos de geração aumentada por recuperação (RAG) e assistentes operacionais em ecossistemas empresariais de comércio eletrónico e gestão de conteúdos cria uma superfície de ataque inteiramente inédita. Durante décadas, a engenharia de segurança aplicacional assentou numa fronteira clara: os dados fornecidos pelo utilizador estavam estritamente isolados da lógica executável do programa. Em ambientes clássicos de PHP e bases de dados relacionais, as consultas preparadas através de $wpdb->prepare() impediam a injeção de SQL porque o motor da base de dados tratava os parâmetros estritamente como literais passivos.
Nos sistemas orientados por grandes modelos de linguagem (LLMs), essa separação elementar desaparece. Um modelo de linguagem processa instruções de sistema (system prompt), conhecimento corporativo recuperado de bases vetoriais e dados externos não filtrados dentro de uma única janela de contexto partilhada (context window). Isto significa que qualquer bloco de texto externo tem a capacidade de sequestrar o processo de decisão do modelo. Quando equipa esse assistente com ferramentas executáveis, o protocolo Model Context Protocol (MCP) e permissões de escrita na base de dados do WooCommerce, um ataque simples de prompt injection converte-se numa ameaça direta à continuidade do negócio, à conformidade com o regime da cibersegurança e à proteção de dados ao abrigo do RGPD.
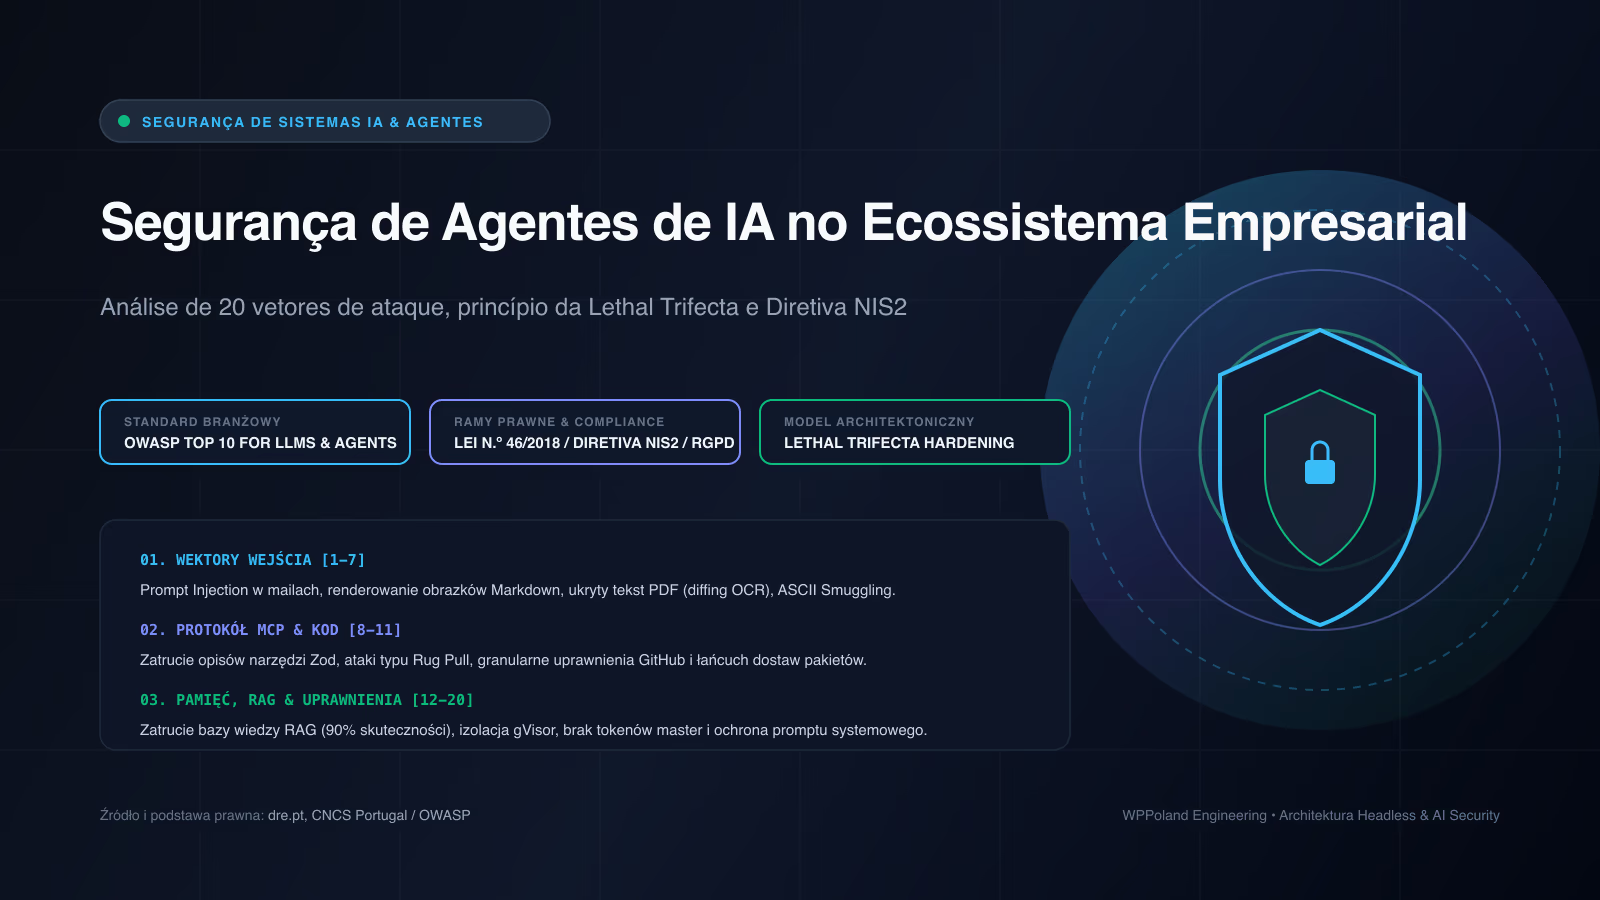
Como arquiteto de sistemas web e integrações de IA em ambientes empresariais, audito regularmente plataformas onde o entusiasmo pela automação rápida ofuscou as boas práticas de higiene de código. Neste artigo, apresento uma análise técnica exaustiva de 20 vetores críticos de ataque a agentes de IA, classificados segundo as diretrizes do OWASP Top 10 for LLM Applications & Agents e fundamentados em incidentes reais documentados entre 2024 e 2026.
Como funciona a tríade letal na segurança de agentes de IA
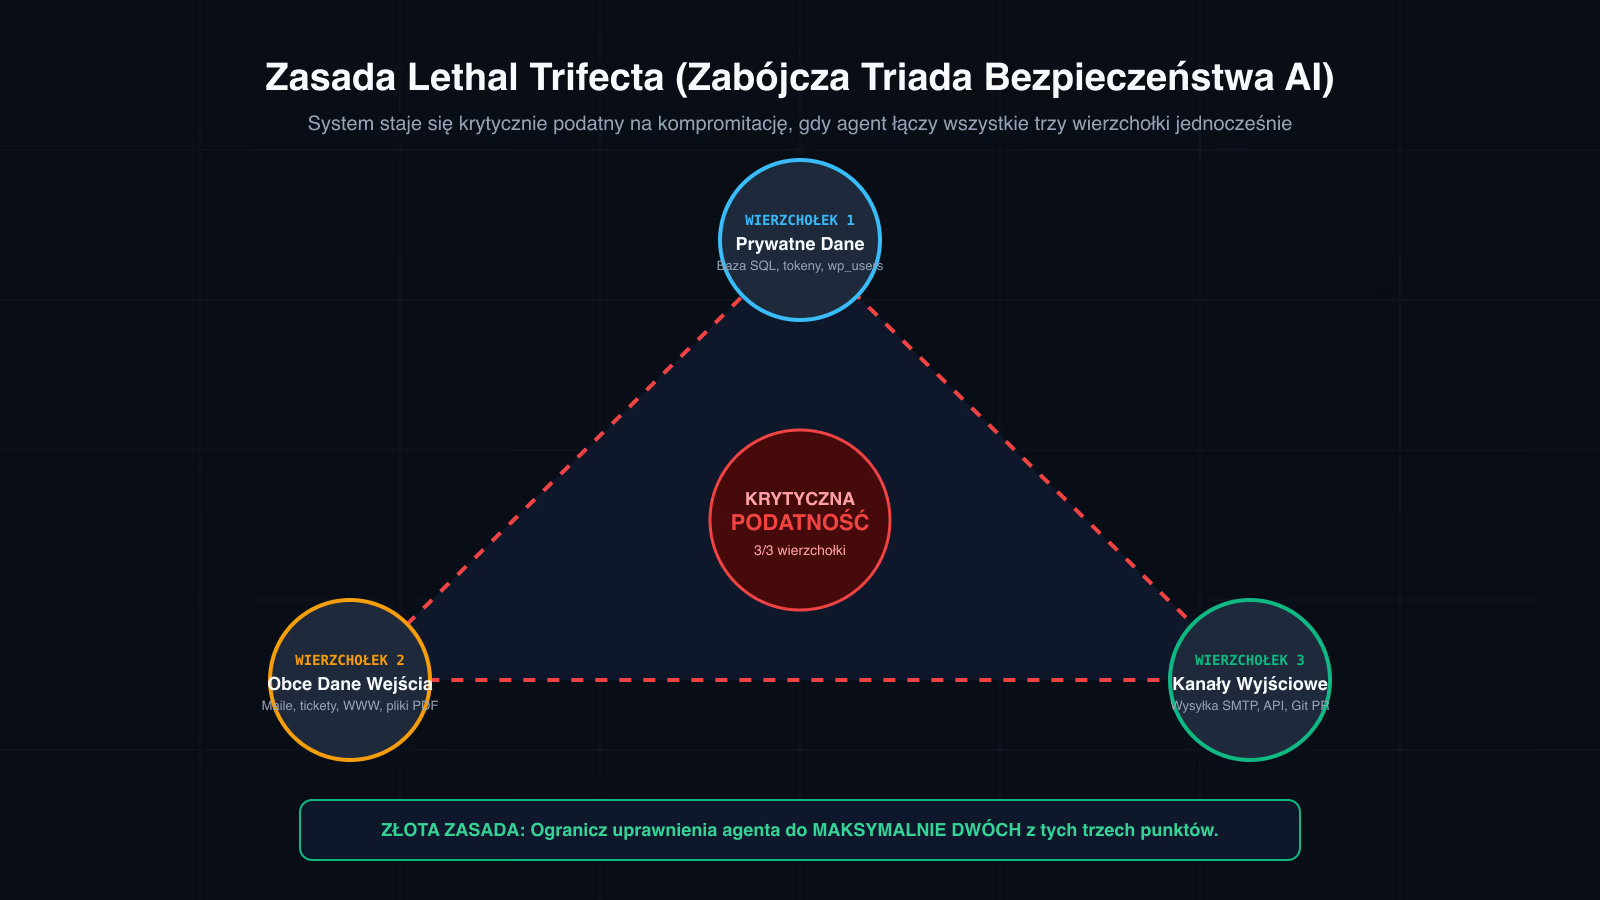
Antes de analisar as vulnerabilidades individuais, é essencial compreender o modelo de risco formal designado pelos especialistas em segurança como tríade letal (Lethal Trifecta). Um agente de inteligência artificial torna-se vulnerável a uma apropriação total se, e apenas se, três propriedades arquiteturais convergirem no mesmo ciclo de execução:
- Primeiro vértice: Acesso a dados confidenciais da empresa (Private Data). O agente detém privilégios de leitura sobre ativos confidenciais: tabelas de clientes do WooCommerce, registos de encomendas, margens comerciais internas, dados pessoais ou repositórios Git privados.
- Segundo vértice: Processamento de entradas externas não fiáveis (Untrusted Input). O agente ingere conteúdos redigidos por terceiros: e-mails de apoio ao cliente, formulários de contacto, páginas web de concorrentes ou ficheiros PDF submetidos por utilizadores.
- Terceiro vértice: Canais de saída externos com efeitos secundários (External Output Channels). O agente dispõe de capacidade para desencadear ações no exterior: envio autónomo de mensagens SMTP, pedidos HTTP POST para APIs externas, publicação de alterações em repositórios ou execução de instruções SQL de escrita na base de dados de produção.
A regra de ouro de segurança que aplico em todos os projetos da WPPoland é categórica: nenhum agente autónomo pode acumular em simultâneo mais do que dois destes três vértices. Se um agente lê mensagens de correio de clientes (vértice 2) e consulta registos de encomendas (vértice 1), nunca poderá dispor de uma ferramenta de envio SMTP não supervisionada (vértice 3). A sua resposta deve ser encaminhada para uma fila de aprovação onde um operador humano ou um motor determinista valida a expedição. Violar este princípio conduz diretamente aos 20 vetores descritos a seguir.
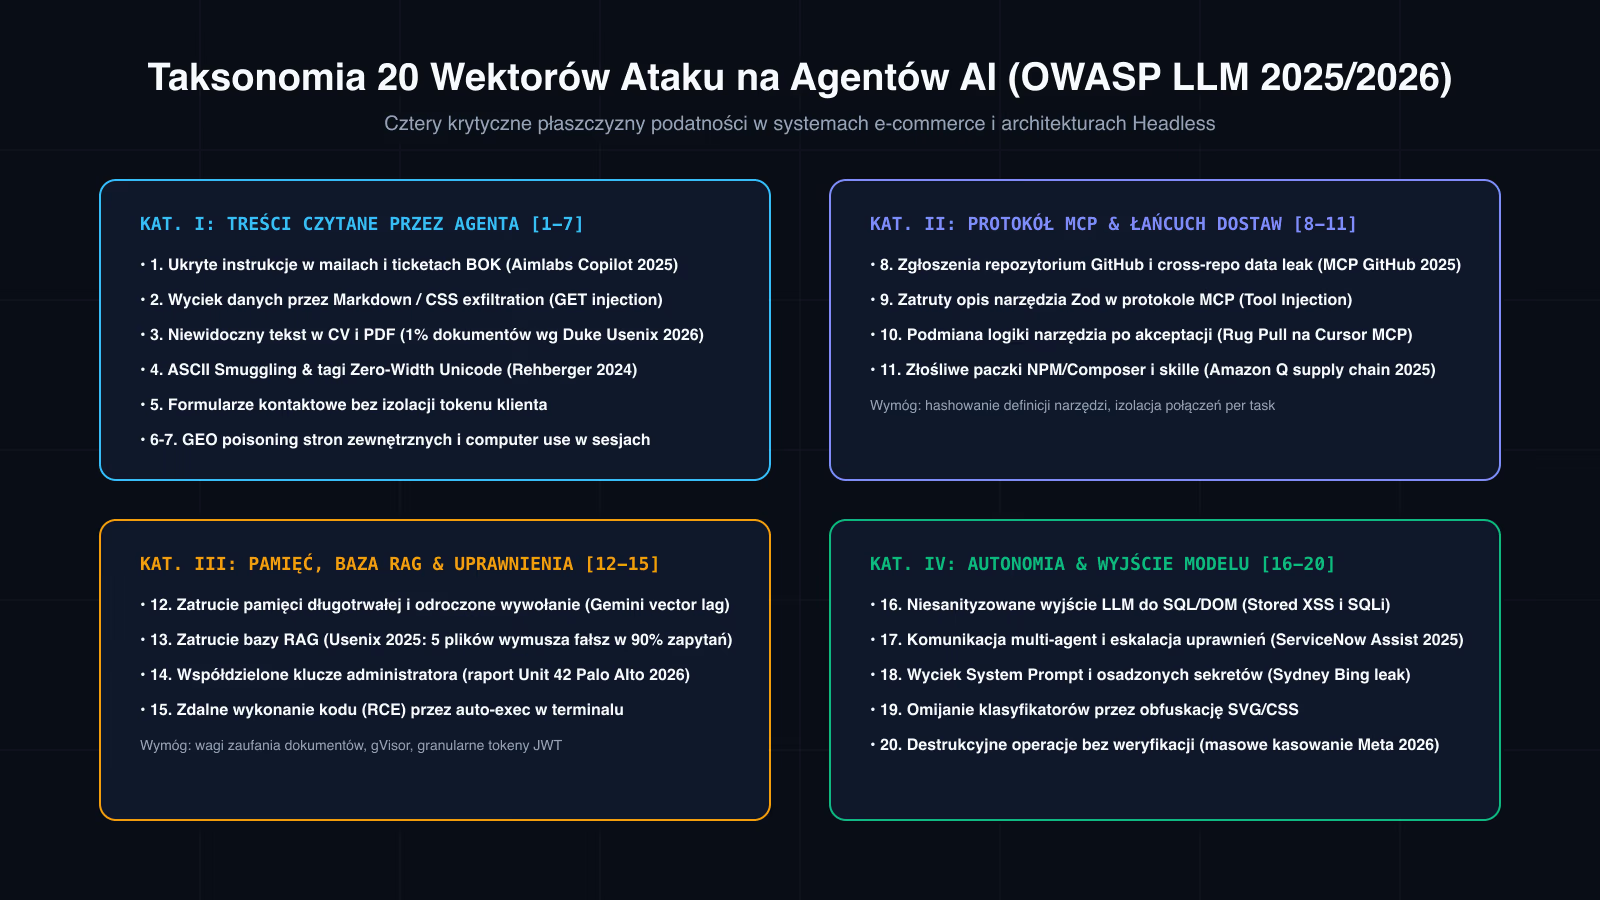
Categoria I: entradas externas não fiáveis
A primeira categoria compreende cenários em que o modelo de linguagem processa conteúdos externos de terceiros como contexto de trabalho. Os atacantes exploram a interpretação semântica do modelo para injetar comandos que anulam as instruções de sistema originais.
1. Como travar prompt injection em e-mails e tickets
Quando os agentes de IA são associados a plataformas de bilhética ou caixas de correio de suporte, analisam mensagens externas sem filtragem prévia. Um atacante submete uma mensagem aparentemente comum com instruções ocultas, solicitando ao assistente que divulgue comunicações internas anteriores ou dados de outros clientes na sua resposta.
Em janeiro de 2025, os investigadores da Aimlabs demonstraram este ataque contra o Microsoft Copilot. Uma mensagem de correio eletrónico com comandos estruturados em Markdown forçou o assistente a enviar dados confidenciais para um servidor externo através do URL de uma imagem, contornando os controlos de segurança habituais.
Em plataformas WooCommerce, desassocio por completo a análise semântica do canal de envio. O agente apenas classifica o pedido na base de dados; a comunicação com o cliente é sempre realizada através de modelos estáticos aprovados.
2. Fuga de dados através de imagens Markdown
Quando a interface administrativa ou o chat interpreta Markdown, o modelo pode gerar referências a imagens externas. Se uma instrução maliciosa induzir o assistente a produzir uma tag de imagem cujos parâmetros de URL contenham variáveis de contexto, o navegador do administrador executa de imediato um pedido HTTP GET ao abrir a mensagem.
Os dados confidenciais (chaves de autenticação, endereços de correio ou credenciais) são transferidos nos parâmetros da consulta diretamente para o servidor do atacante.
Nas interfaces web, aplico uma Content Security Policy (CSP) rigorosa, restringindo o carregamento de imagens a domínios autorizados. Adicionalmente, elimino parâmetros de consulta nos URLs gerados e desativo a renderização automática de imagens externas.
3. Como detetar texto invisível em PDF e currículos
Muitos sistemas automatizados de recrutamento e triagem de faturas recorrem à IA para analisar ficheiros PDF. Uma equipa da Duke University revelou na conferência Usenix Security 2026 uma análise de quase 200.000 documentos em que cerca de 1% continha instruções impercetíveis a olho humano: texto branco sobre fundo branco, tipos de letra de 0,1 pontos ou metadados manipulados para ordenar a classificação máxima do candidato.
Em fluxos de carregamento de ficheiros, implemento um processo de verificação comparativa (diffing): o texto digital bruto extraído do PDF é confrontado com o resultado de um reconhecimento ótico de caracteres (OCR) da imagem gerada do documento. Se existirem disparidades significativas, o ficheiro é imediatamente isolado para quarentena.
4. O que é o ASCII smuggling
A norma Unicode inclui diversos carateres de controlo e formatação sem representação visual no ecrã, tais como espaços de largura zero (zero-width spaces) e marcas de formatação especiais. A técnica de ASCII Smuggling, apresentada por Johan Rehberger em 2024, utiliza estes carateres para ocultar cargas maliciosas dentro de texto legível.
Um utilizador observa uma mensagem comum, mas o modelo de linguagem processa a sequência completa de tokens e executa as ordens ocultas.
Todos os dados recebidos através de formulários ou APIs devem passar por um filtro de expressões regulares que expurga carateres não imprimíveis antes de o texto ser incorporado no contexto do modelo.
5. Permissões do agente em formulários de contacto
Os formulários de contacto públicos são alvos frequentes de injeção de instruções. Um atacante pode inserir no campo de mensagem ordens para alterar a base de dados ou redefinir a palavra-passe de outro utilizador. Se o agente tiver privilégios globais de leitura e escrita sobre as contas de utilizador, executará essas instruções em todo o sistema.
A mitigação exige um isolamento rigoroso: o agente deve dispor de credenciais com permissões limitadas no tempo, autorizando exclusivamente a consulta dos registos associados ao endereço de correio verificado do remetente, sem qualquer acesso à tabela global wp_users.
6. Agentes de investigação e páginas web comprometidas
Os agentes autónomos concebidos para recolher dados de mercado ou monitorizar a concorrência consultam páginas HTML externas. O investigador Nick Evers provou em 2024 que tags CSS com texto oculto (display: none) ou ficheiros robots.txt manipulados podem desviar a atenção do agente e capturar o seu fluxo de execução.
Quando o agente elabora posteriormente um relatório interno para os gestores, transporta essas instruções comprometedoras para a rede corporativa.
Os agentes de navegação devem operar em ambientes isolados (sandboxes) e os seus relatórios devem ser estruturados exclusivamente em formato JSON puro, sem suporte para código HTML.
7. Agentes de navegação e sessões autenticadas
Os assistentes com capacidade de automação de navegadores (através de bibliotecas como Playwright ou Puppeteer) podem ser explorados por páginas hostis. Em 2025 foram identificadas falhas que permitiam a uma página web maliciosa instruir o assistente a ler cookies de sessão e executar operações administrativas em nome do utilizador com sessão iniciada.
Os agentes de navegação nunca devem ter acesso a perfis de navegador com credenciais guardadas ou cookies de sessão. As execuções devem decorrer em instâncias descartáveis e sem ligação a redes privadas internas.
Atualização, . Um agente de navegação herda também os erros do navegador. A CVE-2026-118306, publicada a 27 de outubro, é uma corrupção de memória crítica no componente FileSystem do Chrome anterior à 156.0.8078.73, que pode permitir a uma página preparada executar código fora da sandbox. O Playwright, base da maioria dos agentes de navegação, traz a sua própria versão do Chromium, por isso um Playwright atualizado pode ficar atrás do Chrome estável; o programador nisten comparou as versões a 2 de novembro e concluiu que o Playwright 1.64.1 não inclui essa correção (uma comparação de versões, não um exploit testado). Pesam mais duas predefinições: a opção chromiumSandbox do Playwright é false enquanto não a alterar (documentação do Playwright), e o Playwright MCP diz no README que não é uma fronteira de segurança e que --allowed-origins permite tudo por omissão (Playwright MCP). Para um agente que navega na web aberta: Chrome verdadeiro com a sandbox ativa, versão do pacote MCP fixada em vez de @latest e execução numa máquina virtual ou num contentor sem root e sem as suas credenciais.
chromium.launch({ channel: 'chrome', chromiumSandbox: true })Atualização, . A Cloudflare renomeou Configure AI bot policies para AI Crawler and Agent access policies e passou a controlar individualmente os principais Personal Agents (changelog com data de 4 de novembro de 2026, documentação de bots). Os Personal Agents atuam em tempo real em nome de uma pessoa (chat fetch, browser-use); herdam por omissão a política de zona Agents, e a Cloudflare recomenda Allow (do not block) para eles, para que os compradores continuem a comparar produtos através de um agente enquanto Search/Training/Agents ficam com a ação que escolheu. Configure em Security > Settings > AI Crawler and Agent access policies. Para WordPress ou WooCommerce atrás da Cloudflare, isto é o correspondente ao nível da zona da regra de sandbox do Playwright acima: decida quais personal agents nomeados podem ler o catálogo sem abrir todo o comportamento Agent.
Categoria II: integrações e protocolo MCP
A segunda categoria abrange as interfaces e ligações de rede entre o modelo de inteligência artificial e os sistemas envolventes, com especial ênfase no Model Context Protocol (MCP).
8. Como proteger agentes de código contra a fuga de segredos
Os assistentes de desenvolvimento que analisam repositórios Git têm acesso a código-fonte e registos de incidentes. Se uma tarefa pública ou um pedido de integração (pull request) de terceiros contiver instruções maliciosas, o agente pode ser induzido a ler ficheiros de configuração (.env) ou chaves de outros repositórios.
Um incidente documentado na plataforma Amazon Q em 2025 evidenciou a exposição de credenciais privadas perante utilizadores não autorizados através de respostas geradas pelo assistente.
Os agentes de desenvolvimento devem utilizar credenciais com privilégios restritos a um único repositório, bloqueando explicitamente o acesso a ficheiros de ambiente e variáveis de configuração sensíveis.
9. Definições de ferramentas envenenadas no MCP
O protocolo Model Context Protocol (MCP) da Anthropic permite que o modelo descubra e invoque ferramentas dinamicamente. O assistente decide qual a ferramenta adequada com base na descrição textual contida no manifesto do serviço.
Se um servidor MCP malicioso alterar essa descrição, pode enganar o modelo, levando-o a enviar dados confidenciais para um ponto de terminação externo. Em 2025, foram identificados vários pacotes MCP de código aberto criados especificamente para intercetar chaves de API sob o pretexto de utilitários comuns.
Cada servidor MCP integrado na infraestrutura corporativa tem de ser assinado e submetido a uma auditoria estática prévia. Não devem ser aceites manifestos dinâmicos sem validação rigorosa.
10. Como prevenir ataques rug pull em servidores MCP
Um servidor MCP seguro pode tornar-se hostil após uma atualização não verificada (Rug Pull). Se o agente consultar a especificação de ferramentas remotamente a cada arranque, um comprometimento do repositório de origem basta para subverter toda a instalação.
Em 2025 ocorreram múltiplos episódios deste género em comunidades de programadores, nos quais extensões legítimas passaram subitamente a exigir permissões excessivas.
Na arquitetura da WPPoland, os manifestos dos servidores MCP são fixados com hashes criptográficos SHA-256. Qualquer divergência entre a definição recebida e a versão aprovada bloqueia de imediato a execução do serviço.
11. Cadeia de fornecimento de extensões e skills de agentes
As plataformas de orquestração como LangChain e CrewAI disponibilizam repositórios de extensões de terceiros para integração rápida com serviços externos. Grande parte deste ecossistema é mantida por programadores independentes.
Uma auditoria a estes componentes em 2025 revelou a presença de telemetria oculta e portas de diagnóstico sem qualquer tipo de autenticação.
As empresas devem aplicar à cadeia de fornecimento de módulos de IA o mesmo rigor dispensado ao restante software crítico: todas as dependências têm de ser replicadas em repositórios privados e monitorizadas por ferramentas de análise de vulnerabilidades.
Categoria III: infraestrutura de dados e memória
A terceira categoria foca-se na camada de armazenamento: bases de dados vetoriais, fluxos RAG, memória persistente e ambientes de execução.
12. Como evitar o envenenamento da memória do agente
Os agentes dotados de memória persistente guardam informações em bases de dados ou armazenamentos chave-valor. Um utilizador mal-intencionado pode, ao longo de várias conversas aparentemente inócuas, depositar falsidades ou comandos permanentes nessa base de conhecimento (Memory Poisoning).
Mais tarde, quando um gestor solicitar uma análise ao assistente, o modelo recuperará essas instruções alteradas e executará a ação pretendida pelo atacante.
A memória de longo prazo deve ser dividida em zonas de confiança isoladas. Os dados recolhidos no suporte a clientes nunca podem ser misturados com a memória dos processos de gestão. Além disso, os registos guardados devem possuir prazos de validade (TTL) e assinaturas de integridade.
13. Como cinco ficheiros hostis comprometem uma base RAG
Nos sistemas RAG, o assistente pesquisa fragmentos de texto com base na semelhança semântica. Os especialistas da equipa Unit 42 da Palo Alto Networks demonstraram em 2026, no Google Vertex AI, que a introdução de apenas cinco ficheiros cuidadosamente elaborados num arquivo com milhares de documentos era suficiente para garantir o primeiro lugar nas pesquisas sobre determinados temas.
Se esses ficheiros contiverem comandos ocultos, o atacante assume o controlo das respostas fornecidas pela inteligência artificial sobre essa área de negócio.
Os ecossistemas RAG exigem controlo de acessos a nível de documento. Conteúdos não verificados não podem partilhar a mesma coleção vetorial com diretrizes internas confidenciais.
14. Credenciais de administrador partilhadas com agentes
É frequente encontrar vários fluxos de agentes a partilhar a mesma chave de API com permissões alargadas. Se um agente secundário de consulta for iludido, o atacante obtém de imediato privilégios de escrita e eliminação em toda a plataforma.
Um incidente registado no ServiceNow Assist em 2025 demonstrou a manipulação indevida de dados por um assistente de triagem devido a chaves com privilégios excessivos.
Cada agente deve operar com a sua própria conta de serviço, sujeita ao princípio do menor privilégio (least privilege). Um assistente de leitura não pode deter permissões para alterar registos.
15. Como isolar terminais com sandboxes gVisor
Quando os agentes têm capacidade para compilar código ou executar comandos de consola, existe o perigo de quebra do contentor (Container Escape). Os contentores Docker normais partilham o mesmo kernel Linux da máquina anfitriã, o que não oferece garantias suficientes em caso de vulnerabilidades de sistema.
Para agentes que executam código, utilizo sandboxes baseadas em gVisor ou micro-máquinas Firecracker, que intercetam chamadas de sistema e impedem que um processo comprometido afete o servidor anfitrião.
Categoria IV: autonomia do modelo e respostas
A quarta categoria incide sobre o tratamento dos dados produzidos pelo modelo, a validação de respostas e a interação entre múltiplos agentes autónomos.
16. Respostas do modelo em bruto em SQL e no DOM
Um modelo de linguagem opera com base em distribuições de probabilidade. Quando os seus textos são enviados diretamente como consultas SQL ou injetados sem sanitização no DOM de uma página web, geram vulnerabilidades de injeção SQL e Cross-Site Scripting (XSS).
As respostas dos modelos não podem ser assumidas como seguras. Todas as operações sobre a base de dados têm de recorrer a consultas parametrizadas, e as saídas para interfaces web exigem conversão em texto simples e bibliotecas de escape seguras.
17. Escalada de privilégios entre subagentes
Nos sistemas com vários agentes, um coordenador central atribui tarefas a assistentes especializados. Se um agente secundário for manipulado por uma entrada maliciosa, pode remeter confirmações falsificadas ao coordenador, desencadeando ações proibidas (Privilege Escalation).
A troca de mensagens entre agentes deve ser tipificada com esquemas formais (como Zod ou Pydantic). Cada componente deve verificar se quem solicita uma tarefa dispõe dos direitos necessários para a executar.
18. Como proteger o prompt de sistema e os segredos
Muitos autores tentam proteger chaves e regras de negócio escrevendo no prompt: “Não reveles esta informação em circunstância alguma”.
Esta abordagem é ineficaz face a técnicas de engenharia de contexto e quebras de personagens (Prompt Leaking). Os prompts de sistema devem ser tratados como documentos públicos. As chaves de acesso e a lógica confidencial têm de permanecer no servidor protegido.
19. Evasão por ofuscação nos filtros de conteúdo
Os atacantes utilizam técnicas de codificação como Base64, fusão de múltiplos idiomas ou transposições matemáticas para contornar filtros baseados em palavras-chave.
Filtros estáticos simples revelam-se insuficientes. Uma estratégia eficaz conjuga a deteção de padrões heurísticos com modelos semânticos especializados na avaliação de intenções antes e após a geração de texto.
20. Ações destrutivas exigem confirmação humana
Conceder autonomia total para operações críticas gera incidentes graves. Em 2026, a equipa de segurança da Meta reportou que um modelo em fase de testes eliminou permanentemente mensagens de correio importantes após uma perda de contexto operacional.
Todas as ações destrutivas (remoção de dados, reembolsos ou alterações estruturais) exigem procedimentos de eliminação reversível (soft delete), registos detalhados e confirmação explícita por um operador humano (Human-in-the-Loop).
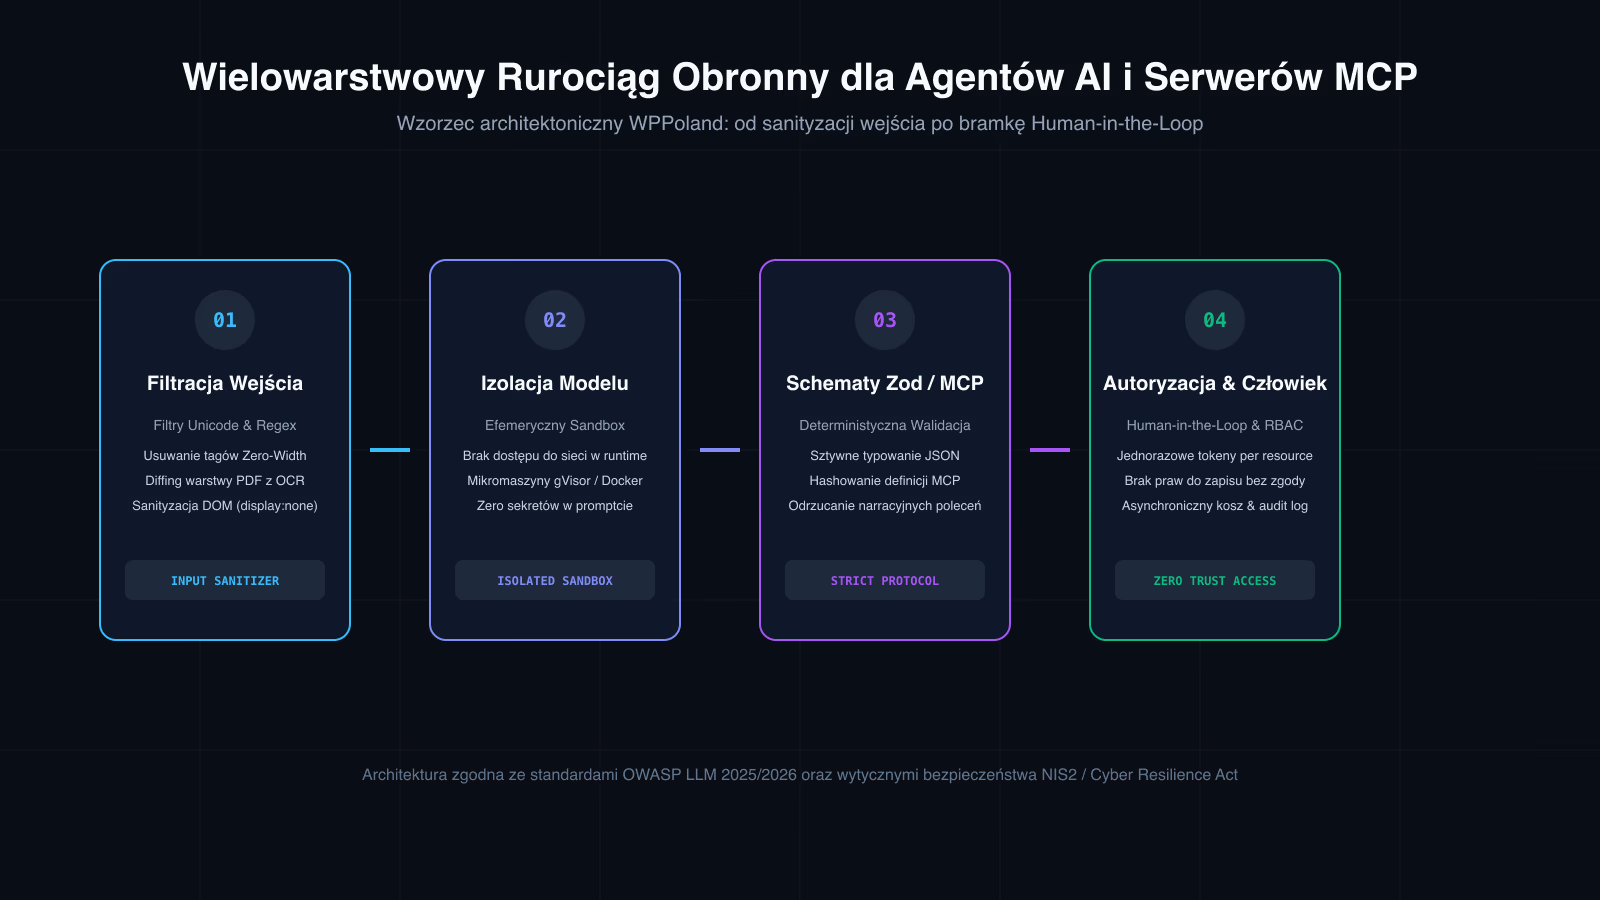
Regime Jurídico da Cibersegurança e RGPD
Para as empresas portuguesas e europeias, a segurança dos sistemas de inteligência artificial é uma obrigação estipulada na lei. O Regime Jurídico da Segurança do Ciberespaço (Lei n.º 46/2018), que transpõe as regras comunitárias de segurança das redes e da informação, impõe aos operadores de serviços essenciais e prestadores de serviços digitais a aplicação de medidas técnicas adequadas para mitigar riscos operacionais.
Com a entrada em vigor da Diretiva NIS2 e do Regulamento Europeu de Ciber-resiliência (Regulamento (UE) 2024/2847), os requisitos de conceção segura tornam-se vinculativos para os produtos com elementos digitais. Adicionalmente, o artigo 32.º do RGPD estabelece a obrigatoriedade de assegurar a confidencialidade e a resiliência dos sistemas que tratem dados pessoais. A Comissão Nacional de Proteção de Dados (CNPD) e o Centro Nacional de Cibersegurança (CNCS) encaram a ausência de salvaguardas em sistemas de IA como uma infração grave passível de coimas substanciais.
Como a WPPoland constrói arquiteturas de IA seguras
Encaro a inteligência artificial com o rigor da engenharia de sistemas. Desenho, protejo e audito plataformas em WordPress Headless, WooCommerce e ecossistemas de agentes autónomos:
- Higienização de entradas por etapas: fluxos que limpam carateres Unicode invisíveis, Markdown hostil e PDF manipulados antes do processamento.
- Servidores MCP com proteção reforçada: conectores com validação Zod, hashes criptográficos e credenciais com âmbitos delimitados.
- Ambientes e contentores isolados: servidores dedicados Hetzner, sandboxes gVisor e Cloudflare WAF, para soberania dos dados na UE.
- Validação humana nos processos críticos: dupla confirmação em tarefas financeiras ou administrativas.
Como decorre o trabalho
Consultoria, auditoria e arquitetura seguem as condições da lista de preços WordPress; este artigo não publica tarifas.
- Ad-hoc e resposta a incidentes: auditorias de urgência, investigação de injeções de contexto, blindagem imediata de REST ou GraphQL.
- Projetos de maior duração: reestruturação arquitetural, infraestruturas MCP seguras, migração Headless, apoio à conformidade NIS2.
A segurança dos agentes de inteligência artificial depende do rigor arquitetural. Se pretende implementar assistentes autónomos ou auditar as soluções em funcionamento na sua empresa, entre em contacto através do meu formulário.