Durante quase toda a história dos motores de pesquisa, a página de resultados foi uma lista de dez links azuis. Em 2026, uma parte crescente das pesquisas termina antes numa resposta escrita: o Google mostra AI Overviews e AI Mode, o ChatGPT tem uma funcionalidade de pesquisa e o Perplexity responde com fontes numeradas. Cada uma destas respostas tem links para as páginas que utilizou.
Isto muda aquilo pelo qual um site WordPress compete. O objetivo continua a ser posicionar-se bem, mas passa também por ser uma das fontes que um motor de respostas cita. Este guia reúne o que os próprios fornecedores documentam sobre a forma como os seus sistemas encontram e mostram páginas, quais os crawlers que tem de deixar entrar e como escrever e marcar o conteúdo para que um modelo consiga extrair dele uma afirmação clara.
Como os motores de respostas com IA mudam a pesquisa em 2026
As AI Overviews e o AI Mode do Google, o Perplexity e a pesquisa do ChatGPT mudaram a forma como as pessoas encontram informação. Muitos utilizadores já não querem uma lista de sites para abrir um a um; querem uma resposta resumida que lhes poupe tempo, com links que possam seguir quando precisam de pormenores ou querem confirmar uma afirmação.
Porque é importante ser a fonte citada
Todas as respostas de IA vêm acompanhadas de citações. Ser a fonte de um facto concreto passou a ser um objetivo em si mesmo. No SEO clássico competia por uma de dez posições; numa resposta de IA compete para ser um dos poucos links mostrados ao lado do parágrafo que responde à pergunta.
Motor de pesquisa versus motor de respostas
Um motor de pesquisa clássico funciona como intermediário que envia visitantes para os sites. Um motor de respostas lê várias fontes e escreve uma síntese para o utilizador. A sua página continua a ter de ser encontrada e indexada, mas precisa também de conter afirmações que possam ser citadas isoladamente, sem o parágrafo que as rodeia.
Como o Google AI Overviews e o AI Mode escolhem as páginas
O Google publica um único documento para proprietários de sites sobre este tema, a página sobre funcionalidades de IA no Google Search Central. É curta e contradiz muito do que se vende como “SEO para IA”.
Segundo o Google, as AI Overviews ajudam as pessoas a captar mais depressa o essencial de um tema ou de uma pergunta complexa, enquanto o AI Mode se destina a pesquisas que exigem mais exploração, raciocínio ou comparações complexas. Ambos podem usar uma técnica a que o Google chama query fan-out: o sistema faz várias pesquisas relacionadas sobre subtemas e fontes de dados e depois monta a resposta a partir do que essas pesquisas devolvem. Uma página pode, por isso, ser citada por um subtema que cobre bem, mesmo que não se posicionasse para a pergunta original.
A regra de elegibilidade é a mesma dos resultados de pesquisa normais. Uma página tem de estar indexada e ser elegível para aparecer na Pesquisa Google com um excerto. O Google afirma que não há requisitos técnicos adicionais nem otimizações especiais necessárias. Não precisa de novos ficheiros legíveis por máquinas, de ficheiros de texto para IA nem de marcação extra, e não existem dados estruturados schema.org especiais a acrescentar para estas funcionalidades.
O Google escreve também que as funcionalidades de IA podem mostrar um conjunto de links mais amplo e diversificado do que uma pesquisa web clássica, e que as AI Overviews só aparecem quando os seus sistemas decidem que acrescentam algo à Pesquisa clássica. Para um site WordPress, isto significa que a base é SEO técnico comum: páginas que podem ser rastreadas e indexadas, sem bloqueio de excertos, e que valem a pena citar.
Como ser citado nas respostas de IA
A AIO (otimização para IA) é muitas vezes apresentada como o passo seguinte ao SEO clássico. A documentação do Google acima mostra que o lado técnico não tem requisitos especiais, pelo que o trabalho passa para o conteúdo: até que ponto é claro, verificável e original.
Clareza das afirmações: escreva frases que um modelo possa citar
Evite o enchimento. Use frases declarativas. Em vez de escrever que acha que bloquear bots de IA talvez prejudique a sua visibilidade, escreva: bloquear o Google-Extended não afeta a inclusão nem o posicionamento na Pesquisa Google. A segunda frase nomeia o sujeito, faz uma única afirmação verificável e pode ser copiada para uma resposta sem edição.
Clareza não significa simplificação. Significa ser preciso e direto, e apoiar a afirmação numa fonte que o leitor possa abrir. Uma frase que depende do parágrafo anterior, do tipo é por isso que isto importa, não pode ser extraída sozinha, por isso cada afirmação importante deve ter o seu próprio sujeito.
Ganho de informação: dê ao modelo algo que não encontra noutro lado
Se apenas repetir o que diz a Wikipédia, um motor de respostas tem poucas razões para escolher a sua página entre as dezenas que dizem o mesmo. As páginas que merecem ser citadas acrescentam algo: medições originais, dados dos seus próprios projetos, uma comparação feita por si ou a explicação de quem trabalha na área sobre porque é que uma definição documentada se comporta de certa forma em produção.
Títulos que funcionam como respostas autónomas
Os motores de respostas trabalham com passagens, não com artigos inteiros. Estruture os títulos de modo a refletirem a lógica do tema e escreva cada secção para que continue a fazer sentido quando lida isoladamente. Um título formulado como as pessoas pesquisam (“como bloquear o GPTBot no WordPress”), seguido de uma resposta direta na primeira frase, é mais fácil de associar a uma pesquisa do que um título engenhoso.
Como adicionar uma caixa de pontos-chave no WordPress
No wppoland.com colocamos um resumo estruturado dos factos principais no topo dos artigos longos. A razão é simples: um bloco curto de afirmações autónomas é fácil de percorrer para o leitor e fácil de analisar, citar e confrontar com o resto da página para qualquer sistema.
Como implementá-la com o Gutenberg
Use um bloco de grupo ou de lista do Gutenberg com o estilo de uma caixa de “Pontos-chave”. Nos bastidores, mantenha os dados estruturados Article da página coerentes com o que a caixa diz. O Google não exige marcação especial para as funcionalidades de IA, por isso trate a caixa antes de mais como conteúdo: tem de ser verdadeira, ter fontes e estar visível para o leitor.
O que a caixa deve conter
Uma caixa útil nomeia a entidade principal, enumera três a cinco factos verificáveis com valores concretos, indica a data em que os factos foram verificados pela última vez e tem um link para a fonte primária de cada um. Evite afirmações de marketing; uma afirmação que ninguém consegue verificar é má candidata a citação.
Como escrever FAQ para pesquisas em IA
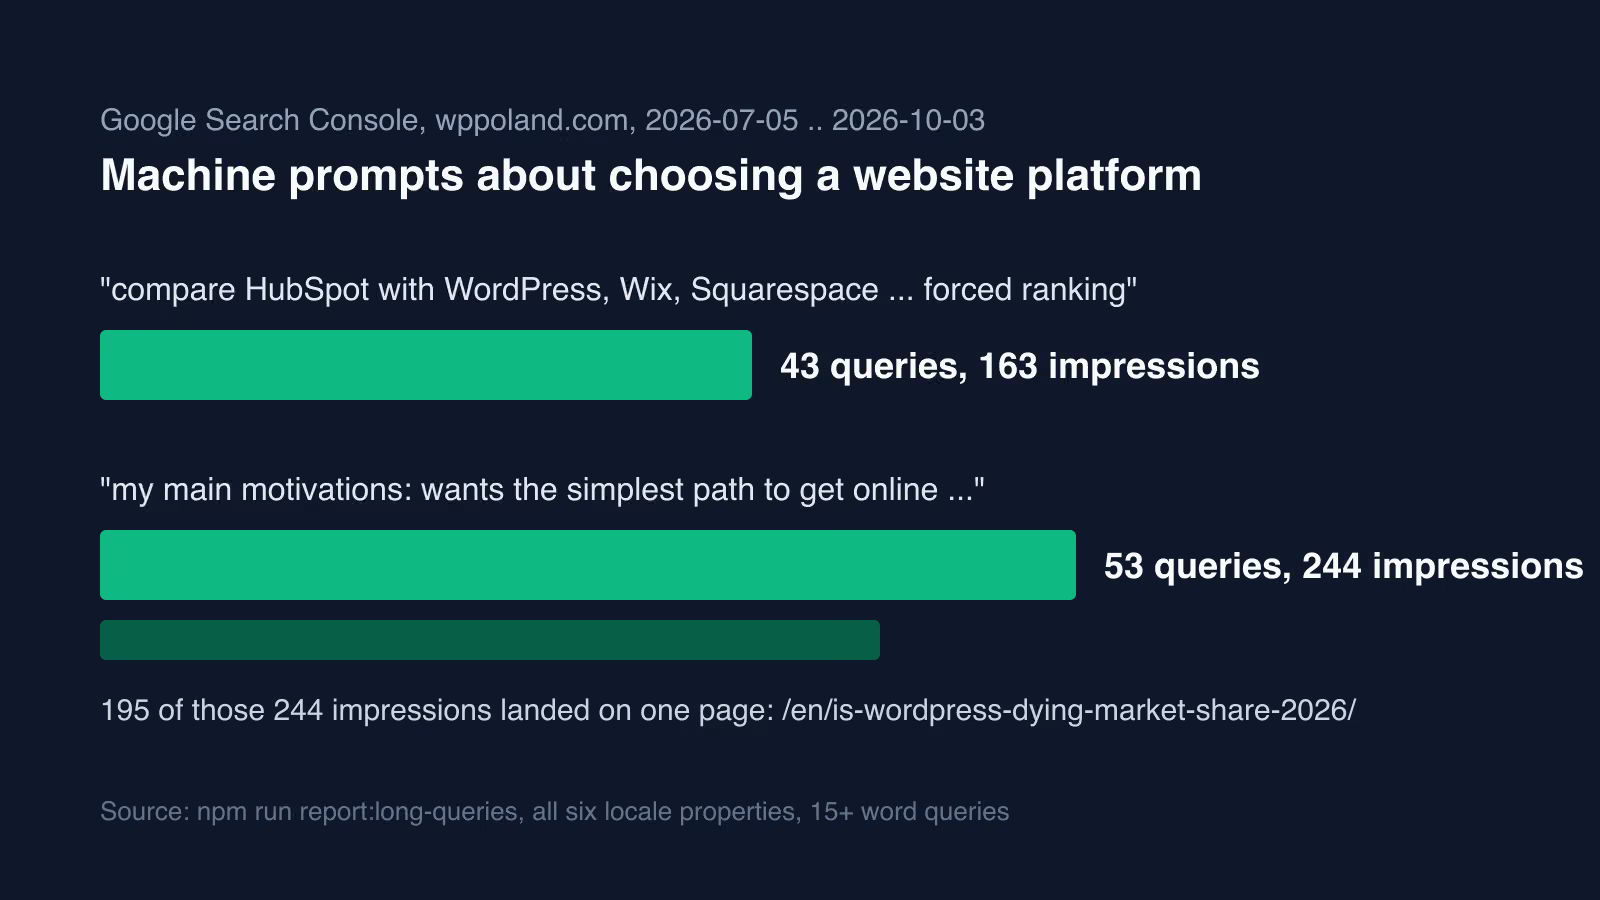
As pesquisas em IA são muitas vezes longas e em tom de conversa: Como escalo um WordPress Multisite para 100 subdomínios empresariais com Docker?
Formule as perguntas como os utilizadores as fazem
Use a secção de FAQ de forma deliberada. Formule as perguntas exatamente como um utilizador as diria ao telemóvel ou as escreveria numa caixa de chat. Deixe de lado o jargão interno e a linguagem académica.
Responda ao como e ao porquê
Responda ao “como” e ao “porquê”, não apenas ao “o quê”. Uma resposta de uma linha raramente ajuda alguém; uma resposta que inclui a condição em que é verdadeira, e um exemplo, é mais útil para o leitor e dá ao motor de respostas uma passagem completa com que trabalhar.
Mantenha expectativas realistas quanto à marcação. Desde agosto de 2023, o Google só mostra resultados enriquecidos de FAQ para sites governamentais e de saúde conhecidos e com autoridade (blog do Google Search Central). Os dados estruturados de FAQ continuam a descrever a página, mas não vão gerar um resultado enriquecido de FAQ num site empresarial WordPress típico.
Pesquisas de cauda longa em tom de conversa
Em vez de uma página dirigida a “SEO para WordPress”, escreva conteúdo que responda a perguntas como “como melhorar o SEO de uma loja WooCommerce com produtos em várias línguas”. São pesquisas específicas como estas que as pessoas escrevem nos motores de respostas.
Que crawlers de IA permitir no robots.txt
Cada fornecedor separa os crawlers que alimentam o seu produto de pesquisa dos crawlers que recolhem dados de treino e dos fetchers que atuam em nome de um único utilizador. Bloquear o errado retira-o das respostas; bloquear o certo mantém o seu conteúdo fora do treino sem perder visibilidade. A tabela abaixo foi construída a partir da documentação de cada fornecedor.
| Fornecedor | Crawler de pesquisa | Crawler de treino | Fetcher acionado pelo utilizador | Notas do fornecedor |
|---|---|---|---|---|
| OpenAI | OAI-SearchBot | GPTBot | ChatGPT-User | Definições independentes; alterações ao robots.txt demoram cerca de 24 horas |
| Perplexity | PerplexityBot | nenhum indicado | Perplexity-User | O PerplexityBot não é usado para treinar modelos de base |
| Anthropic | Claude-SearchBot | ClaudeBot | Claude-User | Suporta Crawl-delay; bloquear IP não é uma forma fiável de exclusão |
| Googlebot | Google-Extended (só token) | n/a | O Google-Extended não afeta a Pesquisa Google |
OpenAI: OAI-SearchBot, GPTBot e ChatGPT-User
Segundo a documentação de crawlers da OpenAI, o OAI-SearchBot serve para mostrar sites nas funcionalidades de pesquisa do ChatGPT, e os sites que o excluem não aparecem nas respostas da pesquisa do ChatGPT. O GPTBot rastreia conteúdo que pode ser usado para treinar os modelos de base generativos da OpenAI; bloqueá-lo sinaliza que o seu conteúdo não deve ser usado para treino. Cada definição é independente, por isso pode permitir o OAI-SearchBot e bloquear o GPTBot. O ChatGPT-User visita uma página quando um utilizador faz uma pergunta ao ChatGPT ou a um GPT personalizado; como é uma pessoa que inicia essa ação, as regras do robots.txt podem não se aplicar, e a OpenAI diz que o ChatGPT-User não é usado para decidir se o conteúdo pode aparecer na pesquisa. A OpenAI indica que os seus sistemas podem demorar cerca de 24 horas a ajustar-se depois de uma alteração ao robots.txt e publica listas de IP para cada bot (por exemplo openai.com/searchbot.json).
Perplexity: PerplexityBot e Perplexity-User
A documentação do Perplexity descreve o PerplexityBot como o crawler que mostra sites e cria links para eles nos resultados de pesquisa do Perplexity, e recomenda permiti-lo no robots.txt se quiser aparecer aí. O Perplexity afirma que não é usado para rastrear conteúdo para modelos de base de IA. O Perplexity-User apoia ações dos utilizadores: quando alguém faz uma pergunta, pode visitar uma página para ajudar a responder. Como foi o utilizador a pedir o acesso, em geral ignora as regras do robots.txt. Ambos têm intervalos de IP publicados.
Anthropic: ClaudeBot, Claude-SearchBot e Claude-User
O artigo de ajuda da Anthropic sobre os seus crawlers enumera três agentes. O ClaudeBot recolhe conteúdo web que pode contribuir para o treino; bloqueá-lo deverá excluir o seu material futuro dos conjuntos de dados de treino. O Claude-SearchBot rastreia para melhorar a qualidade dos resultados de pesquisa; bloqueá-lo significa que o seu conteúdo não é indexado para pesquisa, o que pode reduzir a sua visibilidade nas respostas. O Claude-User obtém páginas quando um utilizador do Claude faz uma pergunta que precisa delas; bloqueá-lo impede o Claude de obter a sua página para esses utilizadores. Os bots da Anthropic respeitam o robots.txt e suportam a diretiva não padrão Crawl-delay. A Anthropic avisa que bloquear os seus endereços IP pode não funcionar como forma de exclusão, porque os bots deixam de conseguir ler o seu robots.txt.
Google-Extended e Pesquisa Google
A lista de crawlers comuns do Google descreve o Google-Extended como o controlo que define se o conteúdo rastreado pelo Google pode ser usado para treinar futuros modelos Gemini e para grounding em alguns produtos Gemini. O Google afirma que o Google-Extended não afeta a inclusão de um site na Pesquisa Google e não é um sinal de posicionamento. Não tem um user agent HTTP próprio; é apenas um token do robots.txt. As AI Overviews e o AI Mode fazem parte da Pesquisa, por isso o controlo sobre eles é o acesso do Googlebot mais os controlos de excertos descritos mais abaixo.
Como editar o robots.txt no WordPress para crawlers de IA
Se não existir um ficheiro robots.txt físico na raiz do site, o WordPress serve um virtual através de do_robots(), uma função presente desde o WordPress 2.1. O seu resultado passa pelo filtro robots_txt (disponível desde o WordPress 3.0), que recebe o texto gerado e um indicador que diz se o site é público. Esse filtro é o sítio certo para acrescentar regras para crawlers de IA a partir de um tema ou de um pequeno plugin:
add_filter( 'robots_txt', function ( $output, $public ) {
    if ( ! $public ) {
        return $output;
    }
    $output .= "\nUser-agent: GPTBot\nDisallow: /\n";
    $output .= "\nUser-agent: ClaudeBot\nDisallow: /\n";
    $output .= "\nUser-agent: Google-Extended\nDisallow: /\n";
    return $output;
}, 10, 2 );
Este exemplo mantém o site fora dos três crawlers de treino e deixa intactos o OAI-SearchBot, o PerplexityBot, o Claude-SearchBot e o Googlebot, pelo que o site continua elegível para as respostas de pesquisa desses serviços. A verificação do indicador público deixa em paz os sites que desencorajam os motores de pesquisa. Se o seu alojamento ou um plugin de SEO escrever um ficheiro robots.txt físico, o servidor web normalmente serve esse ficheiro diretamente e o filtro nunca é executado, por isso edite antes o ficheiro. Depois da alteração, abra /robots.txt no navegador e confirme que as regras lá estão.
Como limitar o que as funcionalidades de IA mostram das suas páginas
A página do Google sobre funcionalidades de IA remete os proprietários de sites para os mesmos controlos que regem os excertos normais. O acesso do Googlebot no robots.txt decide se uma página pode sequer ser rastreada. Para além disso:
noindexmantém uma página totalmente fora da Pesquisa e, portanto, fora das AI Overviews e do AI Mode.nosnippetimpede o Google de mostrar um excerto de texto da página, o que também limita a sua utilização nas funcionalidades de IA.data-nosnippetnum elemento HTML exclui dos excertos apenas essa parte da página.max-snippetdefine o comprimento máximo do excerto em caracteres.
No WordPress, o noindex e as diretivas meta robots costumam ser definidos através do plugin de SEO que já usa, enquanto o data-nosnippet é um atributo que acrescenta na vista HTML do editor de blocos ou num template. Use-os em conteúdo que não quer ver resumido, como material pago, em vez de bloquear o Googlebot, o que retiraria a página também dos resultados clássicos.
Que schema usar para a pesquisa com IA
O Google diz claramente que as AI Overviews e o AI Mode não precisam de marcação schema.org especial. Os dados estruturados continuam a ajudar uma página na Pesquisa clássica e descrevem-na sem ambiguidade a qualquer sistema que os leia, por isso vale a pena mantê-los corretos.
Schema Article para além do básico
Para além da marcação Article básica, propriedades como about, mentions, citation e speakable descrevem o que a página aborda e em que fontes se apoia. Mantenha-as coerentes com o texto visível; marcação que afirma mais do que a página mostra não ajuda ninguém.
Schema Person para autores
Dê a cada autor uma entidade Person com a sua função, afiliação e links para perfis profissionais que possam ser verificados. Isto reforça os sinais de confiança abordados abaixo e ajuda o leitor, humano ou máquina, a ver quem está por trás de uma afirmação.
Como medir o tráfego da pesquisa com IA
O Google contabiliza o tráfego das funcionalidades de IA no tráfego de pesquisa global do Search Console. Aparece no relatório de Desempenho no tipo de pesquisa “Web” e não é apresentado em separado, por isso não vai encontrar lá um filtro dedicado às AI Overviews.
Para os outros motores, comece pelos registos do servidor. Filtre os pedidos pelos user agents indicados acima (OAI-SearchBot, ChatGPT-User, PerplexityBot, Perplexity-User, Claude-SearchBot, Claude-User) para ver que páginas cada fornecedor obtém, e compare os endereços de origem com as listas de IP que os fornecedores publicam, porque as strings de user agent são fáceis de falsificar. Depois, veja o tráfego de referência na sua ferramenta de análise para visitas vindas dos domínios dos motores de respostas, e verifique manualmente os seus temas principais em cada motor para ver se as suas páginas aparecem como fontes. Repita essa verificação ao longo de vários dias e conte em quantos a página apareceu: uma verificação isolada quase nada diz, e a secção seguinte mostra porquê.
Porque desaparece o meu site das respostas de IA de um dia para o outro?
Atualização, . A 29 de outubro de 2026 a Ahrefs publicou um estudo sobre a estabilidade das citações em IA, da autoria de Mateusz Makosiewicz. Durante 20 dias, a Ahrefs repetiu diariamente as mesmas perguntas no Google AI Mode, no Google AI Overviews, no ChatGPT, no Gemini e no Copilot e acompanhou cerca de 37 500 citações. Os dados vêm do Brand Radar, produto da própria Ahrefs, pelo que se trata de investigação de um fornecedor. Os resultados que mudam a forma de trabalhar de um site empresarial:
- Metade ou mais das citações tinha desaparecido no dia seguinte: cerca de 60% no AI Mode e no ChatGPT, 50% no AI Overviews e 80% no Gemini e no Copilot. No ChatGPT, no AI Mode e no AI Overviews, apenas 4,0% a 6,8% das citações duraram os 20 dias.
- Cerca de 75% das citações perdidas regressaram durante o estudo, metade delas em três dias. Entre 20% e 27% das citações do primeiro dia saíram de vez.
- As páginas que tinham posição no Google para a pergunta mantiveram a citação durante sete dias ou mais em 29% dos casos no AI Overviews e em 28% no AI Mode. As páginas sem posição ficaram pelos 4%.
- O tráfego orgânico distinguiu as citações duradouras das de um só dia (mediana de 88 visitas mensais contra 8 no AI Overviews). O Domain Rating ficou entre 64 e 78 nos dois grupos.
- Quando a pergunta incluía o nome de uma marca, as páginas da própria marca foram citadas para factos em 97% a 100% dos dias. Para avaliações, as ferramentas de IA do Google citaram-nas apenas em 0% a 5% dos dias.
- As perguntas do tipo «melhor X» foram as que mais mudaram, e 64% das respostas do Gemini e 53% das do Copilot não indicaram qualquer fonte.
No mesmo dia, o Search Engine Roundtable noticiou uma entrevista que David Iwanow gravou com John Mueller, da Google, no Search Central Live Deep Dive Europe 2026 (vídeo). Segundo essa notícia, Mueller afirmou que as listas do tipo «top 10» não são spam por si só, mas que uma estratégia assente em milhares delas é arriscada. Os truques que se espalham depressa acabam por ser reconhecidos e desvalorizados pelos sistemas, como aconteceu com o excesso de palavras-chave e o texto branco sobre fundo branco, e convém questionar os consultores que prometem resultados extraordinários. Não consegui obter a transcrição do vídeo, por isso o que fica aqui é o relato da notícia.
O que deve um site empresarial fazer agora com as citações em IA?
- Medir em quantos dos últimos sete dias a página foi citada. Esperar duas a três semanas antes de reescrever uma página que deixou de aparecer.
- Trabalhar as posições no Google para as perguntas em que quer ser citado e dar a essas páginas títulos que correspondam às perguntas.
- Manter atualizadas e fáceis de encontrar as páginas da oferta, dos serviços e do contacto. Nas perguntas que incluem o nome da empresa, são essas as páginas que a resposta cita.
- Contar as menções à marca separadamente das ligações, porque as páginas citadas muitas vezes não são nomeadas no texto da resposta.
- No Gemini e no Copilot, confirmar primeiro se a resposta indicou alguma fonte antes de contar uma citação em falta como perda.
Que táticas de pesquisa com IA deve um site empresarial abandonar?
- Listas em série do tipo «melhor contabilista em Lisboa» que colocam a própria empresa em primeiro lugar. Foi este tipo de estratégia que Mueller classificou de arriscada, e as respostas a «melhor X» são as citações menos estáveis nos dados da Ahrefs.
- Compra de ligações para subir o Domain Rating a pensar na IA. Neste estudo, foram o tráfego e as posições que distinguiram as citações duradouras, e as ligações só contam na medida em que ajudam a página a ganhar posição.
- Contratos que garantem citações em IA. Com 50% a 80% das citações a mudar de um dia para o outro, ninguém consegue cumprir essa garantia.
É assim que trabalho na otimização SEO e GEO para WordPress: primeiro as posições e páginas corretas, depois as citações medidas ao longo de semanas.
Como tornar o seu conteúdo fiável para a IA
Os motores de respostas podem repetir os erros que encontram, por isso uma página que torna as suas afirmações fáceis de verificar é uma fonte mais segura para citar. Para tornar a sua mais fácil de confiar:
- Inclua um link para a fonte primária de cada afirmação importante, como documentação oficial, uma norma ou notas de versão.
- Mantenha o seu schema de autor (
Person) completo, mostrando que quem escreve trabalha na área. - Date os seus factos e atualize-os quando a fonte muda; um número desatualizado é pior do que nenhum.
Saiba mais sobre os serviços de otimização SEO e GEO da WPPoland.
Conclusão
Otimizar para a pesquisa com IA é sobretudo o trabalho que um bom SEO já exigia: páginas que podem ser rastreadas e indexadas, afirmações claras com fontes e algo original para dizer. A parte nova é escolher que crawlers permitir. Ao concentrar-se na clareza das afirmações e no ganho de informação do seu conteúdo WordPress, e ao deixar entrar os crawlers de pesquisa enquanto decide sobre os crawlers de treino, dá aos motores de respostas uma razão para o citar.
O trabalho de citação em LLM dá resultado quando a integração de IA no WordPress expõe as entidades e os factos que esses motores efetivamente citam.