Uma equipa que escreve documentação, README, notas de versão ou o blogue da empresa com Claude Code, Codex ou Cursor acaba por procurar uma skill que limpe os tiques do texto gerado. As três mais citadas são o humanizer, o unslop e, para polaco, o miodkuj. Mantenho sozinho um site em seis línguas escrito com ajuda de IA, e cada texto passa pelo humanizer e depois por verificações determinísticas no repositório. Neste artigo explico o que cada skill faz, o que os testes delas provam e não provam, porque nenhuma lê português, como montar no CI um bloqueio só para achados graves, como confirmar que uma reescrita manteve os factos e como partilhar uma skill entre agentes sem a copiar.
Os números de estrelas, versões e commits foram lidos no GitHub a 6 de novembro de 2026. Não corri código de terceiros para este artigo: o comportamento dos scanners do unslop foi lido no código-fonte, não executado.
Que skills anti-slop existem e o que faz cada uma?
As três skills resolvem problemas diferentes, e só uma delas traz scanners que se podem pôr num pipeline.
| Skill | O que faz | Evidência publicada | Quando usar |
|---|---|---|---|
| humanizer (v3.1.0, MIT, cerca de 65 500 estrelas) | Instruções para o modelo reescrever texto sem 26 padrões de escrita de IA, em seis grupos: encenação, ritmo, inflação, formatação, restos de conversa, leitor errado | Nenhum conjunto de testes no repositório; um teste cego feito por um utilizador (issue #229) | Passagem final de prosa em inglês, por um agente |
| unslop (v2.3.0 no SKILL.md, sem ficheiro LICENSE, cerca de 950 estrelas) | Quatro comandos (teach, cleanup, rewrite, mimic) e quatro scanners em Python que devolvem JSON | Avaliações no repositório; o resultado público mais recente é um no-ship | Deteção em CI de texto inglês e verificação de que uma reescrita manteve os factos |
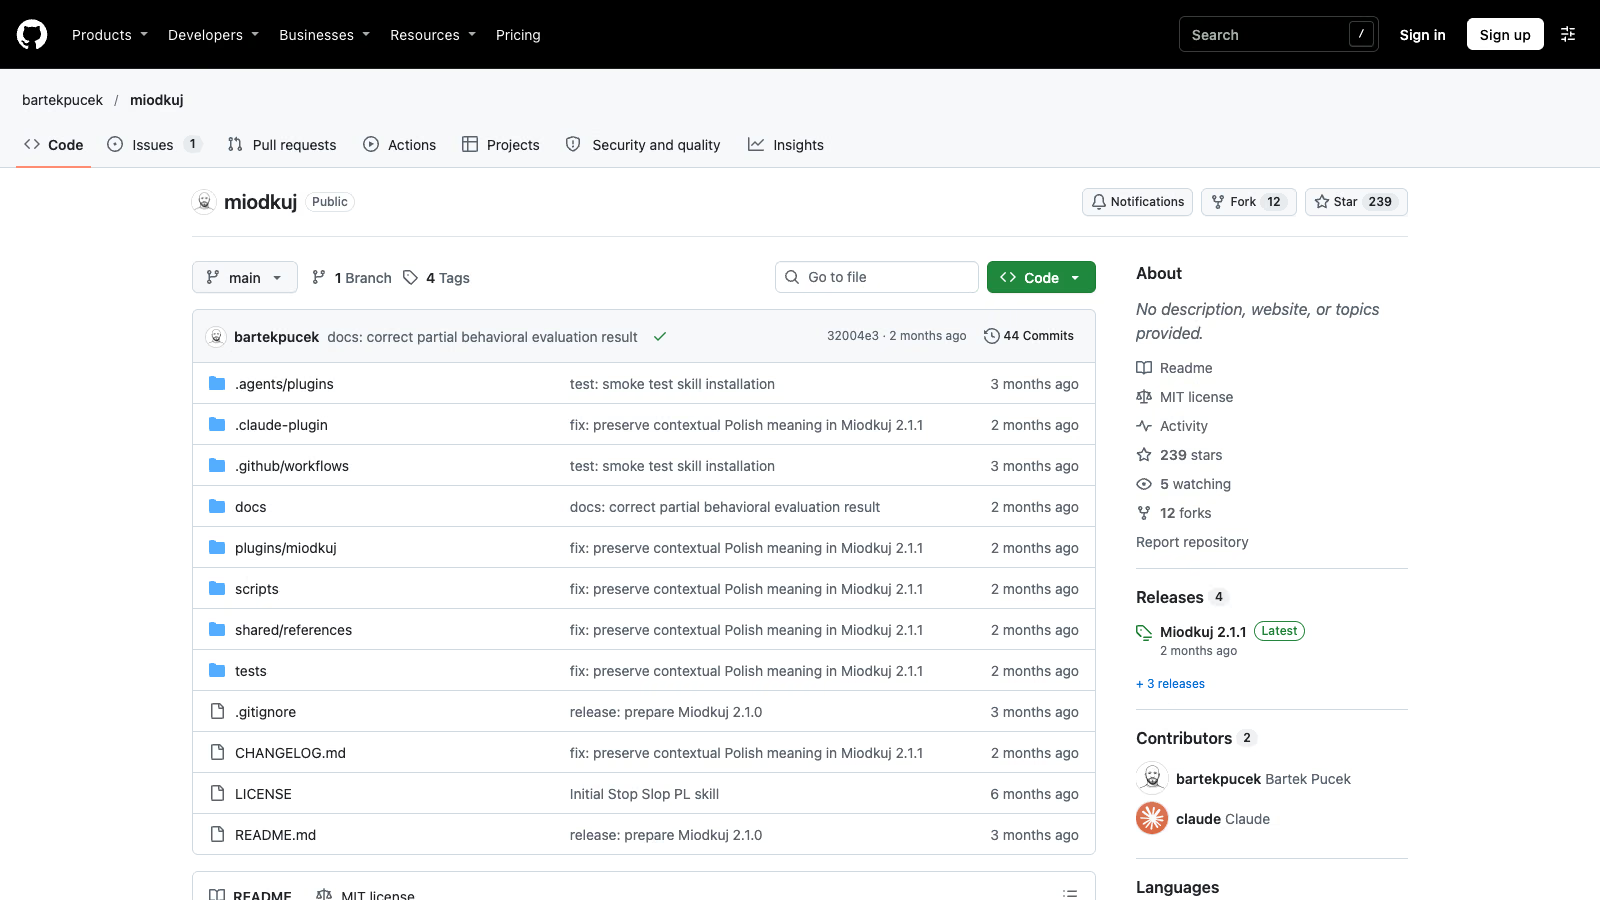
| miodkuj (v2.1.1, MIT, cerca de 240 estrelas) | Edição mínima de texto polaco: linguagem burocrática, cadeias nominais, frases que serviriam a qualquer empresa | Teste comportamental do autor, 12 de 13 casos e 1 parcial | Só texto polaco |
O humanizer é um ficheiro SKILL.md de 31,6 KiB. Não há scanner nem linha de comandos: o script validate-package.py só confirma manifestos, README e CHANGELOG. Toda a deteção é feita pelo modelo que lê as instruções.
O unslop é o único dos três com código executável. O README pede Python 3.8 ou mais recente e só a biblioteca padrão, e o CI do projeto testa as versões 3.8 e 3.11. Os comandos fazem coisas distintas: /unslop cleanup marca tiques de IA como sugestões e não altera nada, /unslop rewrite diagnostica e reconstrói o rascunho (é o comportamento por omissão de /unslop <texto>), /unslop teach cria uma voz a partir de amostras de escrita da equipa e /unslop mimic escreve nessa voz.
O miodkuj está escrito em inglês mas trabalha texto polaco. Também não tem scanner: a pasta scripts/ só contém verificações de empacotamento. Uma regra dele serve para qualquer língua, e uso-a como teste mental em português: se uma frase pudesse passar sem alteração para outra empresa, ministério, produto, projeto ou pessoa, provavelmente é enchimento.
O que provam realmente os testes do unslop, do humanizer e do miodkuj?
Pouco, e os próprios autores dizem-no. Antes de pôr qualquer uma destas skills num processo da equipa, vale a pena ler os resultados.
Unslop: no-ship na última avaliação pública
O README divide os resultados em três quadros e diz que só o quadro principal pode mostrar que a especificação melhora a escrita. A linha seguinte é a mais importante do repositório:
O resultado público independente mais recente é um no-ship. (README do unslop, tradução própria)
O ficheiro CORE-RESULTS.md traz o estado “BETA” e a nota de que a afirmação comparativa ainda não foi revalidada. O teste usou um conjunto público congelado com três documentos com defeitos, um limpo e 31 problemas anotados. Os dois braços correram no mesmo modelo, um com o unslop e outro sem ele, e um juiz cego decidiu:
| Métrica | Com unslop | Sem unslop | Exigido |
|---|---|---|---|
| Precisão de deteção | 81,25% | 83,33% | 90% ou mais |
| Recall de deteção | 83,87% | 32,26% | 90% ou mais |
| Reparação bem-sucedida | 87,10% | 58,06% | 90% ou mais |
| Preservação | 100% | 100% | 100% |
| Taxa de dano | 11,11% | 0% | 0% |
| Documentos com defeitos melhorados em segurança | 0 de 3 | 0 de 3 | 80% ou mais |
O unslop encontra muito mais problemas do que o modelo sozinho, mas estraga texto em 11% dos casos e não melhorou com segurança nenhum dos três documentos. Leio esta tabela como uma razão para usar os scanners como lista de candidatos e manter a reescrita sob revisão humana.
Humanizer: um teste cego com ressalvas
O README do humanizer diz que, num teste cego, os juízes preferiram a reescrita ao texto original 16 vezes em 16, e aponta para a issue #229. A issue foi aberta por um utilizador, não pelo mantenedor, e traz as suas próprias ressalvas: todos os juízes eram modelos de linguagem da mesma família, e o estudo correu 77 dos 144 pares planeados depois de falhas de infraestrutura. Na deteção de IA, a percentagem caiu de 100% para 98,6% e depois para 97,8%. O README é claro sobre isso: passar detetores de IA não é objetivo, e os detetores continuam a marcar a maior parte do resultado.
Miodkuj: 12 de 13, com um erro admitido
O autor testou a versão 2.1.1 contra a 2.1.0, cada uma corrida uma vez por um subagente novo do Codex. A 2.1.1 passou 12 de 13 casos, com um parcial; a 2.1.0 falhou 3 de 12 casos comuns. O parcial foi primeiro registado como aprovado e corrigido no mesmo dia. A secção de limites diz que estes casos não estabelecem uma taxa geral de fiabilidade nem melhoria entre modelos. É o teste mais honesto dos três, e continua a ser um teste pequeno.
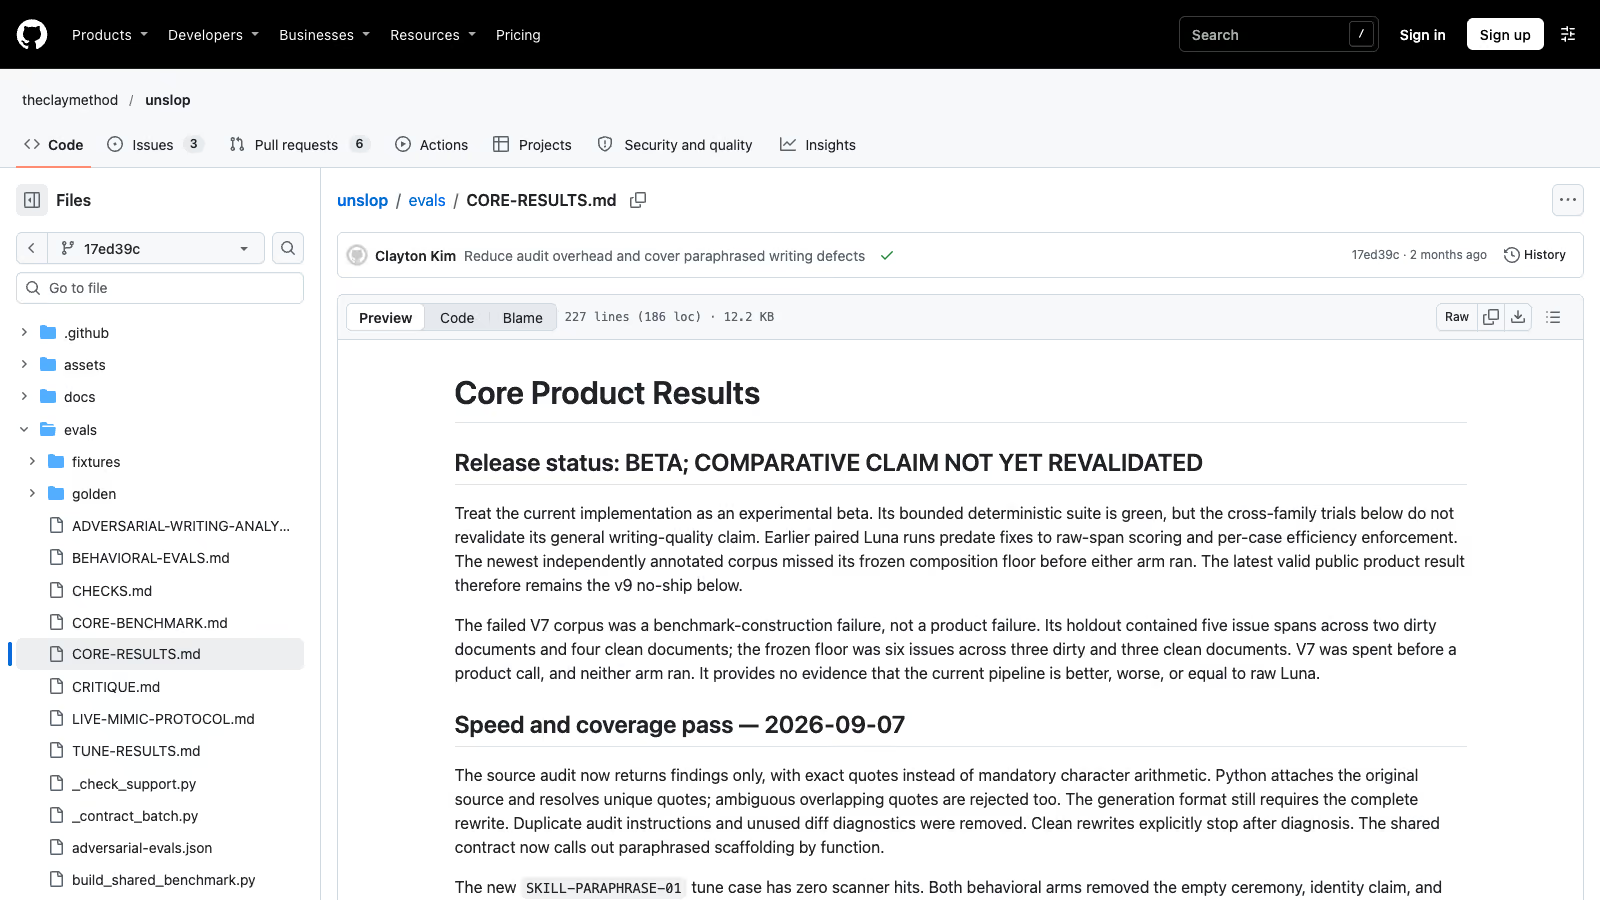 A página de avaliação do unslop no commit 17ed39c: beta, a alegação comparativa ainda não foi revalidada (captura de 6 de novembro de 2026).
Um scanner limpo significa que o texto está bom?
Não. O README do unslop di-lo numa frase:
Os scanners sugerem candidatos; o agente verifica cada ocorrência no contexto. Nem um resultado limpo nem uma expressão conhecida provam quem escreveu o texto, e as verificações não garantem que todos os defeitos desapareceram. (README do unslop, tradução própria)
A página da Wikipedia sobre sinais de escrita com IA (atalho WP:AISIGNS, revisão de 4 de novembro de 2026) vai no mesmo sentido:
Por favor, não trate estes sinais apenas como os problemas a corrigir; isso só tornaria a deteção mais difícil. (Wikipedia, WP:AISIGNS, tradução própria)
E, umas linhas antes, a mesma página diz que os padrões listados são apenas sinais potenciais de um problema, não o problema em si.
Tenho os meus próprios números a confirmar isto. A 6 de novembro, a verificação de retórica deste repositório leu 8681 ficheiros e encontrou 0 ocorrências. A verificação de regras de voz deu 0 violações em três artigos ingleses, um deles de 2019. Isso diz que as listas de padrões estão limpas no corpus. Não diz que a prosa é boa: uma expressão regular vê palavras e formas de frase, e quem julga se um parágrafo diz alguma coisa é a passagem com o humanizer e a leitura humana. Escrevi sobre o lado editorial disto no artigo sobre limpeza de conteúdo AI slop em WordPress.
Estas ferramentas verificam texto em português?
Não, e o unslop devolve verde quando não verifica. Os três scanners do unslop chamam a função is_probably_english(), que exige que pelo menos 10% das palavras sejam palavras funcionais inglesas (textos com menos de 15 palavras contam sempre como inglês). Quando o texto falha esse teste e não houve achados, o scanner imprime {"non_english": true, ...}, escreve um aviso no stderr e sai com código 0. O README diz que só trata inglês (“English only”, tradução própria: “apenas inglês”) e promete uma recusa clara. A recusa existe, mas está no JSON e no stderr: num pipeline que só olha para o código de saída, uma página de documentação em português passa como se tivesse sido verificada.
O humanizer descreve padrões que nasceram em inglês, como o contraste “não é X, é Y” ou os trios forçados. Alguns aparecem em português, mas a skill não foi testada noutra língua e não tem scanner. O miodkuj é para polaco. Não encontrei nenhuma skill anti-slop verificada para português europeu, e prefiro dizê-lo a recomendar uma que não li.
O que corro nas páginas pt-pt deste site
Como não há ferramenta externa, as páginas portuguesas deste site passam por verificações próprias, escritas a partir de defeitos que chegaram à produção:
| Verificação | O que apanha em pt-pt | Regra concreta | Bloqueia? |
|---|---|---|---|
check-reader-address.mjs | Tratamento informal num site que trata o leitor por “o seu” | Conta tu, teu, tua, teus, tuas e contigo fora de código e citações; orçamento pt-pt 0 | Sim, no npm run check |
check-diacritic-wordlist.mjs | Palavras com acentos perdidos numa passagem de tradução | Lista de mais de 150 grafias erradas (configuracao, migracao, revisao, versoes…); auditoria fica de fora porque está certa | Sim, com --check |
check-voice-rules.mjs | Travessões longos, verbos de enchimento, nomes fictícios, chamadas para ação em modelo | 42 regras, duas só para pt-pt (frases de CTA e respostas de FAQ geradas) e uma que impede texto português noutras línguas | Sim, nas variantes ligadas ao check |
check-slop-rhetoric.mjs | Forma de frase: aberturas teatrais, autoridade vaga, contrastes binários | 12 padrões, 11 por omissão; vários incluem frases portuguesas de abertura teatral, de autoridade vaga e de falsa revelação; orçamento 0 | Sim, check:slop-rhetoric:gate |
check-loanword-density.mjs | Jargão de agência em inglês dentro de texto português | Falha a partir de 12 ocorrências e 5 por 1000 palavras nos ficheiros alterados | Sim, no check |
A verificação de acentos tem uma história instrutiva: um commit restaurou cerca de 10 400 palavras sem acento em 367 ficheiros espanhóis e portugueses, e a verificação de densidade de acentos que existia na altura dizia “OK” antes e depois. Uma lista de palavras proibidas só vê as palavras que tem. Por isso escrevo estas verificações para defeitos já vistos e continuo a ler o texto.
Como bloquear slop no CI sem bloquear tudo?
O código de saída do unslop não separa achados graves de achados leves. No código-fonte, o banned_phrase_scan.py sai com 1 em qualquer violação, e a lista dele tem 38 entradas de gravidade hard e 14 de gravidade soft. O structure_scan.py e o silhouette_scan.py marcam todos os achados como soft e também saem com 1. Um passo de CI que falhe com o código de saída bloqueia cada sugestão leve, e a equipa desliga-o ao fim de uma semana.
A solução é ler o JSON. O exemplo abaixo corre num pull request, fixa o unslop num commit, bloqueia só quando by_severity.hard é maior que zero, mostra os achados leves como avisos e marca os ficheiros não verificados:
name: prose-gate
on:
  pull_request:
    paths: ['docs/**/*.md', 'README.md', 'CHANGELOG.md']

jobs:
  unslop:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
        with:
          fetch-depth: 0
      - uses: actions/setup-python@v5
        with:
          python-version: '3.11'
      - name: Fetch unslop at a pinned commit
        run: |
          git clone --quiet https://github.com/theclaymethod/unslop /tmp/unslop
          git -C /tmp/unslop checkout --quiet 17ed39c9d0b522f44190ff0c6233867eadee192a
      - name: Block hard findings only
        run: |
          hard_total=0
          for f in $(git diff --name-only "origin/${{ github.base_ref }}...HEAD" -- '*.md'); do
            [ -f "$f" ] || continue
            out=$(python3 /tmp/unslop/scripts/banned_phrase_scan.py "$f" || true)
            if [ "$(echo "$out" | jq -r '.non_english // false')" = "true" ]; then
              echo "::warning file=$f::not checked, scanner is English-only"
              continue
            fi
            hard=$(echo "$out" | jq '.by_severity.hard | if type == "array" then length else (. // 0) end')
            soft=$(echo "$out" | jq '.by_severity.soft | if type == "array" then length else (. // 0) end')
            [ "$soft" -gt 0 ] && echo "::warning file=$f::$soft soft finding(s), review in context"
            if [ "$hard" -gt 0 ]; then
              echo "::error file=$f::$hard hard finding(s)"
              echo "$out" | jq -c '.violations[] | select(.severity == "hard") | {line_number, phrase, suggestion}'
            fi
            hard_total=$((hard_total + hard))
            python3 /tmp/unslop/scripts/structure_scan.py --genre docs "$f" > /dev/null || \
              echo "::notice file=$f::structure flags (soft), see local run"
          done
          [ "$hard_total" -eq 0 ]
O --genre docs existe no structure_scan.py e no silhouette_scan.py e aceita as listas com rótulos a negrito que a documentação de referência usa; o banned_phrase_scan.py não tem --genre. O aviso non_english serve para que ninguém leia um verde em ficheiros portugueses como aprovação. E o commit fixo protege o pipeline de mudanças nas listas do projeto.
Há ainda a licença. O SKILL.md do unslop diz license: MIT, mas o repositório não tem ficheiro LICENSE e a API do GitHub devolve 404 para a licença. Clonar o código num runner para correr verificações é diferente de copiá-lo para o repositório da empresa. Antes de o copiar, peça ao autor um ficheiro LICENSE; enquanto não existir, eu trato o código como sem licença concedida.
 O repositório blader/humanizer: licença MIT, versão v3.1.0 (captura de 6 de novembro de 2026).
Como confirmar que a reescrita não perdeu factos?
Com o validate_preservation.py do unslop, que compara o original com o texto transformado e, opcionalmente, com um ficheiro de restrições:
python3 /tmp/unslop/scripts/validate_preservation.py --strict original.md rewritten.md constraints.json
echo "exit=$?"
O JSON devolve passed, total_constraints, preserved, missing_count, missing e warnings. Com --strict, os avisos de deriva semântica (negações, âmbito, condicionais) passam a falha. O código lê --strict só quando é o primeiro argumento; noutra posição, é tratado como nome de ficheiro. Sai com 0 quando passa, 1 quando falha e 2 quando não consegue ler um ficheiro.
É a parte do unslop que mais me interessa, porque o risco de uma passagem anti-slop é apagar um facto verdadeiro para soar mais natural. Na tabela de avaliação acima, a preservação deu 100% e o dano 11%: a frase continua lá, mas pior. Não testei este script com texto português e não sei como trata as negações em português, por isso, numa equipa portuguesa, o uso seguro é o comando cleanup com revisão humana e um diff lido linha a linha.
Atualização, . Uma passagem de reescrita compara o texto novo com o rascunho e, por isso, conserva um número errado com a mesma fidelidade que um certo. Se o número veio de um assistente de IA, abra a citação e siga-a até ao estudo que o mediu. A Trakkr, que vende monitorização da visibilidade de marcas na pesquisa com IA, publicou a 28 de outubro de 2026 o estudo Zombie stats. Fez ao ChatGPT, ao Perplexity, ao Gemini, ao Claude e às Google AI Overviews 200 perguntas cuja resposta é um número e seguiu 1285 estatísticas citadas até cinco páginas de profundidade. 40% chegaram a um estudo que diz o mesmo, 8% chegaram ao estudo com o número ou o contexto alterados, 40% pararam numa fonte que não foi possível verificar e 11% não levaram a lado nenhum. A página citada tinha o número em 82% dos casos, mas só 21% das páginas citadas eram a investigação original. Quando o rasto termina numa página sem fonte verificável, retire o número ou indique no texto que não o conseguiu confirmar.
Como partilhar a mesma skill entre Claude Code, Codex e Cursor?
Com uma ligação simbólica relativa, para que a skill exista num só sítio. A documentação do Claude Code define três locais: pessoal (~/.claude/skills/<nome>/SKILL.md, para todos os projetos da máquina, mas não para sessões Cowork ou na nuvem), projeto (.claude/skills/<nome>/SKILL.md, para fazer commit e a equipa receber) e plugin (<plugin>/skills/<nome>/SKILL.md, invocada como /plugin:nome). A mesma página confirma que uma entrada pessoal ou de projeto pode ser uma ligação simbólica para outra pasta, e que o Claude Code carrega a skill uma vez mesmo que vários locais apontem para o mesmo destino.
Neste repositório, a pasta .cursor/skills/ tem seis ligações relativas para ../../.claude/skills/<nome>. Para acrescentar uma:
mkdir -p .cursor/skills
ln -s ../../.claude/skills/humanizer .cursor/skills/humanizer
git add .cursor/skills/humanizer
git ls-files --stage .cursor/skills/humanizer
# 120000 <hash> 0  .cursor/skills/humanizer
O artigo da Xebia de Kris Geusebroek (3 de abril de 2026) descreve o mesmo padrão para plugins: uma pasta skills no topo do projeto, ligações com caminho relativo e o modo 120000 no git ls-files --stage como prova de que o Git guardou uma ligação e não uma cópia. No Windows, criar ligações simbólicas exige o Modo de Programador ou permissões elevadas, e convém escrevê-lo no README.
Os plugins têm regras próprias. Segundo a documentação de marketplaces, uma ligação dentro da pasta do plugin mantém-se relativa, uma ligação para outro ponto do mesmo marketplace é desreferenciada (o conteúdo é copiado para a cache) e uma ligação para fora do marketplace é ignorada por segurança.
A instalação também muda o nome do comando. O humanizer instalado como plugin responde a /humanizer:humanizer e precisa do Claude Code 2.1.142 ou mais recente; para outros agentes, o README indica:
npx skills add blader/humanizer --global --agent codex
npx skills add blader/humanizer --global --agent '*'
O miodkuj como plugin responde a /miodkuj:miodkuj; o nome curto /miodkuj só existe com cópia manual da pasta da skill para ~/.claude/skills/miodkuj. Eu uso a cópia manual para as duas, com o commit fixado num ficheiro ao lado, e partilho-as por ligação.
Que instruções dou ao agente na passagem de reescrita?
Estas são as três que uso, adaptadas a uma equipa que escreve documentação. A primeira faz deteção sem tocar no texto:
Read docs/release-notes.md. List every sentence that could move unchanged to
another product or company, and every claim with no fact, number or source in
this repo. Quote the line, say why, propose a smaller claim. Change nothing.
A segunda faz a reescrita com limites:
Run the humanizer skill on docs/release-notes.md in file mode. Minimum edit.
Keep every version number, flag name, command, link and code block exactly as is.
Do not add examples, numbers or customers that are not already in the file.
Return a diff, not the full file.
A terceira fecha o ciclo:
Compare the original and the rewrite line by line. List every fact, number,
negation or condition that changed or disappeared. If the list is not empty,
restore those lines from the original.
Escrevo as instruções em inglês porque as skills estão em inglês; para documentação portuguesa, acrescento uma linha a dizer que a língua do texto é português europeu e que o tratamento do leitor é “o seu”. O agente aceita a instrução, mas nenhum scanner vai confirmar o resultado, e a leitura final é minha.
Como é o fluxo completo neste site?
Para cada artigo novo, em cada uma das seis línguas: rascunho com o agente a partir de fontes que li, passagem com o humanizer em modo de ficheiro, passagem com o miodkuj nos textos polacos, e depois as verificações do repositório. A regra do projeto diz que nenhum artigo novo ou alargado sai sem as duas passagens de prosa. Quando uma verificação fica vermelha, corrijo o ficheiro inteiro e não só a linha marcada, porque a lista de padrões nomeia uma parte do problema.
Este artigo passou pelo mesmo caminho. As versões das ferramentas que uso estão também no radar tecnológico, que reviso todos os meses.
Por onde começar na sua equipa?
Escolha um tipo de documento, por exemplo as notas de versão, e corra o banned_phrase_scan.py em modo de relatório sobre os últimos dez ficheiros, sem bloquear nada. Conte quantos achados são graves, quantos leves e quantos ficheiros devolvem non_english. Se os graves forem raros e reais, ligue o passo de CI acima; se a maior parte da documentação estiver em português, o unslop não lhe serve como verificação e o caminho é escrever duas ou três regras próprias a partir dos defeitos que a equipa já viu. Se quiser montar isto com Claude Code, Codex ou Cursor no repositório da empresa, descrevo como trabalho na página de implementação de IA.