Introdução
O seu site posiciona-se no Google. Os Core Web Vitals estão a verde. O schema valida. E, mesmo assim, quando alguém pergunta ao ChatGPT, Claude, Perplexity ou Google AI Overviews sobre a sua área, a sua marca nunca aparece. Esse fosso entre o SEO clássico e o que as pesquisas com AI efetivamente citam é o problema que o Generative Engine Optimization existe para resolver.
GEO não substitui SEO. É uma disciplina paralela, focada em como os grandes modelos de linguagem recuperam, interpretam e citam conteúdo, e não em como os crawlers de pesquisa o indexam e ordenam. As técnicas sobrepõem-se em alguns pontos, divergem noutros, e o campo move-se mais depressa do que qualquer norma publicada. Este guia reúne o que realmente funciona, o que é mito e a ordem pela qual uma equipa de engenharia competente deve abordar cada alavanca.
Porque a visibilidade em IA importa em 2026
No primeiro trimestre de 2026, o tráfego mediado por AI representa uma fatia mensurável e crescente dos acessos qualificados na maioria dos sites com forte componente de conteúdo. O ChatGPT Search está embutido na barra de endereço do Safari no iOS para quem tem a app instalada. A Perplexity passou de ferramenta para power users a produto mainstream. O Claude lê a web aberta através da sua ferramenta de pesquisa. O Google AI Overviews aparece numa grande fatia das pesquisas informativas em mercados anglófonos e alarga-se a mais idiomas a cada trimestre.
A consequência económica é simples. Mesmo quando um potencial cliente acaba por comprar, registar-se ou marcar uma consulta através da pesquisa clássica, a sua lista curta foi muitas vezes filtrada por um LLM antes. Se não entra nessa lista, não concorre. O SEO clássico continua a importar, porque alimenta a mesma infraestrutura de crawling usada por muitos sistemas de AI. Mas SEO isolado já não chega.
Diferença entre pesquisa com IA e LLM
Ambos os termos aparecem na prática e a coerência importa mais do que a escolha. “Pesquisa com AI” é o termo mais amplo e voltado para o utilizador. Cobre chatbots, ferramentas de RAG, AI Overviews e sistemas híbridos. “LLM” refere-se concretamente aos modelos de linguagem por trás. Neste guia usamos “AI” para a superfície de descoberta e “LLM” para a tecnologia que a suporta. O objetivo de otimização é o mesmo.
Lista de crawlers de IA e user agents em 2026
Antes de tocar em código, saiba para quem está a otimizar. Em abril de 2026, os principais user agents são:
GPTBot, OpenAI, treino e retrieval offline.OAI-SearchBot, pesquisa ao vivo do ChatGPT.ChatGPT-User, pedidos a pedido disparados por prompts.ClaudeBoteClaude-User, Anthropic.PerplexityBotePerplexity-User, Perplexity AI.Google-Extended, controlo de opt-out do treino do Gemini.CCBot, Common Crawl, alimenta muitos LLMs mais pequenos.Applebot-Extended, opt-out do treino do Apple Intelligence.Bytespider, ByteDance.Meta-ExternalAgent, Meta AI.
Nenhum executa JavaScript. Todos respeitam o robots.txt. A maioria identifica-se com honestidade. Uma parte vai buscar conteúdo no instante em que o utilizador envia o prompt, o que reduz o ciclo de dias para segundos.
Que técnicas GEO não funcionam?
O espaço GEO está cheio de folclore. A maior parte não tem suporte empírico.
Meta tags personalizadas como <meta name="ai-content-url"> ou <meta name="LLMs"> não têm implementação conhecida em qualquer produto LLM em produção. Ficheiros como /.well-known/ai.txt e /ai.txt têm propostas concorrentes e zero adoção. Comentários HTML dirigidos a bots são removidos por todos os crawlers mainstream antes do processamento. Botões de alternância humano-ou-AI exigem clique, e os bots não clicam. O sniffing de user agent para servir conteúdo diferente aos LLMs viola a política de cloaking do Google e pode despoletar ações manuais. Páginas dedicadas a AI não mostram tratamento diferenciado em citações. Puro JSON-LD e Schema.org são lidos pelo Microsoft Copilot via Bing e continuam a influenciar o SEO clássico, mas testes controlados mostram que ChatGPT, Claude e Perplexity ignoram em grande medida dados estruturados na síntese de respostas.
O padrão é sempre o mesmo. Alguém propõe uma especificação, escreve um post, e outros posts citam esse. Antes de adotar uma técnica GEO, pergunte se há prova de consumo real ou apenas prova da existência da proposta.
As listas autopromocionais de os melhores ainda funcionam nos AI Overviews
O artigo “As 10 melhores ferramentas para X”, em que o editor se coloca a si próprio em primeiro lugar, foi a tática GEO mais barata de 2025. Está a perder força. Na atualização de 4 de outubro de 2026, Lily Ray repetiu a sua análise com 100 pesquisas em inglês sobre o melhor software B2B. Em comparação com junho, os AI Overviews da Google citam agora menos 38% de listas autopromocionais de “os melhores” e deixam a marca que as publica fora da recomendação “em 83% dos casos, contra 69% em junho” (Lily Ray, tradução própria).
Ray relata ainda, com base no resumo de John Campbell do Search Central Live em Barcelona, que Gary Illyes afirmou que o conteúdo produzido em escala está a tornar-se um problema maior do que o spam de links. Acrescenta que, num Search Central Live anterior, em maio, Illyes terá comparado a compra de menções à compra de links.
Mesmo assim, formou-se um mercado. Ray refere colocações pagas em listas de terceiros, com preço definido pelo Domain Rating do site e muitas vezes a partir de cerca de 135 a 250 USD cada, e pacotes de “menções de marca em IA”, como 5 menções por 1500 USD. São preços de mercado de terceiros citados no artigo dela, não preços nossos, e não vendemos nem recomendamos estes serviços. Se receber propostas de artigos patrocinados em portais portugueses com DR alto, avalie-as da mesma forma: é o mesmo modelo, só muda o destinatário. Se a comparação de Illyes se confirmar, uma menção comprada traz o mesmo risco que um link comprado.
Porque é que estatísticas inventadas são citadas pela IA e por outros sites
Metehan Yesilyurt, da Peec AI, levou ao absurdo a ideia de publicar estatísticas para ser citado (7 de outubro de 2026). Comprou um domínio novo e gerou num único dia, com o GPT-4.1, 50 000 páginas de estatísticas, por cerca de 30 USD; com 15 000 listicles acrescentados depois, a experiência custou cerca de 50 USD no total. Escreve ele: “Todas elas eram falsas” (Peec AI, tradução própria). O site obteve mais de 330 domínios de referência, entre eles Shopify, Bluehost e DHL. Nos últimos 30 dias recebeu mais de 600 000 pedidos de bots, cerca de 72 000 dos quais do ChatGPT-User. Duas atualizações da Google logo após o lançamento fizeram ruir a visibilidade no Google, mas a 7 de outubro o site ainda estava em segundo lugar em visibilidade nos prompts que acompanhava, atrás apenas da Statista.
Há duas consequências. Um número repetido pelo ChatGPT e por uma marca conhecida não foi verificado por nenhum dos dois. Antes de citar uma estatística, siga-a até ao estudo original, ao método e à amostra, e descarte-a se o rasto terminar num site sem metodologia. E não copie a tática: a visibilidade no Google não sobreviveu a duas atualizações, e quem repete um número inventado espalha-o ainda mais. A alavanca das “estatísticas verificáveis”, mais abaixo neste guia, só funciona quando as estatísticas são reais.
Como tornar o site visível para a IA
Ordenadas por impacto para um site típico de conteúdo.
1. Comece pela auditoria ao robots.txt
Nada mais funciona se estiver a bloquear os crawlers por engano. Muitos sites herdaram regras agressivas de disallow do pânico de 2023 sobre treino de AI. Quem deixa passar e quem bloqueia é decisão sua, mas tem de ser explícita. Um padrão razoável para um negócio que quer visibilidade em AI:
User-agent: GPTBot
Allow: /

User-agent: OAI-SearchBot
Allow: /

User-agent: ChatGPT-User
Allow: /

User-agent: ClaudeBot
Allow: /

User-agent: PerplexityBot
Allow: /

User-agent: Google-Extended
Allow: /

User-agent: CCBot
Allow: /
Se quer visibilidade no ChatGPT sem que o conteúdo seja usado para treino, permita OAI-SearchBot e ChatGPT-User e bloqueie GPTBot. A OpenAI documenta esta separação. A Apple, a Google e a Anthropic oferecem controlos equivalentes.
2. Sirva irmãos Markdown para cada página
A mudança técnica de maior alavanca na lista. Exponha uma versão Markdown limpa de cada página no mesmo URL com .md no fim, por exemplo /blog/post e /blog/post.md. A versão Markdown corta navegação, rodapés, snippets de analítica, banners de cookies e tudo o resto que inflaciona tokens sem acrescentar informação.
Medições independentes em vários sites de conteúdo mostram de forma consistente reduções de tokens na casa dos 70 a 85 por cento quando o Markdown substitui o HTML renderizado. Um post de 15.000 tokens passa tipicamente a 3.000. Isso importa porque, quando um LLM puxa sua página para responder a um prompt, tem um orçamento de contexto finito. Conteúdo mais pequeno e mais limpo cabe mais inteiro e é citado com mais fidelidade.
Em Astro, Next.js ou qualquer framework static-first, gerar endpoints .md a partir da mesma content collection que alimenta a vista HTML é uma manhã de trabalho. O Markdown deve incluir o título, a data de publicação, o autor, um resumo curto, o corpo e as fontes claramente assinaladas.
3. Anuncie a versão Markdown
Um crawler de LLM que aterra na sua página HTML precisa de descobrir que existe um irmão Markdown. Dois mecanismos complementares cobrem as duas classes de clientes.
Na head do HTML:
<link rel="alternate" type="text/markdown" href="/blog/post.md" />Num cabeçalho de resposta HTTP:
Link: </blog/post.md>; rel="alternate"; type="text/markdown"A tag HTML chega a parsers que leem o DOM. O cabeçalho HTTP chega a agentes headless que fazem HEAD ou GET e não analisam markup. Custo: uma linha no layout e uma entrada na configuração de cabeçalhos do CDN. Ganho: os crawlers deixam de adivinhar o padrão de URL.
4. Negociação de conteúdo em Accept: text/markdown
A negociação de conteúdo HTTP está no standard desde 1997. Quando um cliente envia Accept: text/markdown, devolvá a representação Markdown a partir do mesmo URL. Combine com Vary: Accept para que os CDNs façam cache de cada representação corretamente. Claude Code, Cursor e vários agentes de investigação já enviam este cabeçalho por defeito. A negociação de conteúdo é o padrão de longo prazo mais provável porque não exige novas especificações e reaproveita a stack HTTP existente. Em Cloudflare Workers, a implementação cabe em menos de vinte linhas.
5. Publique llms.txt e llms-full.txt
Dois ficheiros na raiz do site fazem o trabalho.
/LLMs.txt é um índice Markdown curado. Lista as páginas mais importantes agrupadas por tema, com descrições de uma linha. Pense nele como um README para um LLM a quem perguntaram sobre o seu site.
/LLMs-full.txt junta o conteúdo Markdown completo das páginas centrais num único ficheiro. Analítica em vários editores mostra que recebe bastante mais tráfego de LLM do que o índice curto. Gere os dois em tempo de build a partir da mesma content collection que já mantém, e regenere a cada deploy. Nenhum grande fornecedor de LLM se comprometeu formalmente a ler estes ficheiros, mas aparecem nos logs com frequência suficiente para justificar o tempo.
6. Invista na qualidade do conteúdo visível
A maior alavanca e a mais ignorada. Os LLMs sintetizam respostas ponderando frases candidatas das páginas que vão buscar. Frases com informação concreta e atribuível ganham peso superior a afirmações vagas. “Estudos mostram que a visibilidade em AI importa” é quase inútil. “Testes independentes em 2026 concluíram que citações diretas de peritos nomeados elevam a taxa de citação em cerca de 43 por cento” é o que é citado.
Três movimentos aumentam de forma consistente a taxa de citação em conteúdo antes pouco citado:
- Citações diretas de peritos nomeados.
- Estatísticas verificáveis com fonte claramente atribuída.
- Ligações autoritativas para fontes primárias.
Todos são sinais de conteúdo visíveis. Nenhum está escondido. Para uma agência WordPress, uma empresa SaaS ou qualquer negócio com especialização setorial, a tradução prática é: deixe de escrever listas genéricas e passe a escrever artigos que nomeiam versões, datas, pessoas e números concretos. Cite fontes inline. Cite a sua equipa pelo nome. Inclua o ano e a versão de cada ferramenta que menciona. É bom jornalismo e é GEO.
Checklist de SEO e GEO para 2026
Crawlabilidade e indexação:
- O robots.txt permite crawlers clássicos de pesquisa e os user agents de AI onde quer estar visível.
- O sitemap XML está atualizado e submetido ao Google Search Console e ao Bing Webmaster Tools.
- A ligação interna segue uma estrutura temática clara. Hub e spoke ou mapas temáticos.
- Tags canonical corretas em URLs duplicados ou parametrizados.
On-page, continua a valer para humanos e para o retrieval de LLM:
- Títulos e H1 descritivos e alinhados com a intenção de pesquisa, em sentence case.
- Um H1 por página, hierarquia lógica de H2 e H3.
- Meta descrições escritas para humanos, sem stuffing.
- Tipos Schema.org que correspondem ao conteúdo, como Article, FAQPage, Product, Organization, Person e HowTo.
- Alt de imagem a descrever a imagem, não a keyword.
Core Web Vitals. Os crawlers de AI não correm JavaScript, mas a pesquisa clássica corre:
- LCP abaixo de 2,5 segundos em mobile.
- CLS abaixo de 0,1.
- INP abaixo de 200 milissegundos.
Específico de GEO:
- Endpoints Markdown para cada página de conteúdo.
<link rel="alternate" type="text/markdown">em cada layout.- Cabeçalho HTTP
Link:ao nível do CDN. - Negociação de conteúdo em
Accept: text/markdown. /LLMs.txte/LLMs-full.txtna raiz, regenerados a cada deploy.- Citações, aspas e estatísticas visíveis no próprio conteúdo.
- Entidades nomeadas, incluindo pessoas, produtos, empresas, versões e datas, usadas de forma consistente.
Medição:
- Registo server-side de User-Agent e Referer no edge.
- Um dashboard que separa o tráfego de crawlers de AI do tráfego humano e da pesquisa clássica.
- Prompts de teste mensais em ChatGPT, Claude, Perplexity e Gemini para seguir menções da marca.
Em que ordem implementar GEO?
Para um site que ainda não tem nada disto, trabalhe por esta ordem. Cada passo tem valor por si.
- Auditar e corrigir o robots.txt. Sem isto, nada mais funciona.
- Adicionar
<link rel="alternate" type="text/markdown">a apontar para um futuro endpoint Markdown. Pode ser entregue antes do endpoint existir. - Construir a pipeline de rendering Markdown. Comece pelo tipo de conteúdo com mais tráfego e expanda.
- Adicionar o cabeçalho
Link:e negociação de conteúdo emAccept: text/markdownao CDN. - Gerar
/LLMs.txte/LLMs-full.txta partir da content collection em tempo de build. - Refazer os artigos de referência com entidades nomeadas, citações diretas e estatísticas com fonte. Trabalho editorial contínuo e de maior impacto a longo prazo.
- Instrumentar analítica server-side para tráfego de crawlers de AI.
Os passos um a cinco são engenharia pura e cabem num sprint. O passo seis é editorial e compõe-se ao longo de trimestres. O passo sete diz-lhe se algo disto resultou.
Como medir a visibilidade em AI
A analítica tradicional não vê a maior parte do tráfego de crawlers de AI. Como não executam JavaScript, o GA4 e o Plausible não os registam. É preciso logging server-side.
Capture no edge: User-Agent completo, cabeçalho Referer, caminho pedido, status HTTP devolvido e tamanho da resposta. Segmente por padrões de user agent como GPTBot, ClaudeBot, PerplexityBot, OAI-SearchBot, Bytespider, CCBot, Applebot-Extended e Google-Extended para construir um dashboard semanal.
Complemente com tracking de menções de marca. Uma vez por semana, corra um conjunto fixo de prompts no ChatGPT, Claude, Perplexity e Gemini e registe se a marca foi citada, em que posição e com que excerto. Ferramentas como Profound, Peec AI e Otterly automatizam este trabalho. Uma folha de cálculo disciplinada cumpre o mesmo papel.
Se um crawler vai buscar o endpoint Markdown mas a marca nunca surge no conjunto de citações, o conteúdo é alcançável mas não é competitivo. Regresse à alavanca editorial.
Como distinguir uma menção da marca de uma recomendação em IA
Uma contagem de menções só responde se a marca apareceu. Não diz se a resposta mandou o leitor até si. O texto da Seer sobre KPI de visibilidade em AI descreve o pior caso:
“Na pesquisa com IA é perfeitamente possível aparecer e ser ANTI-recomendado.”
Seer Interactive, AI visibility KPIs, tradução própria
Em português: pode aparecer e ser expressamente desaconselhado. O exemplo é uma resposta do ChatGPT a dizer para olhar além de duas marcas conhecidas de alojamento. Ambas eram visíveis, nenhuma foi recomendada. A base são anedotas, não um conjunto de dados, por isso é um aviso sobre a métrica e não uma taxa medida.
Registe por isso duas colunas por prompt: citada e recomendada, com uma nota quando a resposta desvia o leitor.
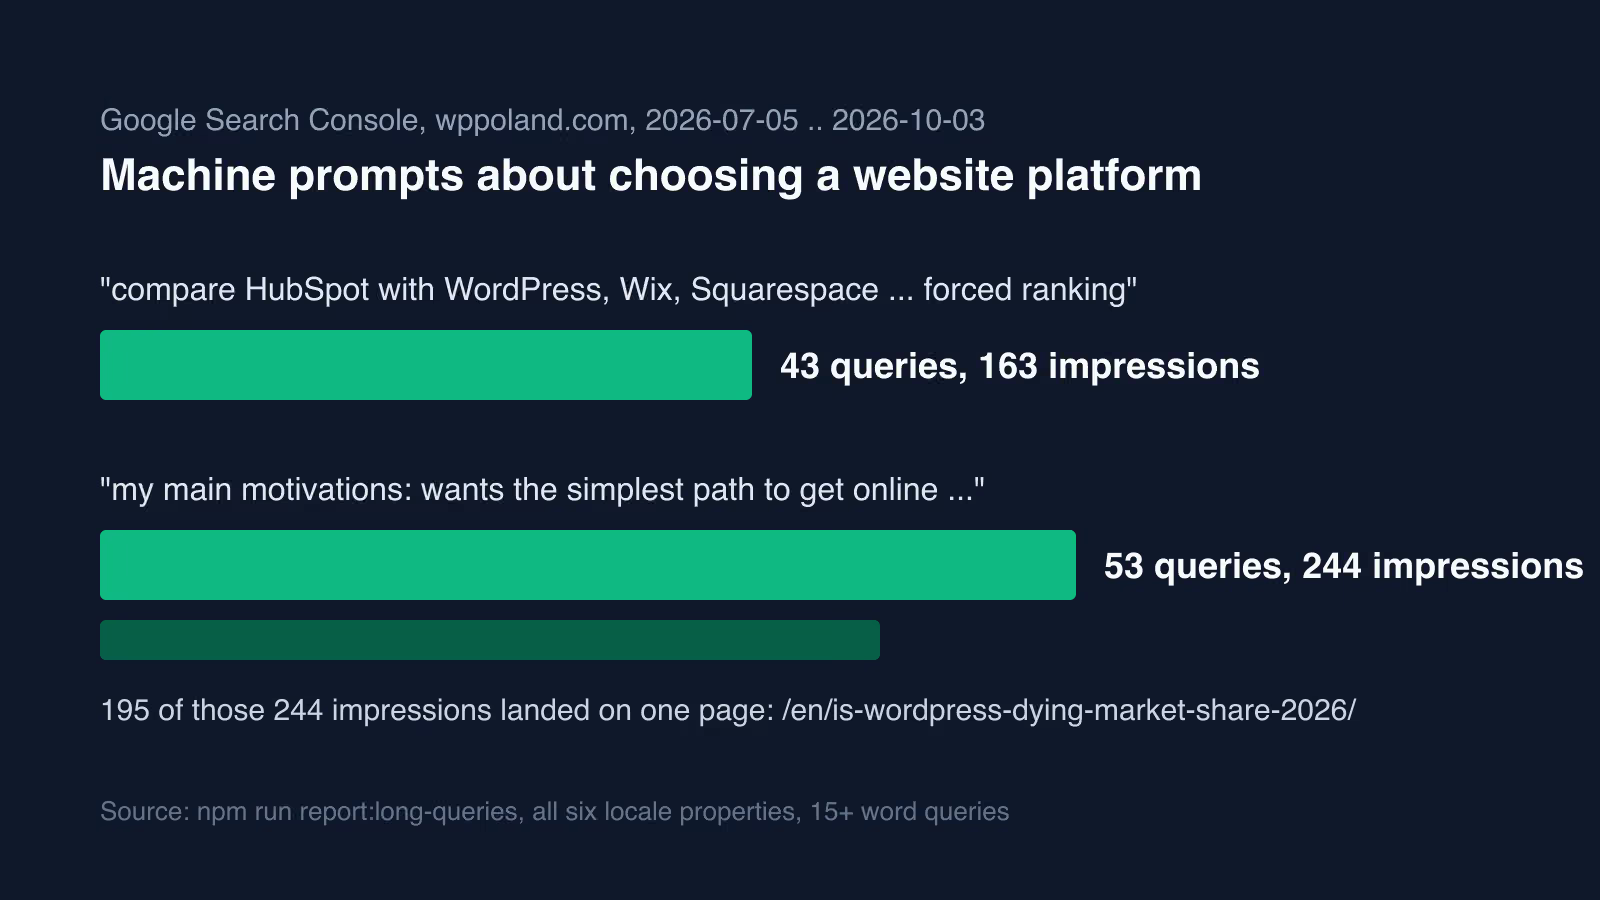
Os nossos números mostram porque uma coluna engana. No teste da Geoboard com prompts polacos de intenção de compra, o wppoland.com teve 47 % de menções e 0 % de autoridade: presente, nunca em primeiro. A 5 de outubro de 2026 corremos 24 prompts de dor, 60 execuções por modelo, 2878 respostas de gpt-4o-mini e gemini-2.5-flash-lite. Nenhuma mencionou o wppoland. Perante “quem contratar”, os modelos apontaram Clutch e Codeable, plataformas, e não empresas. Os dois testes consultam os modelos sem pesquisa em direto, por isso medem a memória do modelo e não o que o ChatGPT encontra com navegação.
O que são consultas fan-out e de grounding?
O resumo da SearchPilot, assistido por AI, de um webinar com Cyrus Shepard não é uma transcrição. Assenta na revisão que ele fez de 54 estudos sobre citações em AI e separa dois tipos de pesquisa. As consultas fan-out investigam o pedido: um prompt pode desencadear muitas pesquisas em segundo plano. As de grounding validam uma afirmação que o sistema já quer fazer. Segundo o resumo, muitas citações visíveis vêm da fase de grounding. Um site pode moldar a investigação sem ser citado, ou ser citado por validar um facto sem influenciar a recomendação.
Também não as verá nos seus relatórios. A crónica da ROAST sobre o Google Search Central Live em Barcelona di-lo sem rodeios:
“As consultas fan-out do Google não aparecem na Search Console, uma vez que não vêm de utilizadores.”
ROAST, Google Search Central Live Deep Dive Barcelona, day 3 recap, tradução própria
Que métricas de visibilidade em IA medir
- Repita cada prompt. A Seer propõe correr os dez prompts principais 10, 20 ou 30 vezes por mês e chama ao resultado métrica de momentum, “não um KPI final para pôr no painel da direção” (Seer Interactive, tradução própria).
- Veja o tráfego do Google ao lado do tráfego de LLM. O resumo da SearchPilot descreve um teste da Omio em que um resumo estruturado no topo da página fez subir o tráfego de LLM enquanto o Google orgânico seguia no sentido errado.
Perguntas sobre Markdown, bloqueio de crawlers e resultados
Servir Markdown vai canibalizar o meu tráfego de SEO? Não. O Google indexa o HTML canónico. O irmão Markdown é anunciado como representação rel="alternate", o que indica ao Google que não deve ser tratado como duplicado.
Isto vai ser abusado? Os LLMs avaliam candidatos a fonte por sinais de confiança percebida, não pelo formato de ficheiro. Publicar Markdown não torna conteúdo fraco em citável. O investimento protege contra o risco de ser ilegível, sem garantir o retorno de ser citado.
Devo bloquear os crawlers de AI? Decisão de negócio. Se vive de tráfego direto, bloquear treino e permitir retrieval é um meio-termo razoável. Se vive de descoberta, não bloqueie nada.
Quanto tempo até ver resultados? A camada de engenharia atua em dias, assim que os crawlers voltam a buscar. A camada editorial compõe-se ao longo de trimestres. Espere mudanças mensuráveis nas citações de AI entre quatro e oito semanas após o lançamento conjunto das duas camadas.
Como acompanhar as citações de IA do seu site
Tudo o que foi dito acima assume que tem de adivinhar se toda esta instalação funciona de facto. Não tem. Corremos o wppoland.com como sujeito de teste durante um trimestre completo e publicámos o método em bruto, não apenas a conclusão.
Como seguimos as citações de IA do wppoland.com durante 90 dias é o registo desse experimento: captura de User-Agent no edge, um conjunto fixo de prompts semanais em quatro assistentes, e a curva de citações semana a semana. É a implementação de referência do passo sete da ordem pragmática acima, feita na nossa própria infraestrutura em vez de descrita em abstrato.
Monitorização de citações de IA: o que seguir e com que frequência transforma esse experimento único numa cadência repetível. Define que campos registar no edge, com que frequência relançar o conjunto de prompts sem gastar o orçamento de um trimestre em ruído, e a partir de que limiar uma queda nas citações é sinal e não variância normal semana a semana.
Porque é que o Perplexity cita a sua marca e o ChatGPT não explica a divisão que aparece primeiro assim que começa a medir: a mesma página é citada com fiabilidade por um assistente e nunca por outro, por razões estruturais que nada têm a ver com a qualidade do conteúdo. É comum que os assistentes de AI privilegiem fontes em português do Brasil por terem mais volume de treino, pelo que o conjunto de prompts deve testar explicitamente variantes europeias para não mascarar o resultado real do mercado português. Saber que assistente premeia que sinal muda onde investe a hora editorial do passo seis.
Leia estes três textos juntos antes de construir um dashboard do zero. O padrão de engenharia já está feito. A questão em aberto é o que os seus próprios registos dizem sobre o seu próprio domínio.
Estratégia GEO a longo prazo para pesquisa com IA
O campo GEO é instável. Todos os meses surge uma nova norma proposta, um novo crawler ou uma mudança na forma como um dos grandes LLMs pondera citações. A estratégia duradoura não é correr atrás de cada tendência, mas investir na camada de que qualquer sistema de retrieval precisa: conteúdo limpo, bem estruturado e rico em citações, entregue num formato barato de processar.
A parte técnica, ou seja, irmãos Markdown, negociação de conteúdo e LLMs.txt, é entrada. O trabalho editorial, ou seja, entidades nomeadas, citações diretas, estatísticas verificáveis e fontes autoritativas, é o fosso. A concorrência cópia a infraestrutura numa semana. Cinco anos de escrita substancial por peritos nomeados na sua empresa não se copiam.
Construa a parte técnica uma vez. Passe o resto do tempo a escrever coisas dignas de serem citadas.
A mesma checklist é a que usamos ao integrar IA no WordPress para editores que precisam de citações, não de mais um plugin de chatbot.