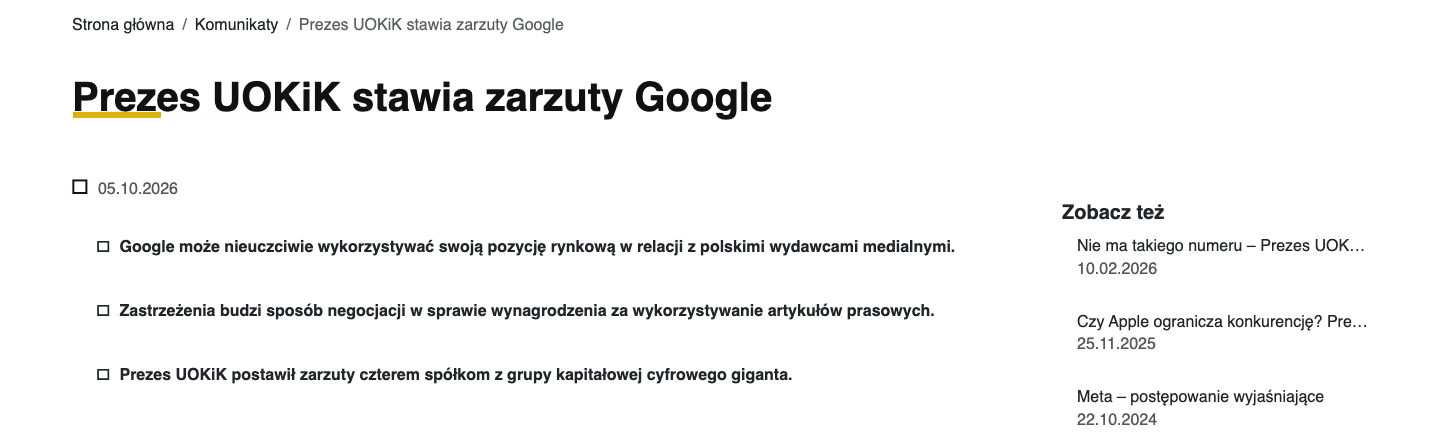
A 5 de outubro de 2026, o Presidente da UOKiK apresentou acusações contra quatro empresas do grupo Google sobre a forma como o grupo negociou compensação com editores de imprensa pelo uso dos seus artigos. O processo abrange o motor de busca Google, Google News e Google Discover. O caso diz respeito ao mercado polaco e aos editores de imprensa polacos, mas os mecanismos de controlo descritos abaixo funcionam da mesma forma para qualquer site. Para um editor que publica um site no WordPress hoje, nada muda tecnicamente no tráfego ou na indexação. O que muda é o contexto das negociações sobre compensação, e há várias configurações que o editor controla e que vale a pena rever neste momento, antes que alguém comece a alterá-las sob a pressão de manchetes alarmistas.
Porque é que a UOKiK acusou a Google
A acusação diz respeito aos dados que os editores não receberam. O comunicado do órgão descreve-o assim:
“Com base nas informações de que o Gabinete dispõe, a Google, ao propor compensação aos editores, não apresentou os dados exigidos por lei que lhes permitisse avaliar as tarifas oferecidas.”
UOKiK, Prezes UOKiK stawia zarzuty Google, 5 de outubro de 2026, tradução própria
O órgão especifica exatamente o que faltava: informações sobre a forma como a Google usa as publicações jornalísticas e que receitas obtém, explicação dos parâmetros utilizados no cálculo e documentos que permitissem verificar os seus pressupostos. A consequência que a UOKiK identifica é uma assimetria de informação: o editor não é capaz de avaliar se a oferta é lucrativa, nem de apresentar a sua própria proposta com base em dados.
A acusação legal é a suspeita de abuso de posição dominante. Ter tal posição não é em si mesmo ilegal. O que é ilegal é usar essa posição para impor condições a contrapartes que dependem da plataforma. O comunicado sublinha que os editores dependem da Google como canal para chegar aos leitores e não têm conhecimento completo do valor do conteúdo que está a ser utilizado.
As acusações dizem respeito a quatro empresas:
| Empresa | Função de acordo com o comunicado da UOKiK |
|---|---|
| Alphabet Inc | empresa-mãe do grupo Google |
| Google LLC | serviços de publicidade, anteriormente operava o motor de busca Google no EEE |
| Google Ireland Limited | atualmente opera e gere o motor de busca Google no território do EEE |
| Google Poland | venda de espaço publicitário na internet |
O Presidente da UOKiK Tomasz Chróstny, numa declaração anexada ao comunicado, avalia o efeito da falta de dados da seguinte forma:
“A falta destes dados levou a uma situação em que as negociações se tornavam fictícias e tendiam à imposição de condições pelo operador dominante do mercado.”
Tomasz Chróstny, Presidente da UOKiK, comunicado da UOKiK, 5 de outubro de 2026, tradução própria
Com que base podem os editores exigir compensação à Google
A base é a reforma do direito de autor de 2024, que transpôs a diretiva (UE) 2019/790, conhecida como diretiva DSM. O direito dos editores de imprensa decorre do seu artigo 15. De acordo com o comunicado da UOKiK, as disposições permitem que os serviços online utilizem publicações jornalísticas em troca de compensação, e a plataforma tem a obrigação de fornecer ao editor as informações necessárias para determinar o seu montante. Esta obrigação de informação é exatamente o que, segundo o órgão, não foi cumprida.
O artigo 15 da diretiva tem vários limites que um editor com um site no WordPress deve conhecer, porque determinam se é sequer uma parte nestas negociações:
- o direito não abrange hiperligações ou o uso de palavras individuais ou fragmentos muito breves de uma publicação,
- não abrange o uso privado ou não comercial por utilizadores individuais,
- expira dois anos após a publicação, contados a partir de 1 de janeiro do ano seguinte ao da publicação,
- os autores dos textos devem receber uma parte adequada das receitas que o editor obtenha a partir disto.
Uma questão separada é a definição. O artigo 2, ponto 4 da diretiva considera como publicação jornalística um conjunto composto principalmente por obras literárias de natureza jornalística, publicadas como parte de um periódico ou de uma publicação atualizada regularmente sob um único título, com o objetivo de informar o público em geral, por iniciativa e sob responsabilidade editorial de um prestador de serviços. As revistas científicas são expressamente excluídas. Na prática, um site de notícias locais operado regularmente enquadra-se mais facilmente nesta definição do que um blogue corporativo que publica artigos de vendas. Os limites de um caso concreto são avaliados por um jurista, não por uma pessoa a configurar o WordPress.
Se as negociações com a plataforma não chegarem a um acordo, os regulamentos preveem um árbitro. A UOKiK salienta que não é ela mesma:
“Importa notar que o Presidente da UOKiK não é parte nas negociações, ou em qualquer disputa entre a Google e os editores de imprensa.”
UOKiK, Prezes UOKiK stawia zarzuty Google, 5 de outubro de 2026, tradução própria
De acordo com o mesmo comunicado, o órgão não avalia se a tarifa proposta é apropriada. Quando as partes não chegam a acordo, o Presidente da Autoridade de Comunicações Eletrónicas pode determinar o montante da compensação. O processo da UOKiK diz respeito, portanto, à forma como são conduzidas as negociações, não ao valor.
As acusações da UOKiK dizem respeito a AI Overviews
Não dizem, e o próprio comunicado o esclarece. A introdução descreve o fenómeno de forma mais ampla: os leitores param nos fragmentos nos resultados de pesquisa ou na síntese de artigos preparada por inteligência artificial e não clicam na ligação. Mas o órgão define o âmbito do processo de forma estreita. A Comissão Europeia está a investigar os serviços da Google baseados em inteligência artificial, tendo iniciado um procedimento formal em dezembro de 2025 sobre se a Google usa conteúdo de editores nestes serviços sem compensação adequada e sem possibilidade de objeção. A UOKiK escreve:
“O âmbito do processo da CE é, portanto, diferente do processo concorrencial iniciado pelo Presidente da UOKiK.”
UOKiK, Prezes UOKiK stawia zarzuty Google, 5 de outubro de 2026, tradução própria
O processo da autoridade polaca abrange o uso de conteúdo de editores nos resultados de pesquisa do Google e nos serviços Google News e Discover. Ambos os processos são independentes, o que, de acordo com o comunicado, foi acordado com a Comissão antes do início do processo formal.
O que as acusações mudam para um editor no WordPress hoje
A nível técnico, nada. As acusações são um fase de um processo de concorrência, não uma decisão. Uma multa até 10% do volume de negócios é o limite máximo previsto na lei, e o comunicado salienta que a responsabilidade de cada empresa será analisada durante o processo. A classificação, indexação, Discover e o tráfego do motor de busca funcionam amanhã exatamente como funcionavam ontem.
O que muda é o contexto das negociações sobre dinheiro. O comunicado diz que a Google não assinou contratos com a maioria dos editores de imprensa polacos e que há preocupações com a forma como conduziu negociações com organizações que representam editores. Um editor que pertence a tal organização tem, a partir de agora, a posição pública do órgão de que exigir dados sobre o uso da publicação e receitas é uma exigência decorrente da lei. Um editor que não pertence a qualquer organização deve pelo menos saber quem está a negociar em seu nome ou se é que alguém o está a fazer.
A segunda mudança é o risco de decisões precipitadas. Após um caso notório envolvendo a Google é fácil ter a ideia de “cortar a Google” no robots.txt ou adicionar noindex em massa. O editor perde então tráfego e não ganha qualquer argumento nas negociações. A compensação do artigo 15 é devida pelo uso de publicações no motor de busca, News e Discover. Uma página removida do motor de busca deixa de ser objeto desta conversa.
O que o editor controla: Content-Signal, Google-Extended e Search Console
O editor tem hoje três mecanismos separados para influenciar o que a Google faz com o seu conteúdo, e um quarto que funciona como um interruptor geral.
| Mecanismo | Onde é configurado | O que afeta | O que não afeta |
|---|---|---|---|
| Controlo de IA generativa | Search Console, Definições | AI Overviews, AI Mode, funções generativas no Discover | classificação, treino de IA |
| Google-Extended | robots.txt | treino e fundamentação (grounding) de modelos Gemini fora do motor de busca | presença no Google Search, classificação |
| Content-Signal | robots.txt | declaração de consentimento para search, ai-input, ai-train | não bloqueia nada tecnicamente |
| noindex | meta robots ou cabeçalho HTTP | remove o endereço do Google Search por completo | nada fica no motor de busca |
Controlo de IA generativa no Search Console
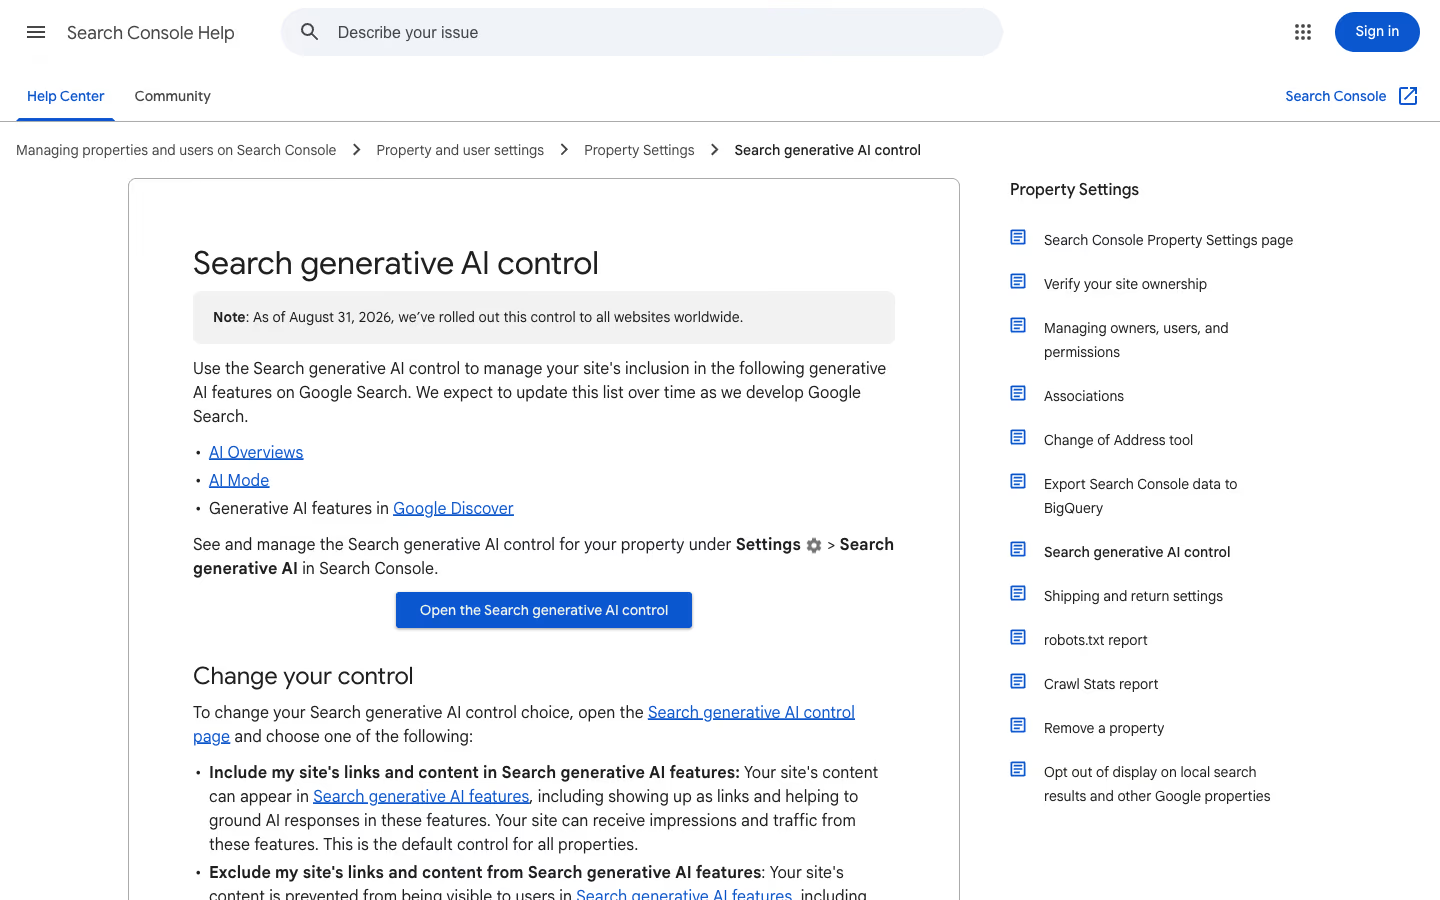
Esta é a mais recente destas configurações. A Google descreve-a na ajuda do Search Console e fornece a data de disponibilidade:
“As of August 31, 2026, we’ve rolled out this control to all websites worldwide.”
Google, Search generative AI control, ajuda do Search Console
Isto significa que a partir de 31 de agosto de 2026 o controlo está disponível para todos os sites em todo o mundo. Abrange AI Overviews, AI Mode e funções generativas no Google Discover. Por predefinição, o site está incluído. Depois de o excluir, o conteúdo não aparece nestas funções, nem como ligação nem como fonte de fundamentação de respostas, e a Google adverte que a mudança geralmente funciona após alguns dias, em alguns casos mais tempo devido ao cache. A configuração é herdada: uma propriedade com prefixo de URL, por exemplo uma secção separada do site, herda-a da propriedade principal, a menos que o proprietário a configure separadamente para essa propriedade.
A limitação mais importante está na mesma documentação:
“This control doesn’t affect AI training; to limit training of the models used to generate responses in Search generative AI features, use Google-Extended.”
Google, Search generative AI control, ajuda do Search Console
Isto significa que este controlo não afeta o treino de IA, e a Google refere para Google-Extended para limitar o treino dos modelos utilizados nestas funções. Antes de alterar a configuração, verifique o relatório de desempenho da função de IA generativa no Search Console. Sem números anteriores à mudança, não será capaz de avaliar quanto tráfego a decisão custou.
Google-Extended no robots.txt
Google-Extended é um token no robots.txt, não um robot separado. De acordo com a documentação dos crawlers da Google não tem a sua própria string User-Agent nos pedidos HTTP, por isso não a verá nos registos do servidor. A indexação é efetuada pelos robots normais da Google e o token funciona como uma configuração. Diz respeito ao treino de futuros modelos Gemini e à fundamentação de respostas em Gemini Apps e em Vertex AI. A Google garante que não afeta a presença do site no Google Search e não é um sinal de classificação.
No WordPress, robots.txt pode ser um ficheiro físico no diretório raiz ou um ficheiro gerado por WordPress através da função do_robots(). O ficheiro físico tem precedência, por isso antes de adicionar qualquer coisa no painel do plugin SEO, verifique qual dos dois o servidor está realmente a devolver. Para o ficheiro gerado, é suficiente um filtro:
add_filter( 'robots_txt', function ( $output, $public ) {
    if ( $public ) {
        $output .= "\nUser-agent: Google-Extended\nDisallow: /\n";
    }
    return $output;
}, 10, 2 );Content-Signal e artigo 4 da diretiva
O nosso próprio robots.txt usa a linha Content-Signal: search=yes, ai-input=yes, ai-train=no, e um comentário acima dela indica que as restrições expressas por estes sinais são uma reserva expressa de direitos no sentido do artigo 4 da diretiva 2019/790. O artigo 4 é a exceção de prospeção de textos e dados, que o titular de direitos pode afastar de forma legível por máquina. É uma disposição diferente do artigo 15, no qual se baseia a disputa dos editores com a Google. O primeiro diz respeito a se é permitido copiar conteúdo para análise e treino. O segundo diz respeito a se e quanto uma plataforma paga pelo uso de publicações nos seus serviços. Uma linha no robots.txt não é nem um contrato, nem uma solicitação de compensação.
Content-Signal também tem uma limitação técnica que descrevemos no nosso próprio exemplo: uma linha colocada apenas num grupo de wildcard não chega aos crawlers que têm as suas próprias secções no ficheiro. No nosso ficheiro o sinal está agora separado em grupos para cada crawler, incluindo o grupo Google-Extended. Não medimos quais os operadores que o respeitam e não o afirmamos.
noindex como única saída completa do motor de busca
A documentação da Google é clara de que para bloquear completamente o aparecimento de conteúdo no Google Search, é necessário usar noindex. No WordPress desde a versão 5.7 a meta tag robots é configurada através de um filtro wp_robots, e a maioria dos plugins SEO o fazem por artigo ou por tipo de conteúdo. O noindex remove a página dos resultados, do News e do Discover, ou seja, dos serviços pelos quais o editor pode exigir compensação, por isso não oferece nada nas negociações. Faz sentido para arquivos de tags, páginas de pesquisa e conteúdo técnico, não para artigos editoriais.
Como rever as configurações do site após as acusações da UOKiK
Uma revisão de um site de notícias no WordPress em cinco passos:
- Descarregue
robots.txtda produção comcurle verifique se o servidor está a devolver um ficheiro físico ou gerado. Os plugins de cache e CDN podem estar a servir uma versão antiga. - Liste os grupos User-agent e verifique se as declarações nas quais tem interesse estão em cada grupo ao qual devem aplicar-se.
- Guarde o estado do relatório de desempenho da função de IA generativa no Search Console. Sem um ponto de referência não conseguirá avaliar o efeito de uma mudança.
- Decida sobre o controlo de IA generativa separadamente para a propriedade de domínio e para as secções configuradas como propriedades separadas.
- Reveja onde está o noindex. Um template que acidentalmente adiciona noindex a categorias de notícias custa mais do que qualquer decisão sobre IA.
Se também está a publicar com o objetivo de respostas generativas, o contexto destas decisões está descrito no guia sobre GEO. Desativar o site das funções generativas enquanto otimiza para citações nestas mesmas funções são dois objetivos contraditórios, por isso escolha um conscientemente.
O que vem a seguir com o processo da UOKiK contra a Google
O processo continua e o comunicado não fornece um prazo para a decisão. Há três pontos a seguir. O primeiro é o próprio processo da UOKiK e uma possível decisão com multa. O segundo são as negociações dos editores com a Google e o possível papel do Presidente da UKE se não houver acordo. O terceiro é o processo da Comissão Europeia sobre os serviços de IA, que pode afetar diretamente os AI Overviews, o que o caso polaco não faz.
O comunicado coloca o caso numa sequência mais larga: a UOKiK está a terminar um processo concorrencial contra a Apple, e contra a Meta conduz um processo investigativo sobre como a plataforma passou a apresentar ligações para publicações de imprensa. Um editor consegue alterar as configurações técnicas do seu site por conta própria, em menos de uma hora, e pode medir o seu efeito no Search Console. O direito à compensação decorre da lei e é resolvido nas negociações, perante o Presidente da UKE ou indiretamente através do processo da UOKiK.