Ten akapit czyta model, zanim przeczyta go człowiek. To jedno zdanie zmienia pracę redakcji bardziej niż cała reszta rozmowy o wyszukiwaniu AI, bo przesuwa decyzję o tym, co wchodzi na początek tekstu, z działu marketingu do kogoś, kto wie, jak wygląda fragment pobrany przez system odpowiedzi. Redaktor, który do niedawna pisał lead pod kliknięcie, dziś pisze go pod ekstrakcję, a to są dwa różne zawody wykonywane w tym samym polu formularza.
Gartner prognozował 25% spadek tradycyjnego wolumenu wyszukiwań. Prognoza jest prognozą i nie zastąpi pomiaru, ale kierunek potwierdza to, co widać w logach: rosnąca część żądań do strony nie pochodzi od przeglądarki z człowiekiem po drugiej stronie. Poniżej siedem rzeczy, które z tego wynikają dla osoby układającej tekst, plus mechanizm każdej z nich, bo bez mechanizmu zostaje lista poleceń do wykonania na wiarę.
Kto pisze pierwszy akapit i po co

W klasycznej redakcji pierwszy akapit miał jedno zadanie: zatrzymać człowieka, który przyszedł z listy wyników i ma palec nad przyciskiem wstecz. Wolno mu było zwlekać, budować napięcie, obiecywać odpowiedź w dalszej części. Metryka, która go oceniała, to czas na stronie i współczynnik odrzuceń, a obie nagradzały odwlekanie.
System generatywny czyta ten sam akapit w zupełnie innym trybie. Nie ocenia go, nie zostaje na stronie, nie wraca. Pobiera fragment, sprawdza, czy fragment odpowiada na podzapytanie, które właśnie rozwiązuje, i albo wstawia go do odpowiedzi z przypisem do domeny, albo idzie dalej. Nie ma kroku, w którym model docenia, że sedno przyszło w akapicie ósmym. Do akapitu ósmego zwykle nie dociera, bo pobrał to, co zmieściło się w oknie, i przeszedł do następnego źródła.
Stąd pierwsza zmiana organizacyjna: akapit otwierający przestaje być tekstem reklamowym, a staje się fragmentem technicznym, który ma sens w oderwaniu od reszty. Pisze go osoba, która zna tezę i potrafi ją postawić bez rozbiegu, nie osoba od nagłówków. W praktyce oznacza to, że lead powstaje na końcu pracy nad tekstem, a nie na początku, bo dopiero wtedy wiadomo, jakie twierdzenie tekst faktycznie udźwignął.
Druga zmiana dotyczy tego, kto ma prawo powiedzieć nie. Redakcja pracująca pod cytowanie potrzebuje kogoś, kto wykreśla zdania mówiące o następnych zdaniach, zapowiedzi typu “poniżej omawiamy” i wstępy, które streszczają tytuł innymi słowami. Takie zdanie kosztuje miejsce w oknie kontekstu i nie wnosi faktu, który dałoby się pobrać. W tekście dla człowieka jest neutralne. W tekście dla modelu jest stratą.
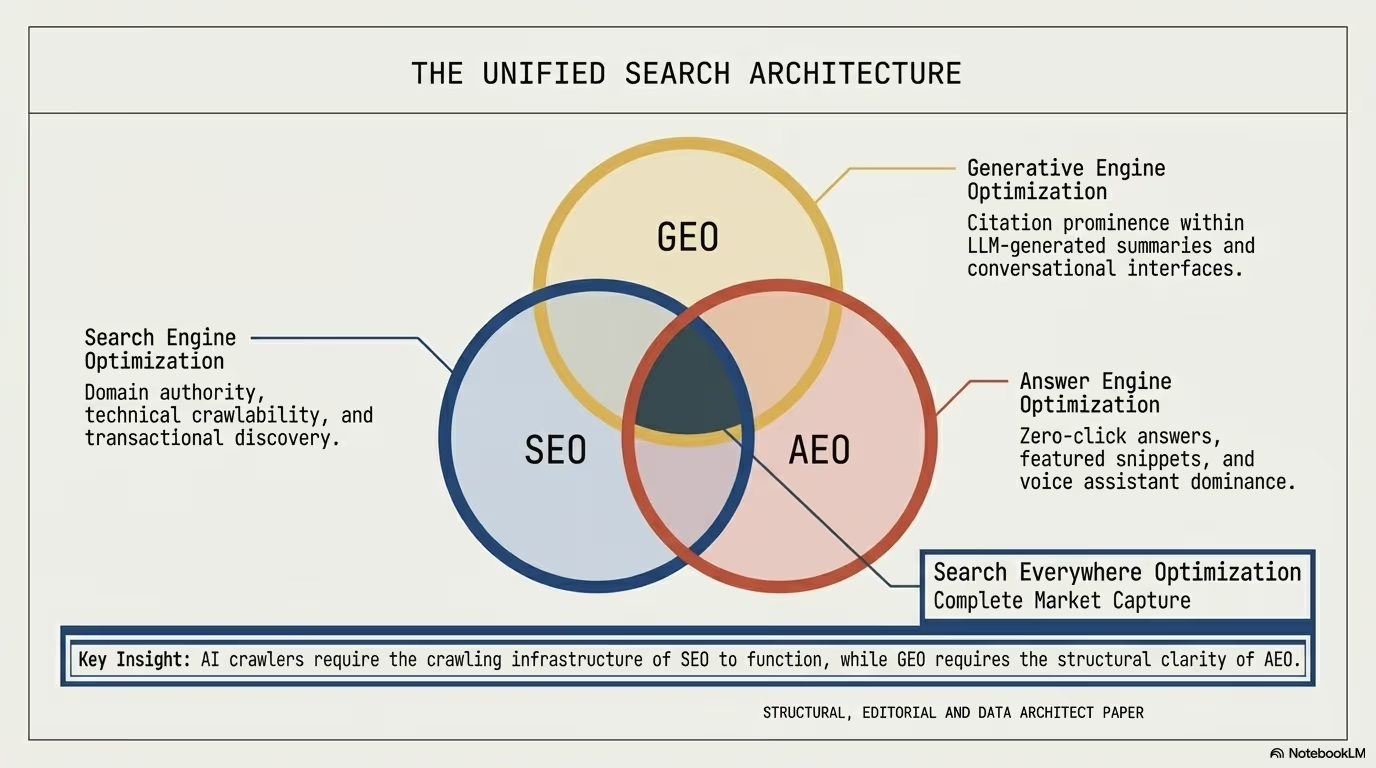
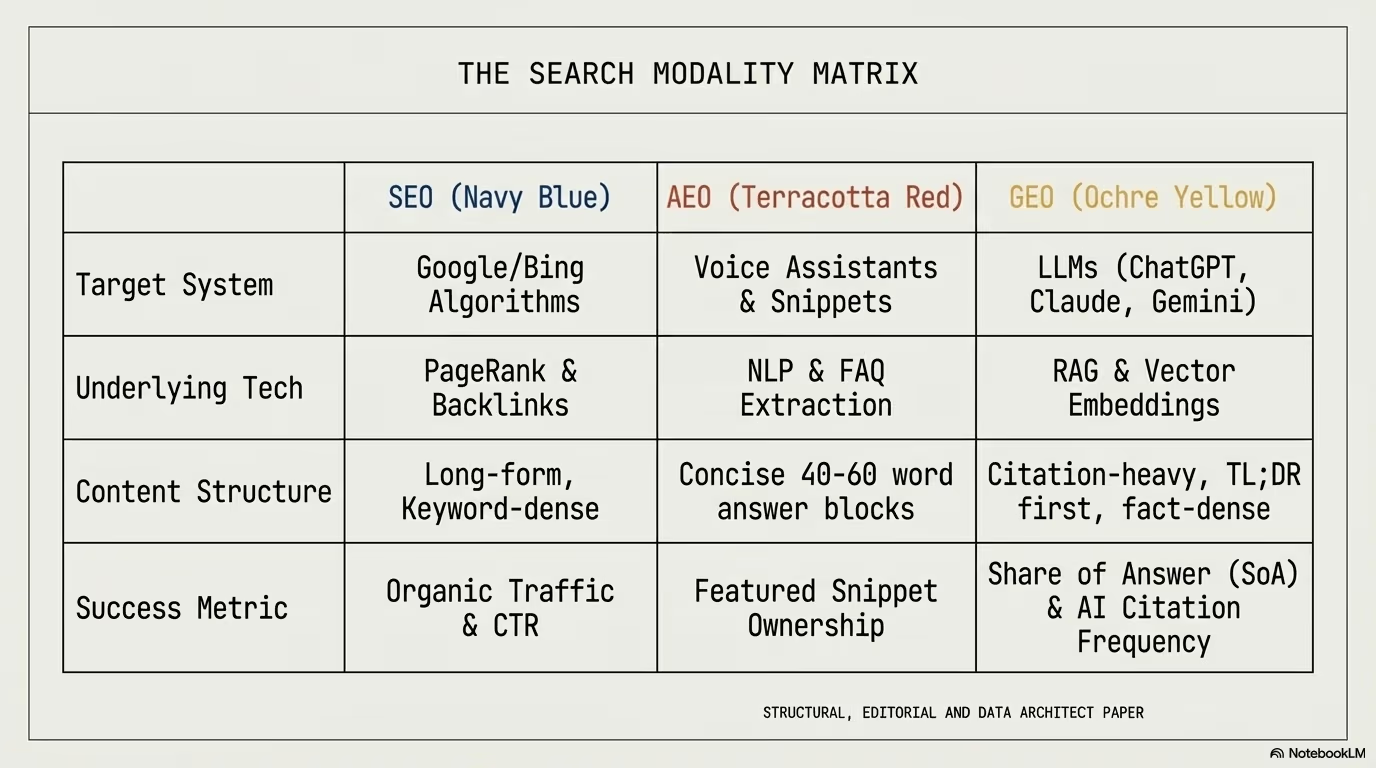
Różnica między SEO a tym, co dziś nazywa się Generative Engine Optimization, sprowadza się do tego, co każdy z tych systemów nagradza. Wyszukiwarka nagradza stronę, na którą człowiek kliknie, więc premiuje obietnicę. Silnik odpowiedzi nagradza stronę, którą może zacytować bez ryzyka, więc premiuje sprawdzalne twierdzenie postawione wprost. Te dwa cele nie są sprzeczne, ale wymagają różnych akapitów w różnych miejscach tego samego tekstu, i redakcja, która tego nie rozdziela, produkuje materiał, który ani nie sprzedaje, ani nie jest cytowany.
Trzecia zmiana jest najmniej oczywista i dotyczy źródeł. Tekst pisany pod cytowanie musi nazywać, skąd bierze każdą liczbę, bo model, który nie potrafi przypisać liczby do źródła w obrębie pobranego fragmentu, ma powód, żeby jej nie użyć. Liczba bez nazwiska albo nazwy instytucji obok jest dla systemu odpowiedzi materiałem ryzykownym, a ryzyko rozstrzyga się na niekorzyść źródła. To dlatego w tym tekście każda statystyka stoi obok tego, kto ją zmierzył, nawet kiedy brzmi to ciężej niż samo zdanie.
Liczby o wzroście ruchu z AI cytuje się wszędzie i prawie nigdzie się ich nie źródłuje, więc nie dokładamy kolejnej. Powodem do ostrożności jest sama arytmetyka: ruch z asystentów AI startuje z ułamka procenta wizyt, a ułamek procenta, który się potroi, daje nagłówkową liczbę i prawie żadnych odwiedzających za nią. Pomiar, za którym możemy stanąć, jest nasz własny. Przez 23 godziny w sierpniu 2026 roku 72,4% żądań do tej strony miało nierozpoznany user agent, wobec 19,7% z Chrome, a nazwane crawlery wyszukiwarek złożyły się na 3,5%. Metoda i pełne liczby są w pomiarze ruchu botów na małej stronie. Siedem wniosków poniżej nie opiera się więc na tempie wzrostu, tylko na tym, co widać w logach serwera już dziś.
1. Pierwsze 200 słów to jedyna część tekstu, którą model przeczyta na pewno
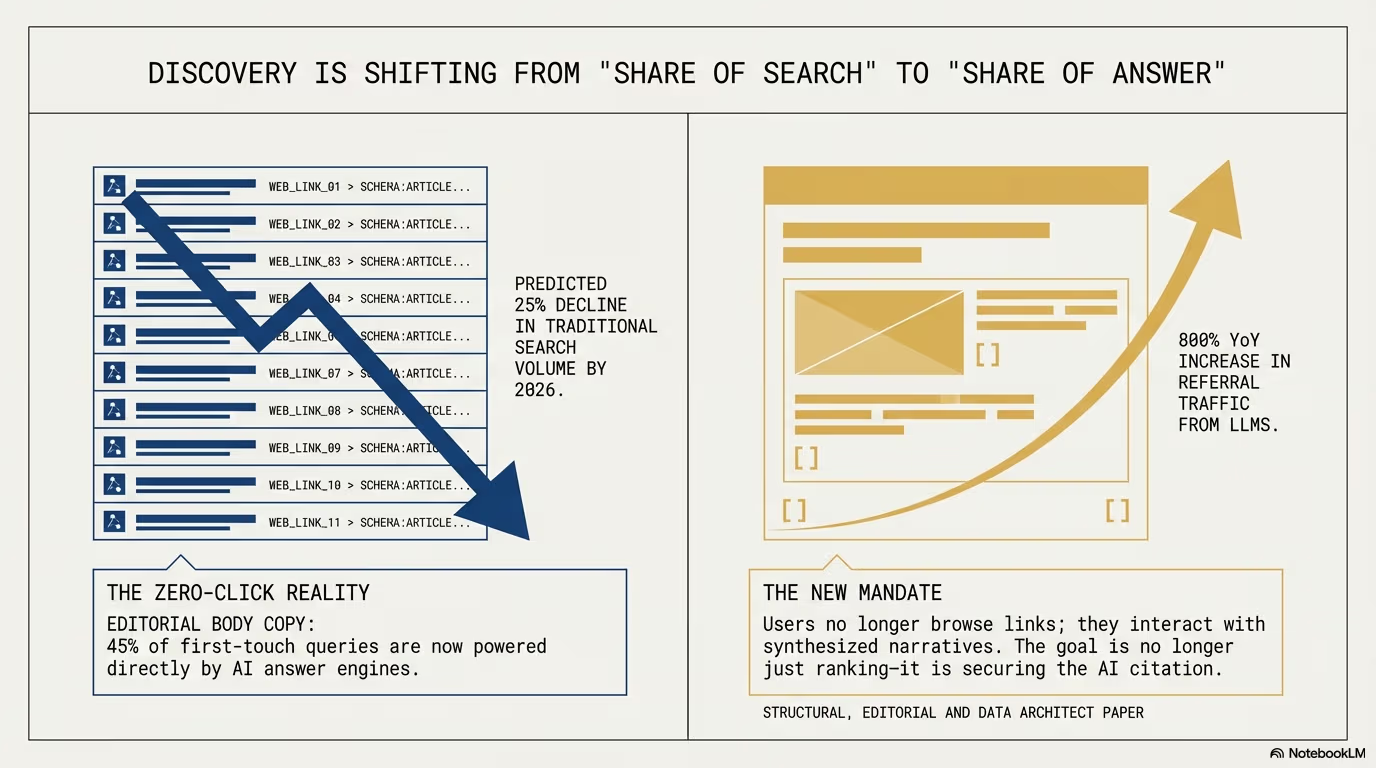
Systemy odpowiedzi działają w trybie Retrieval-Augmented Generation. Zapytanie użytkownika idzie najpierw do warstwy wyszukiwania, ta zwraca fragmenty dokumentów, i dopiero te fragmenty trafiają do modelu jako kontekst. Model nigdy nie widzi twojej strony. Widzi kilka kawałków tekstu wyrwanych z kontekstu, obok kawałków z innych stron, i wybiera, który z nich wstawić do odpowiedzi.
Kevin Indig przeanalizował 1,2 miliona odpowiedzi ChatGPT i ustalił, że 44,2% zweryfikowanych cytatów LLM pochodzi z pierwszych 30% strony. To nie jest twierdzenie o tym, że modele są leniwe. To konsekwencja tego, jak dzieli się dokument na fragmenty: podział idzie po nagłówkach i akapitach od góry, a fragment otwierający ma najwięcej sygnałów pozwalających dopasować go do zapytania, bo zwykle zawiera temat nazwany wprost.
Konsekwencja redakcyjna jest prosta w opisie i trudna w praktyce. Otwarcie ma zawierać odpowiedź, nie zapowiedź odpowiedzi. Zwięzłe podsumowanie poniżej 300 słów, które odpowiada na główne pytanie, a potem dopiero rozwinięcie z dowodami. Trudność polega na tym, że tak napisany tekst wygląda w edytorze jak tekst, który zdradził pointę, i pierwszy odruch każdego redaktora jest taki, żeby ją cofnąć w głąb.
Głębia nie znika, zmienia się jej miejsce. Najbardziej wartościowe do cytowania fakty, liczby i zdania deklaratywne idą na początek. Kontekst, zastrzeżenia, przypadki graniczne i dowody idą dalej, bo one budują autorytet u człowieka, który już został, i u modelu, który sprawdza, czy źródło zna temat szerzej niż jedno zdanie.
“Najpierw odpowiedź na pytanie, potem wyjaśniaj niuanse. Tak właśnie należy podchodzić do pisania pod wyszukiwanie AI: jasność na pierwszym miejscu, głębia na drugim.”
Praktyczny test, który da się wykonać w redakcji bez żadnego narzędzia: skopiuj pierwsze 200 słów tekstu do pustego dokumentu i przeczytaj je jak obcy. Jeśli ten wycinek sam w sobie nie odpowiada na pytanie z tytułu, żaden system odpowiedzi też go tak nie odczyta, bo dostał dokładnie tyle samo, ile ty w tym pustym dokumencie. Jeśli odpowiada, ale bez nazwanego źródła, dopisz źródło w tym wycinku, nie w przypisie na dole.
Jest też zastrzeżenie, o którym rzadko się mówi. Architektura “odpowiedź na początku” działa przeciwko tekstom, których teza brzmi “to zależy”. Kiedy uczciwa odpowiedź jest warunkowa, otwarcie ma zawierać warunek postawiony wprost, a nie obietnicę rozstrzygnięcia w dalszej części. Zdanie “dla sklepu na hostingu współdzielonym odpowiedź brzmi X, dla sklepu na własnym serwerze Y” jest fragmentem nadającym się do pobrania. Zdanie “odpowiedź zależy od kilku czynników, które omówimy poniżej” nie jest.
2. Większość cytowań AI pochodzi spoza organicznego top 10
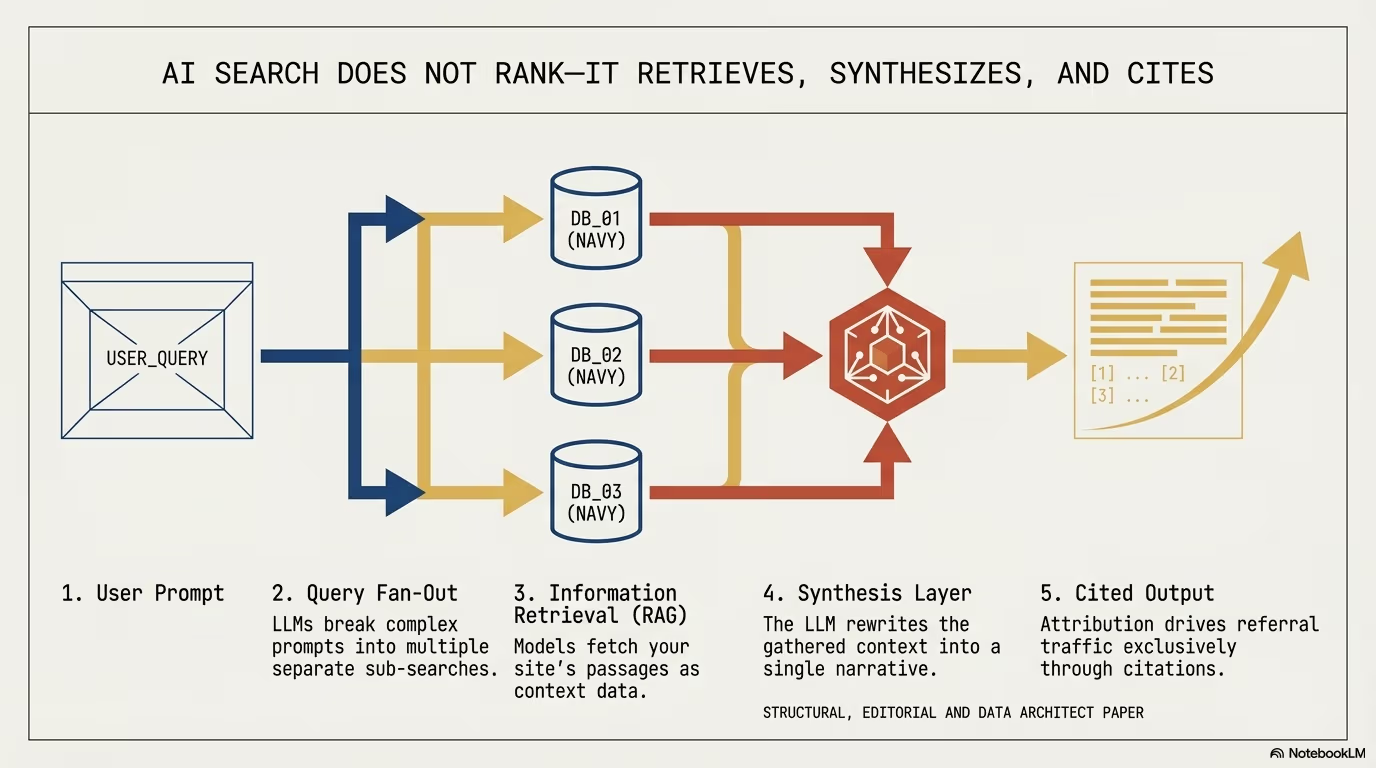
Digital Applied przeanalizował 863 412 zapytań między październikiem 2025 a lutym 2026 i ustalił, że 62% cytowań AI Overview pochodzi ze stron na pozycji jedenastej lub niższej, albo w ogóle spoza pierwszej setki. Dla redakcji to najbardziej niewygodna liczba z całego zestawu, bo unieważnia jedyny raport, który dział treści zwykle dostaje co miesiąc.
Mechanizm rozejścia się tych dwóch systemów jest do opisania bez metafor. Ranking organiczny rozstrzyga, która strona ma być pokazana człowiekowi jako propozycja, więc waży sygnały mówiące o tym, czy człowiek będzie zadowolony: autorytet domeny, profil linków, zachowanie użytkowników na wyniku. Warstwa wyszukiwania w silniku generatywnym rozstrzyga coś innego: który fragment nadaje się do wklejenia w odpowiedź, za którą system weźmie odpowiedzialność. Tam wygrywa jednoznaczność sformułowania i to, czy fakt da się wyjąć bez zniekształcenia.
Dlatego strona może być zoptymalizowana pod SEO bez zarzutu i pozostawać niewidoczna w odpowiedziach, a mały serwis z dobrze poukładanymi twierdzeniami może być cytowany obok serwisów o sto razy większym profilu linkowym. To działa w obie strony i to jest w tej liczbie ciekawe: 62% to nie tylko ostrzeżenie dla dużych, to również jedyna realna szansa dla małych, jaka pojawiła się w wyszukiwaniu od lat.
Co z tym robi redakcja. Po pierwsze, przestaje traktować raport pozycji jako miarę widoczności i dokłada drugi pomiar: czy i w jakim brzmieniu marka pojawia się w odpowiedziach na pytania, które realnie zadają klienci. Po drugie, przestaje wybierać tematy wyłącznie po wolumenie wyszukiwań, bo wolumen opisuje zachowanie z pola wyszukiwarki, a nie z okna rozmowy. Po trzecie, akceptuje, że część najlepiej pracujących tekstów nie pokaże wzrostu kliknięć, tylko wzrost wzmianek, i że ktoś w organizacji musi się zgodzić na taki wynik zanim tekst powstanie, a nie po fakcie.
Czego ta liczba nie mówi, a bywa tak czytana: nie mówi, że SEO przestało mieć znaczenie. Strona musi być dostępna dla crawlera, szybka, poprawnie zaindeksowana i linkowana wewnętrznie, bo warstwa wyszukiwania silnika odpowiedzi w dużej części korzysta z tej samej infrastruktury i tych samych indeksów. Mówi tylko tyle, że pozycja w rankingu przestała być warunkiem wystarczającym, nie że przestała być warunkiem.
3. Autorytet to sieć, nie strona
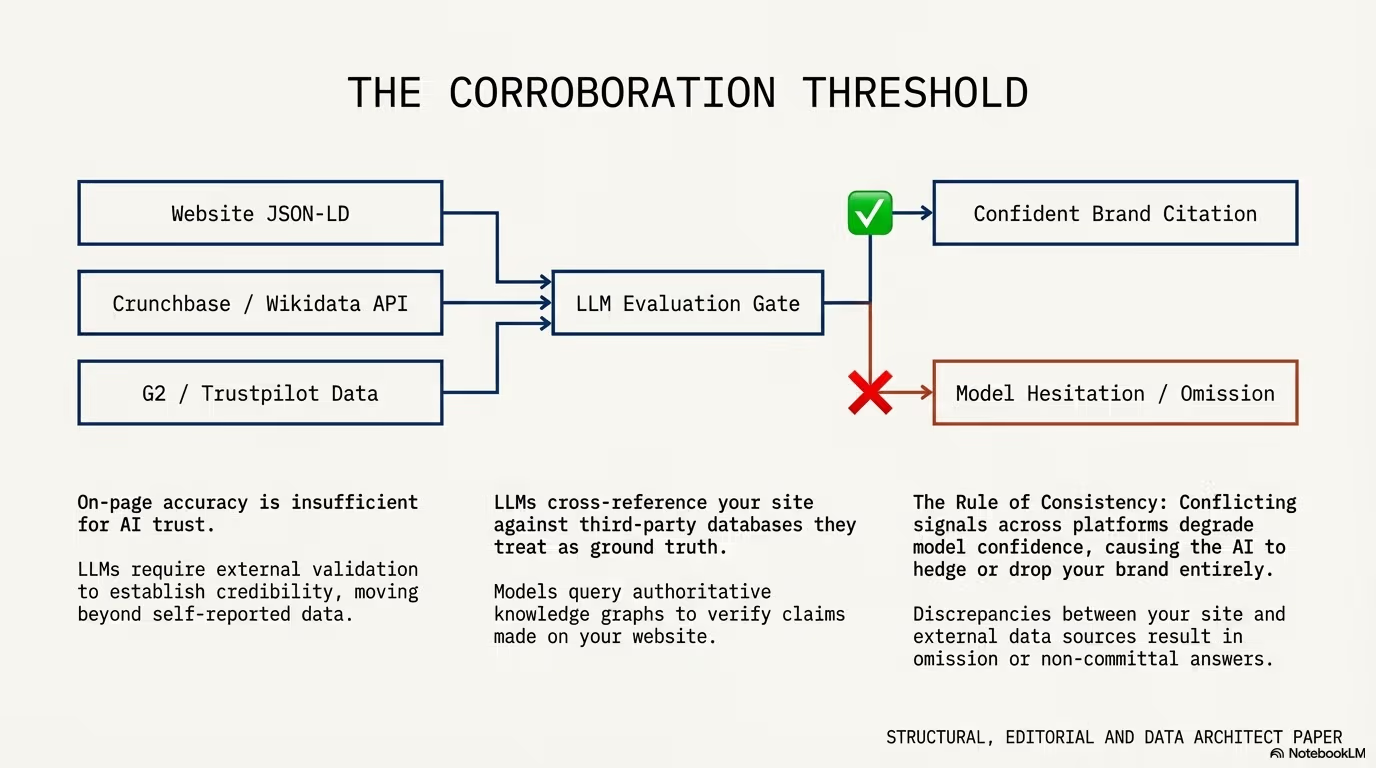
Yext przeanalizował 6,8 miliona cytowań AI i ustalił, że 86% cytatów pochodzi ze stron z pięcioma lub więcej powiązanymi materiałami na dany temat. Izolowane strony, niezależnie od tego, jak dobrze są napisane, rzadko zdobywają cytowania, bo model nie ma jak zweryfikować szerszego kontekstu źródła.
Nie znaleźliśmy opublikowanego badania, które przypisywałoby architekturze filarowej jeden mnożnik cytowań, więc go nie podajemy. Zbiór Yext potwierdza kierunek, nie współczynnik: próg pięciu powiązanych materiałów to miejsce, w którym udział w cytowaniach się zagęszcza. Mechanizm pod spodem to weryfikacja. Model układający odpowiedź musi rozstrzygnąć, czy źródło, które zaraz wymieni, faktycznie zna temat, czy tylko trafiło w jedną frazę. Pojedyncza strona daje mu jeden punkt odniesienia i żaden sposób, żeby go sprawdzić. Filar z ośmioma podstronami, z których każda opisuje inny wycinek tematu i każda linkuje z powrotem, daje graf do przejścia, zanim model wstawi nazwę marki w odpowiedź, której nie będzie mógł wycofać.
Dla redakcji oznacza to zmianę jednostki planowania. Planuje się nie artykuł, tylko zestaw: stronę filarową plus materiały rozwijające konkretne podtematy, z linkowaniem w obie strony i opisowymi anchorami. Kalendarz publikacji przestaje być listą tytułów po dacie, a staje się listą zestawów, z których żaden nie wychodzi w połowie. Materiał, który nie ma dokąd linkować i z czego być linkowany, czeka albo nie powstaje.
Przykład z naszego podwórka: dział o bezpieczeństwie WordPressa nie jest jednym tekstem o bezpieczeństwie. To strona główna tematu plus konfiguracja firewalla, wykrywanie malware, zabezpieczanie logowania, wdrożenie SSL, skanowanie podatności wtyczek i reagowanie na incydent. Każdy z tych materiałów opisuje inną decyzję, każdy linkuje do pozostałych, i dopiero razem dają grafowi kształt, po którym da się przejść.
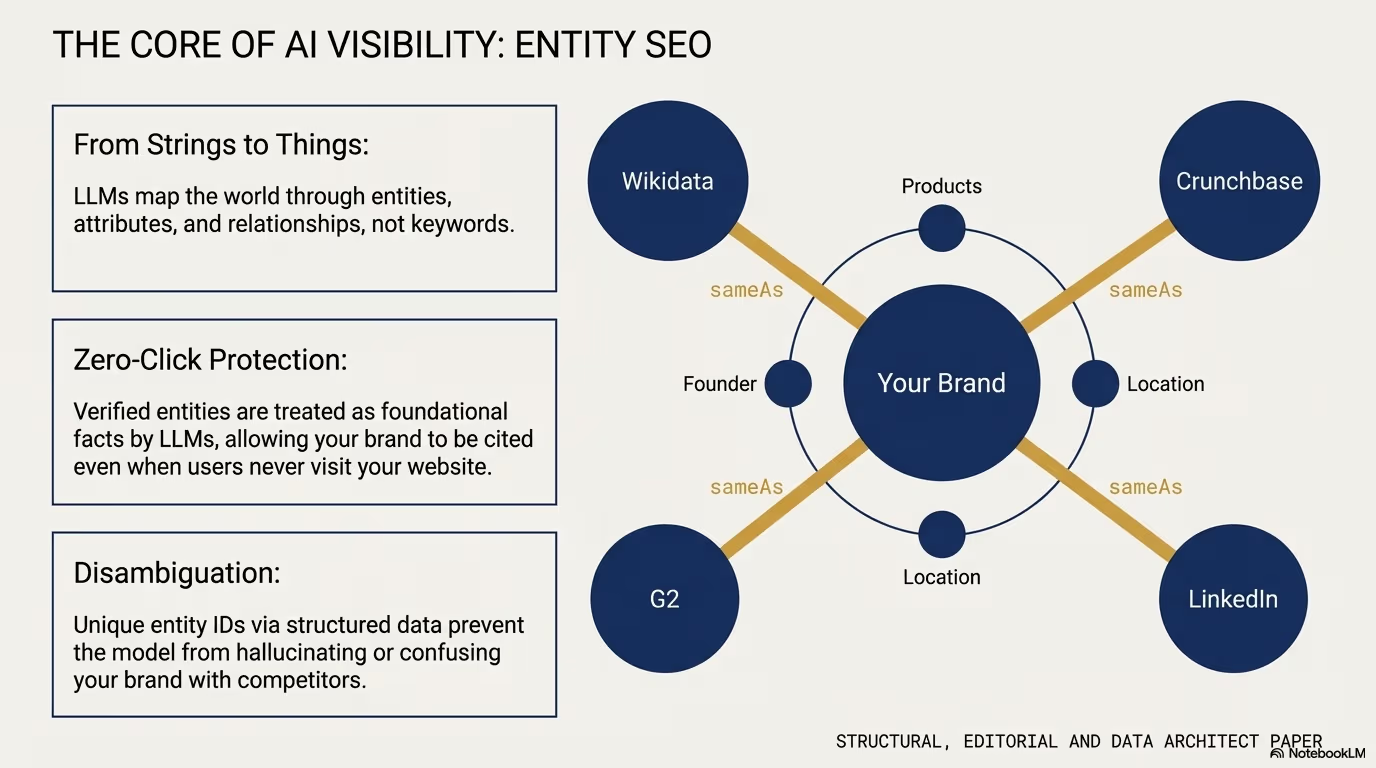
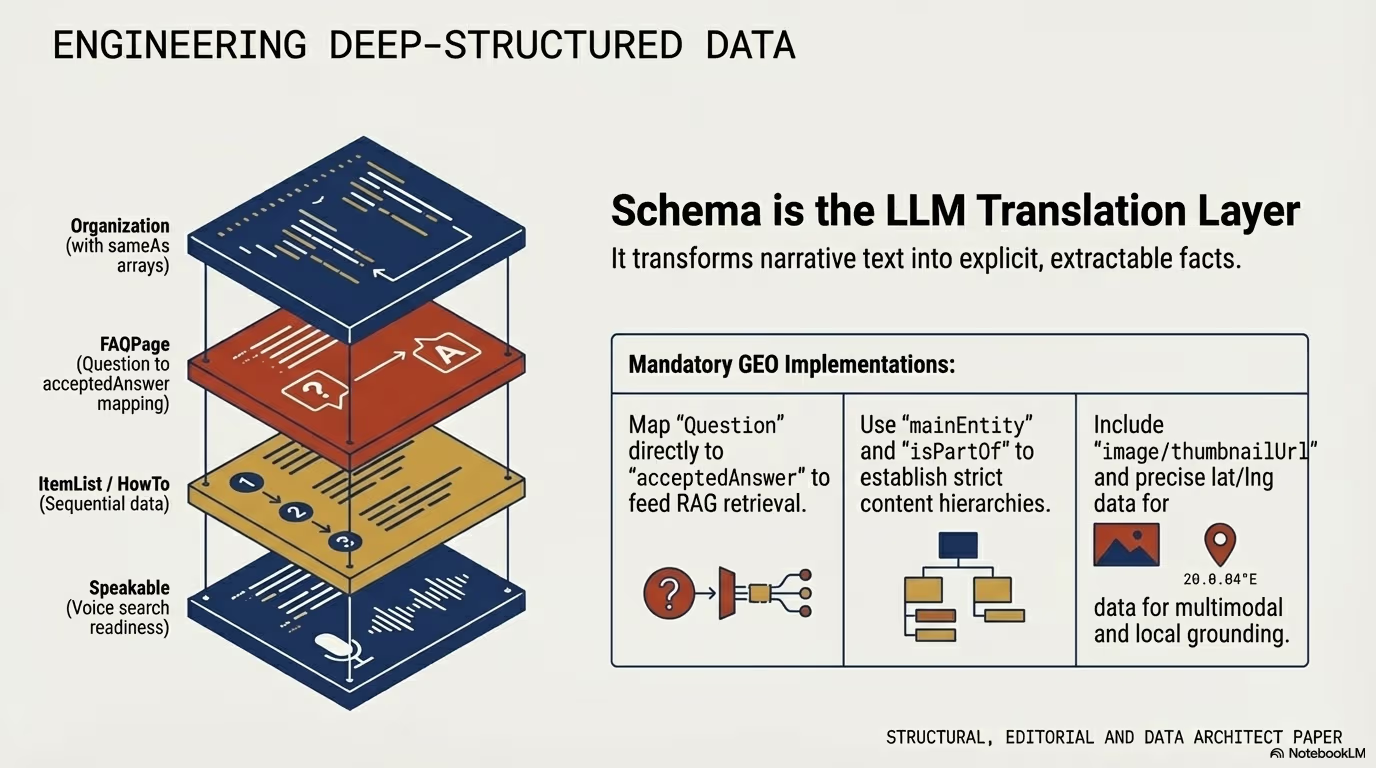
Podejście entity-first idzie dalej i dotyczy już nie planu, tylko warstwy danych. Kluczowe pojęcia w tekście powinny być powiązane z odpowiednimi encjami Wikidata, a dane strukturalne mają pokazywać relacje między nimi. To jest ta część roboty, której redakcja zwykle nie widzi, bo siedzi we frontmatterze albo w szablonie, i dlatego bywa pomijana. Tymczasem to ona odróżnia zbiór tekstów o podobnym słownictwie od bazy wiedzy, w której model potrafi ustalić, o czym dokładnie jest mowa.
Jest tu pułapka warta nazwania. Klaster zbudowany z pięciu tekstów, które mówią to samo innymi słowami, żeby zapełnić slot, nie daje żadnej weryfikacji, tylko pięciokrotnie powtórzony ten sam punkt odniesienia. Próg pięciu materiałów jest progiem pokrycia tematu, nie progiem liczby plików.
4. Świeżość jest warunkiem wejścia, nie premią
Badanie Seer Interactive nad wpływem aktualności treści na widoczność w AI pokazuje, że treści aktualizowane w ciągu 90 dni osiągają około dwukrotnie wyższy wskaźnik cytowań niż materiały starsze. W drugą stronę działa to jeszcze ostrzej: materiały nietykane dłużej niż osiemnaście miesięcy są przez silniki generatywne w dużej mierze pomijane, niezależnie od historycznego autorytetu domeny.
Powód nie jest arbitralny. System odpowiedzi ponosi koszt reputacyjny za podanie nieaktualnej informacji, i to koszt widoczny dla użytkownika w tej samej sekundzie. Data ostatniej modyfikacji jest tanim sygnałem pozwalającym ten koszt ograniczyć, więc jest używana szeroko, także tam, gdzie treść wcale się nie zestarzała. To jest niesprawiedliwe wobec tekstów o rzeczach niezmiennych i nic z tym nie zrobimy poza uznaniem tego za warunek pracy.
Dla redakcji to najdroższa z siedmiu zmian, bo dotyczy nie pisania, tylko utrzymania. Koszt utrzymania tekstu zrównuje się z kosztem jego napisania, a budżet działu treści, który tego nie uwzględnia, po roku ma archiwum i żadnych mocy na jego odświeżanie. Praktycznie oznacza to, że plan kwartalny ma dwie kolumny: co nowego powstaje i co ze starego wraca do obiegu, i że druga kolumna nie jest tą, którą się skreśla, gdy zabraknie czasu.
Odświeżenie, które coś daje, wymienia liczby na aktualne wraz ze źródłami, dopisuje sekcję o tym, co pojawiło się od ostatniej wersji, sprawdza, czy linki zewnętrzne wciąż prowadzą tam, gdzie prowadziły, i rewiduje rekomendacje, które się zdezaktualizowały. Odświeżenie, które nic nie daje, przestawia datę w frontmatterze. Systemy porównują wersje dokumentu, więc kosmetyczna zmiana jest rozpoznawalna, a strona, która robi to seryjnie, uczy crawler, że jej sygnał daty nic nie znaczy.
Warto też powiedzieć, czego ta zasada nie oznacza. Nie oznacza, że każdy tekst ma być przepisywany co kwartał. Oznacza, że każdy tekst ma mieć właściciela i termin przeglądu, a przegląd może skończyć się wnioskiem, że nic się nie zmieniło, i wtedy datą się nie rusza. Kwartalny przegląd to czynność redakcyjna. Kwartalna zmiana daty to fałszowanie sygnału.
5. Warstwa legitymizacji, czyli dlaczego własna strona nie wystarcza
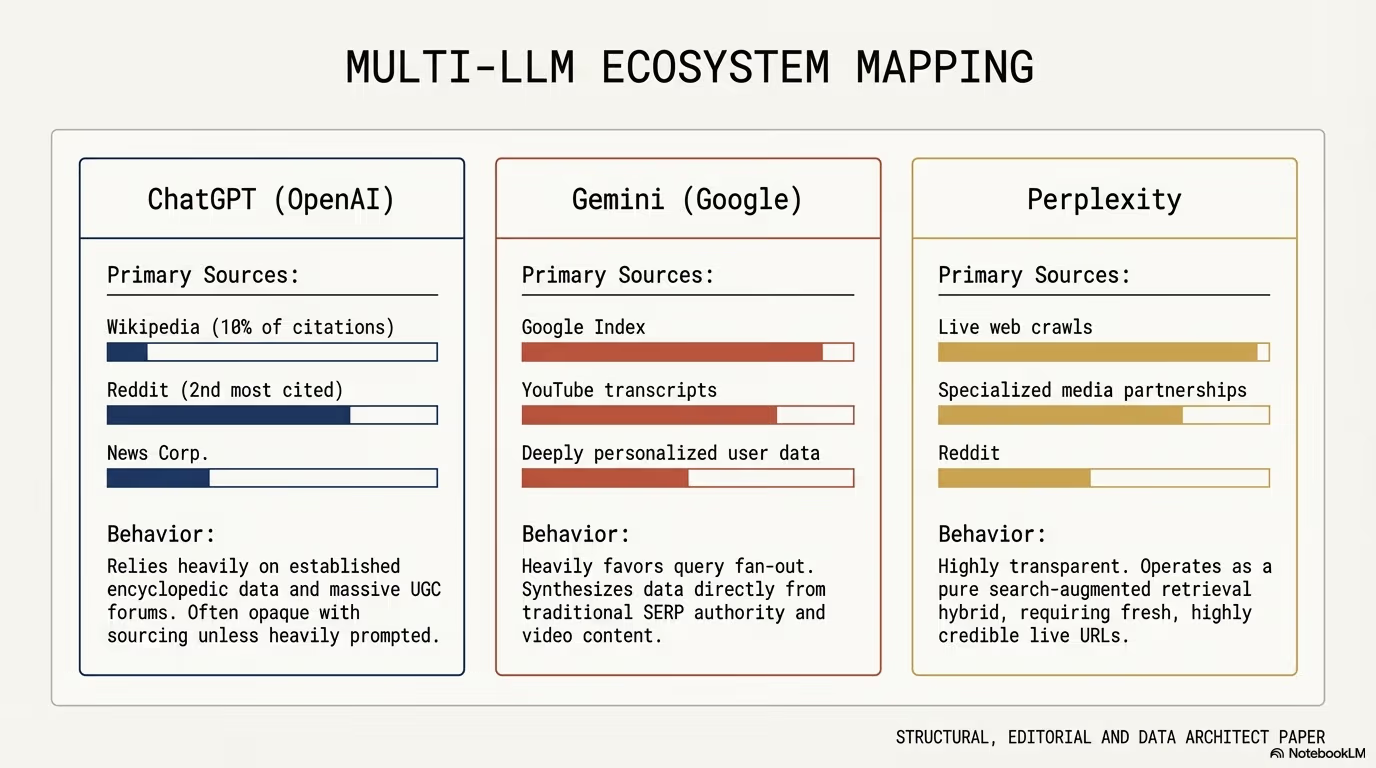
Profound zmierzył, że Wikipedia odpowiada za 7,8% wszystkich cytatów ChatGPT. Jedna platforma generuje więcej cytowań niż większość całych korporacyjnych serwisów razem. Drugie w kolejności źródło, Reddit, zostaje w tyle, ale wciąż odpowiada za dużą część referencji.
“Wikipedia prowadzi w cytowaniach ChatGPT z udziałem 7,8%, podczas gdy drugie najczęściej cytowane źródło, Reddit, pozostaje daleko w tyle… służy jako ‘warstwa legitymizacji’ dla firm.”
Mechanizm da się opisać bez mistyki. Model wybierając źródło do odpowiedzi rozstrzyga między treścią, którą podmiot napisał sam o sobie, a treścią, którą napisał o nim ktoś inny. Pierwsza ma oczywisty interes w tym, żeby wypadła korzystnie. Druga przeszła przez cudzą redakcję albo cudzą moderację, więc niesie sygnał, którego marka nie mogła sobie wystawić sama. To nie jest ocena jakości, tylko ocena tego, kto ponosi koszt nieprawdy.
Dlatego kolejność bywa odwrotna, niż zakłada plan contentowy: żeby być cytowanym z własnej domeny, trzeba wcześniej zaistnieć tam, gdzie modelowi wolno sprawdzić. Wzmianka w publikacji branżowej, wątek na forum, w którym ktoś inny opisuje wdrożenie, wystąpienie, którego nagranie ma opis, dokumentacja w cudzym repozytorium. Każda z tych rzeczy przesuwa próg, po którym model uznaje, że cytowanie twojej strony jest bezpieczne.
Dla redakcji wniosek jest niewygodny, bo wykracza poza jej kompetencje. Część pracy, która realnie decyduje o widoczności w odpowiedziach, nie polega na pisaniu tekstów na własnej stronie, tylko na tym, żeby ludzie z firmy byli obecni tam, gdzie toczy się rozmowa o temacie: odpowiadali na pytania, publikowali u innych, brali udział w społeczności. To robota, której nie da się zlecić na akord i której efekty widać po kwartałach, nie po tygodniach.
Osobne zastrzeżenie: to nie jest zaproszenie do rozsiewania wzmianek. Sztucznie budowana obecność na platformach, których moderacja tego nie chce, kończy się usunięciem i, w przypadku Wikipedii, śladem w historii edycji, który zostaje na stałe. Warstwa legitymizacji rośnie z tego, że ktoś inny uznał temat za wart opisania, i nie ma skrótu, który by to obchodził.
6. Plik /llms.txt i to, czego robots.txt nie robi
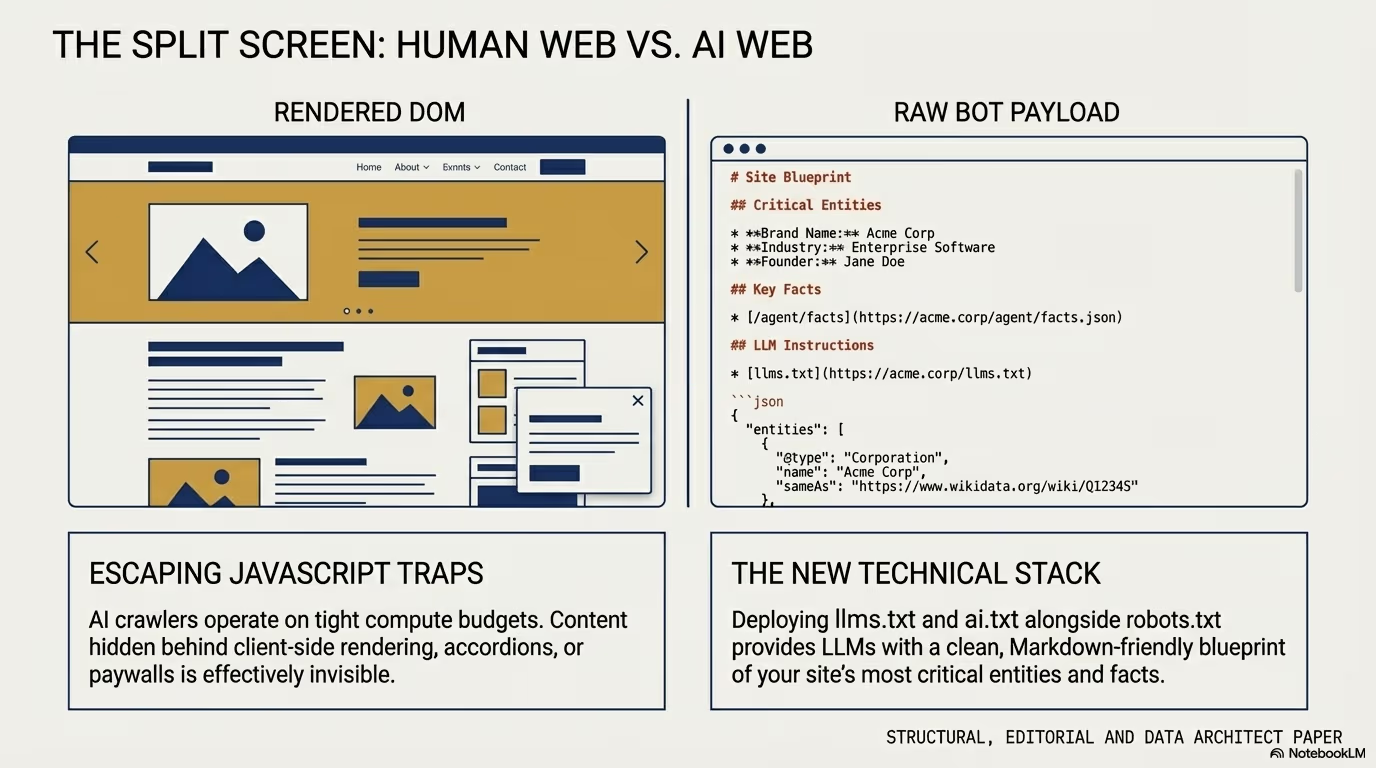
Warto rozdzielić dwie rzeczy, które ciągle się mylą. robots.txt to deklaracja, do czego crawler ma nie wchodzić. Jest dobrowolna, egzekwuje ją grzeczność klienta, a nie serwer, i nie mówi nic o tym, co zrobić z treścią, która została pobrana. /llms.txt nie kontroluje niczego. To katalog w Markdownie, który podaje modelowi uporządkowany opis serwisu na czas odpowiadania na pytanie.
Druga rzecz, która się myli, i która ma realne konsekwencje prawne oraz biznesowe: pobranie do treningu i pobranie do odpowiedzi to dwie różne operacje wykonywane przez różne klienty, często pod różnymi nazwami user agenta. Pierwsza zbiera materiał do nauki modelu i zwykle nie zostawia po sobie cytatu. Druga odwiedza stronę w trakcie rozmowy użytkownika, bo model potrzebuje aktualnego fragmentu, i to ona odpowiada za wzmianki w odpowiedziach. Blokada w robots.txt założona hurtem na wszystko, co ma w nazwie AI, potrafi odciąć tę drugą, zostawiając pierwszą, jeśli operator pierwszej nie respektuje reguły. Efekt jest odwrotny do zamierzonego: tracisz cytowania i nie zyskujesz ochrony.
Sprawdzenie, jak to wygląda u ciebie, nie wymaga żadnego narzędzia zewnętrznego. Logi serwera mają user agenta i adres, więc wystarczy zliczyć żądania po nazwie klienta i zobaczyć, co pobiera. Przy naszym pomiarze najciekawsze okazało się nie to, ile było crawlerów wyszukiwarek, tylko jak duża część ruchu nie przedstawia się w ogóle: 72,4% żądań z nierozpoznanym user agentem przy 3,5% od nazwanych crawlerów. Zestaw reguł, który adresuje wyłącznie nazwane boty, obejmuje więc drobny ułamek tego, co faktycznie puka do serwera.
Sam plik jest prosty do zrobienia i łatwy do zaniedbania. Zawiera obszary, w których serwis ma kompetencje, listę najważniejszych materiałów z jednozdaniowymi opisami i twierdzenia faktyczne, które da się zacytować. Wartość ma tylko wtedy, gdy jest aktualny, więc jego aktualizacja musi być krokiem w procesie publikacji, a nie osobnym zadaniem, o którym ktoś pamięta. Nieaktualny /llms.txt jest gorszy niż jego brak, bo podsuwa modelowi katalog, który rozmija się z zawartością strony.
Ostrożnie z obietnicami efektu. Standard jest młody, wsparcie po stronie operatorów nierówne, i nie ma tu pomiaru, za którym moglibyśmy stanąć. Traktujemy go jako tani porządek we własnym serwisie, który przy okazji zmusza do wypisania wprost, w czym jesteśmy dobrzy, a nie jako dźwignię widoczności.
7. Intencja ponad precyzję: siła query fan-out
SOCi Visibility Index podaje, że tradycyjne wpisywane wyszukiwania to średnio 4 słowa, a zapytania kierowane do AI średnio 23 słowa. Za tą różnicą stoi zmiana sposobu pytania: zamiast “najlepsze wtyczki bezpieczeństwa WordPress 2026” użytkownik opisuje sytuację, ograniczenia i cel w jednym zdaniu, na przykład że prowadzi sklep WooCommerce na hostingu współdzielonym, martwi się o bezpieczeństwo i nie chce spowolnić strony.
Silnik nie szuka takiego zdania w indeksie. Rozbija je na podzapytania i szuka osobno wtyczek, osobno ograniczeń hostingu współdzielonego, osobno wpływu na wydajność, a potem składa odpowiedź z kawałków pochodzących często z różnych źródeł. To jest query fan-out i to on tłumaczy, dlaczego cytowanie zdobywa się fragmentem, a nie całym tekstem.
Dla osoby piszącej wniosek jest konkretny: warto pisać akapity, które odpowiadają na jedno podzapytanie każdy, i nazywać w nich warunki wprost. Konstrukcja “jeśli jesteś w sytuacji X, zrób Y, ponieważ Z” wygrywa z “najlepsze podejście to Y”, bo zawiera to, czego model potrzebuje do dopasowania fragmentu do kontekstu użytkownika. Akapit, który miesza trzy wątki, jest dla systemu materiałem gorszym niż trzy akapity o jednym wątku każdy, nawet gdy niesie tę samą treść.
Zmienia to też sposób pracy nad słownictwem. Tekst przeładowany frazami kluczowymi jest w tym procesie karany nie dlatego, że ktoś go karze za intencję, tylko dlatego, że powtórzenie tej samej frazy w każdym akapicie obniża rozróżnialność fragmentów: wszystkie wyglądają podobnie, żaden nie wygrywa dopasowania do konkretnego podzapytania. Naturalny język, w którym każdy akapit mówi o czymś innym, daje warstwie wyszukiwania więcej do rozróżnienia.
Stąd rosnąca wartość treści z długiego ogona: sekcji pytań i odpowiedzi, rozpisanych poradników i rekomendacji zależnych od scenariusza. One z natury mają kształt, którego fan-out szuka, bo każdy element odnosi się do jednej sytuacji. To także jedyne miejsce, gdzie redakcja może wykorzystać wiedzę, której konkurencja nie ma: opisać przypadek graniczny, który faktycznie się zdarzył, zamiast ogólnej porady, którą model potrafi wygenerować sam.
Stać się odpowiedzią
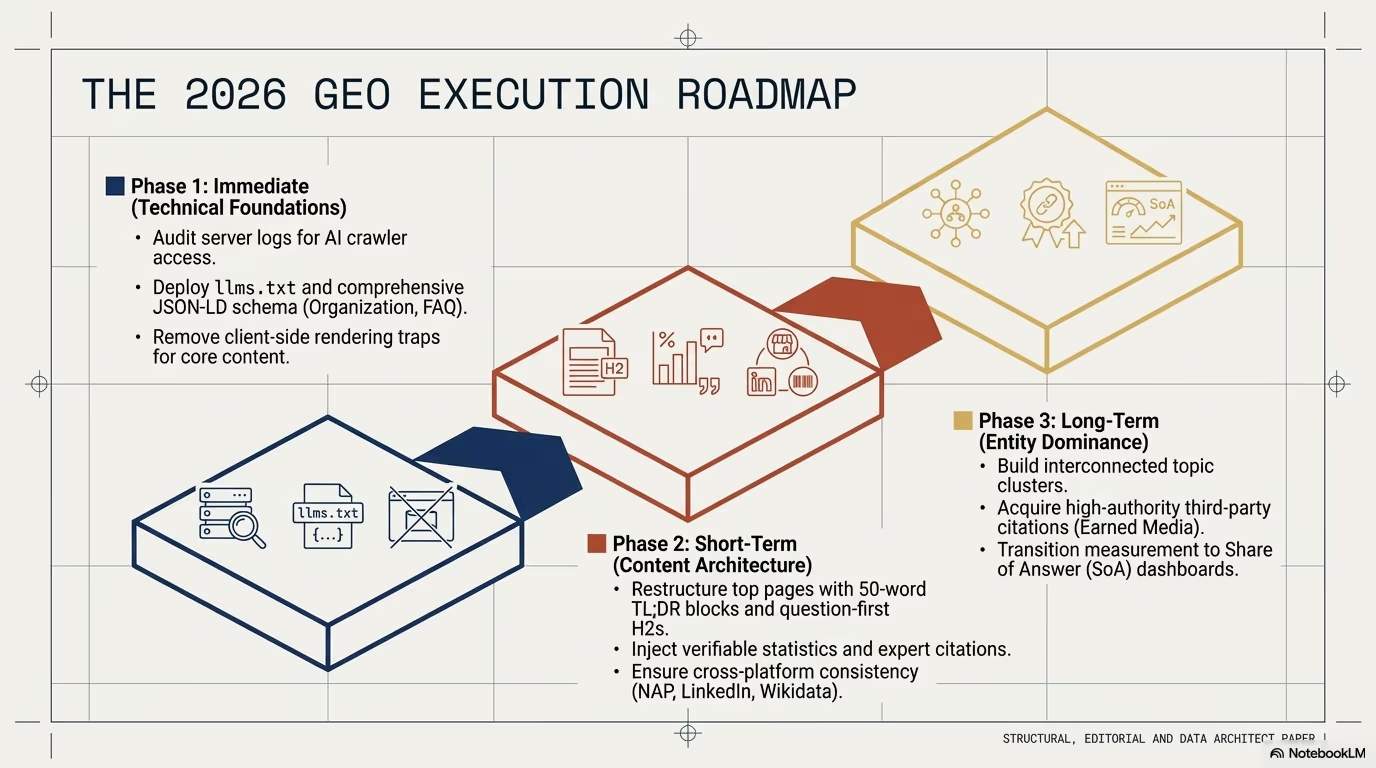
Widoczność przestała oznaczać miejsce na liście, a zaczęła oznaczać obecność w treści odpowiedzi. Dla redakcji sprowadza się to do siedmiu decyzji, które da się wpisać do procesu i sprawdzić bez żadnego narzędzia:
- Pierwsze 200 słów pisze osoba znająca tezę: otwarcie zawiera odpowiedź i jej źródło, a test polega na przeczytaniu tego wycinka w oderwaniu od reszty.
- Dwa pomiary zamiast jednego: pozycje w wyszukiwarce nadal się liczą, ale obok musi stać sprawdzenie, czy i jak marka pojawia się w odpowiedziach.
- Jednostką planowania jest zestaw, nie artykuł: strona filarowa plus materiały rozwijające podtematy, powiązane linkami w obie strony.
- Każdy tekst ma właściciela i termin przeglądu: przegląd może skończyć się wnioskiem, że nic się nie zmieniło, ale data nie zmienia się bez zmiany treści.
- Obecność poza własną domeną jest częścią pracy: bez cudzych wzmianek model nie ma czym potwierdzić tego, co piszesz o sobie.
- Porządek techniczny dla klientów maszynowych: aktualny katalog treści i świadome reguły dla botów, oparte na tym, co widać w logach, a nie na liście nazw.
- Akapit odpowiada na jedno podzapytanie: warunek nazwany wprost, jeden wątek na akapit, słownictwo naturalne.
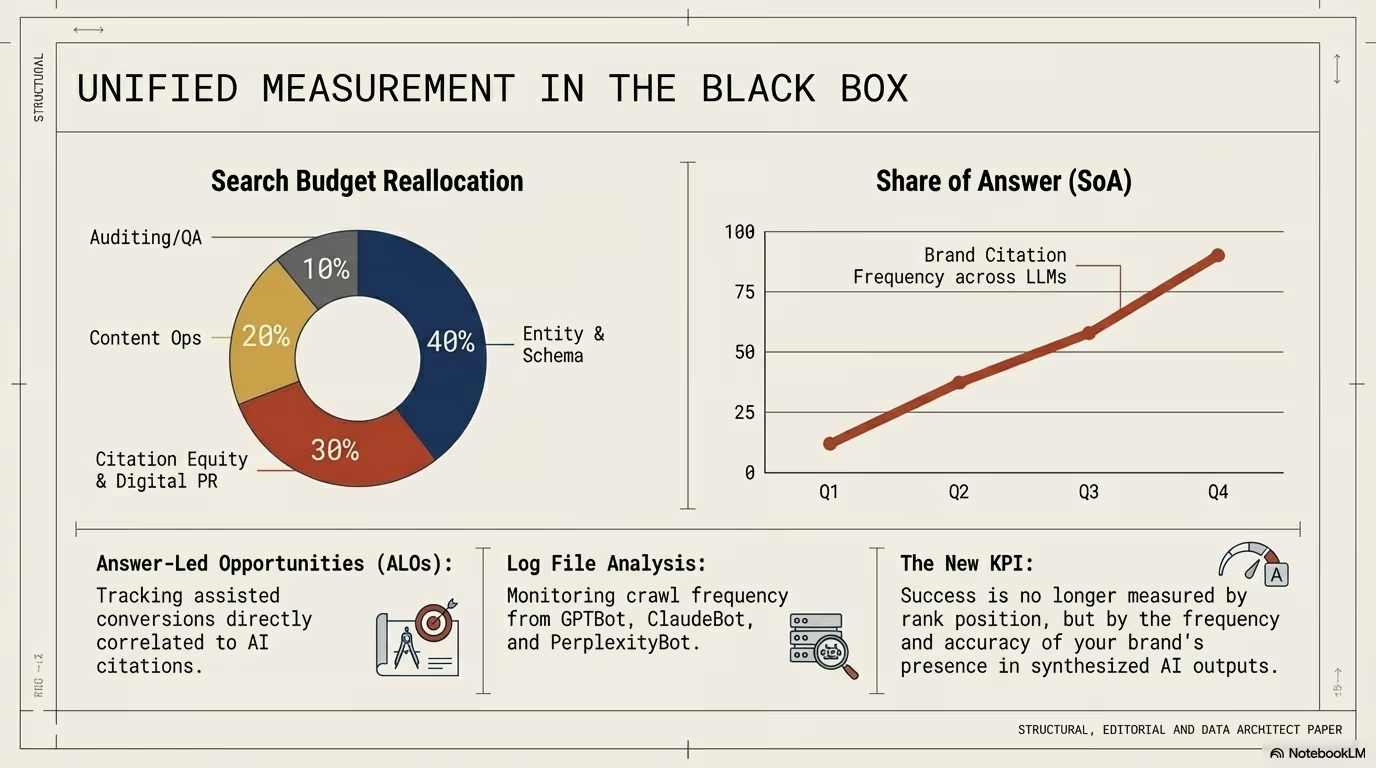
Zostaje pytanie, którego żadna z tych decyzji nie rozstrzyga. Jeśli użytkownik nigdy nie wejdzie na stronę, a mimo to dostanie od systemu odpowiedź opartą na twoim materiale i z twoją nazwą obok, to czy to jest wynik, za który ktoś w firmie odpowiada. Dziś zwykle nie jest, bo raport, który trafia na górę, ma kolumnę z sesjami. Póki jej nie ma, praca pod cytowanie będzie w każdej organizacji kosztem bez przypisanego zysku, a to jest najkrótsza droga do tego, żeby ją skreślić przy pierwszym cięciu budżetu.
Metryki, które to zmienią, zaczynają się pojawiać: częstotliwość cytowań na platformach AI, brzmienie wzmianek o marce w generowanych odpowiedziach, udział w odpowiedziach na kluczowe pytania. Żadna z nich nie jest jeszcze standardem i żadna nie ma uznanej metodologii, więc na razie każdy mierzy po swojemu. To akurat dobra wiadomość dla redakcji, która zacznie mierzyć wcześnie: będzie miała szereg czasowy wtedy, gdy reszta rynku dopiero ustali, co liczy.